ترجمة الكلام إلى الكلام في الوقت الفعلي: لماذا ليست جميع ترجمات الصوت "الفورية" متطابقة
Key Takeaways
- ترجمة الكلام إلى الكلام في الوقت الفعلي تعالج الصوت مباشرة دون الاعتماد على خطوات منفصلة من النسخ والترجمة والتركيب.
- الأنظمة التقليدية التي تستخدم STT → الترجمة → TTS قد تقدم تأخيراً أعلى لأن كل مرحلة تعتمد على مخرجات المرحلة السابقة.
- التأخير والسلاسة أكثر أهمية من دقة الترجمة وحدها في المحادثات المباشرة متعددة اللغات.
- يمكن لنماذج الذكاء الاصطناعي متعددة الأنماط الحديثة الوصول إلى المزيد من المعلومات من الصوت الأصلي من الأنظمة المبنية حول النص.
- Voicli تستخدم ترجمة الكلام إلى الكلام في الوقت الفعلي لتمكين المشاركين من التحدث بلغاتهم الخاصة بينما يتعامل النظام مع الترجمة بشكل سلس.
أصبحت ترجمة الصوت في الوقت الفعلي ميزة شائعة في منصات الاجتماعات وأدوات الاتصال وتطبيقات الذكاء الاصطناعي.
لكن هناك تفصيل مهم غالباً ما يكون مخفياً خلف كلمات "الترجمة الفورية."
قد يقول منتجان أنهما يترجمان الكلام في الوقت الفعلي بينما يستخدمان تقنيات مختلفة جداً في الأساس.
قد يعالج أحدهما المحادثة بهذه الطريقة:
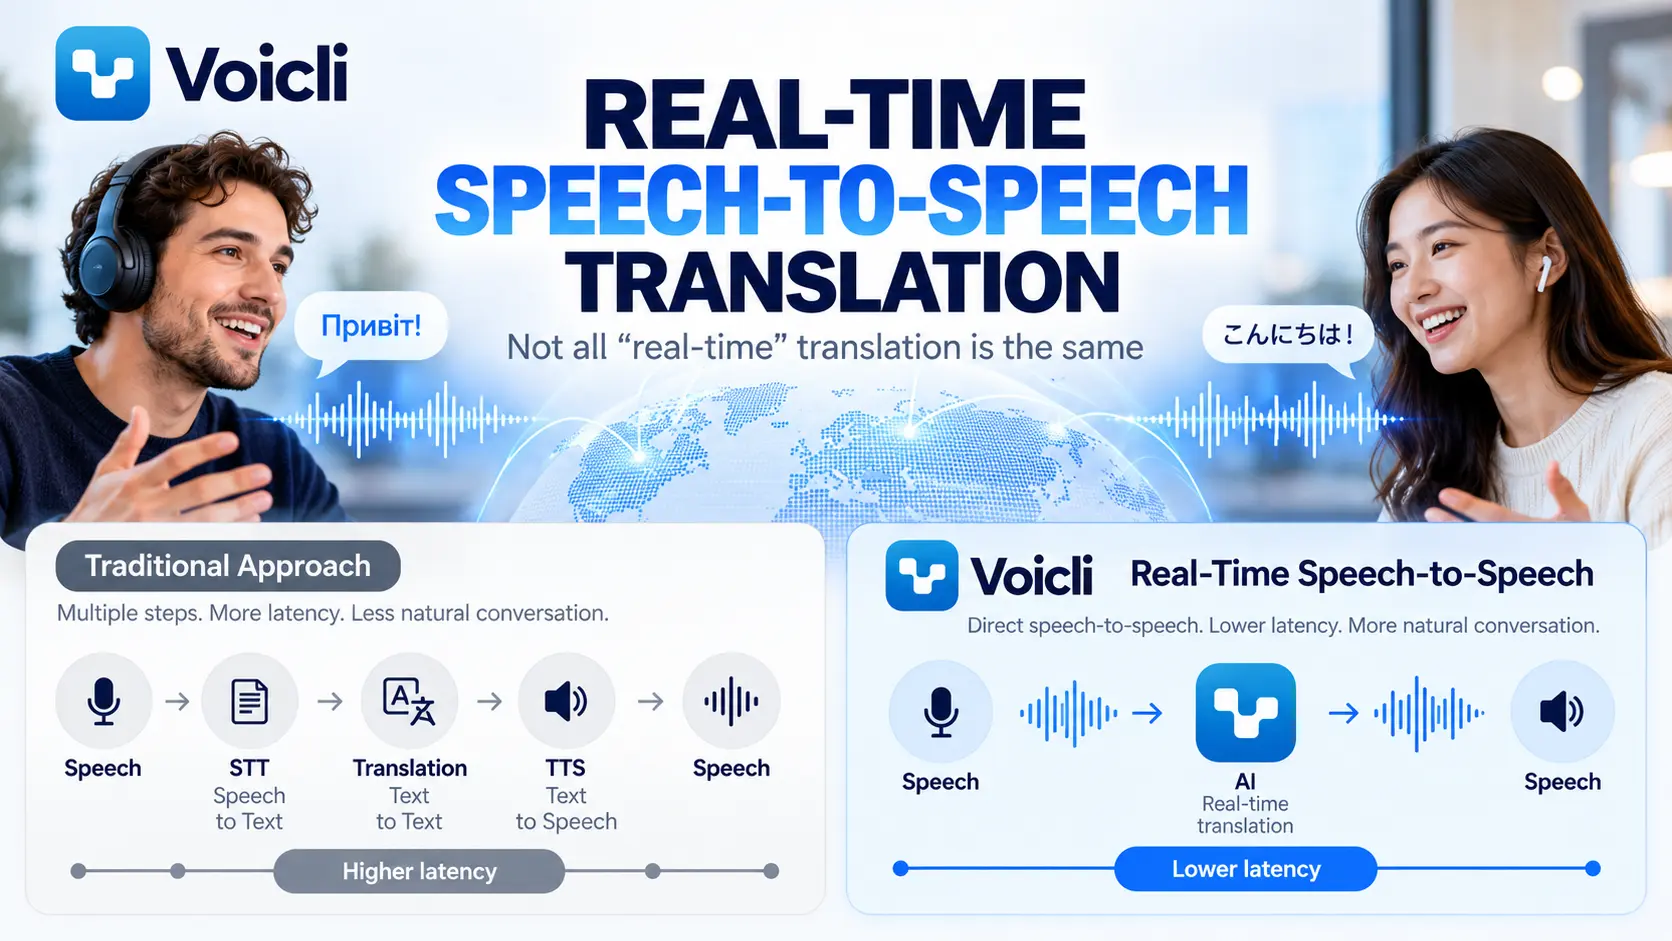
الكلام → النسخ → ترجمة النص → تحويل النص إلى كلام → الصوت المترجم
بينما يمكن لآخر أن يعالج التفاعل كتجربة كلام إلى كلام مستمرة، حيث يتم فهم الصوت وترجمته مباشرة ضمن نموذج متعدد الأنماط في الوقت الفعلي.
كلا النهجين يمكن أن ينتجا كلاماً مترجماً.
لكنهما لا ينتجان بالضرورة نفس تجربة المحادثة.
في Voicli، تم تصميم ترجمة الصوت المباشرة حول ترجمة الكلام إلى الكلام في الوقت الفعلي، مما يسمح للمشاركين بالتحدث بشكل طبيعي بلغاتهم الخاصة بينما يتم إنشاء كلام مترجم للأشخاص الذين يستمعون.
إذاً ما هي بالضبط ترجمة الكلام إلى الكلام، ولماذا تعتبر البنية المعمارية مهمة؟
ما هي ترجمة الكلام إلى الكلام في الوقت الفعلي؟
ترجمة الكلام إلى الكلام (S2ST) هي تقنية تستقبل اللغة المنطوقة وتنتج مخرجات منطوقة بلغة أخرى.
في نظام مباشر، تحدث هذه العملية بشكل مستمر بينما يجري الناس محادثة.
على سبيل المثال:
يتحدث شخص باللغة الأوكرانية.
يريد مشارك آخر أن يسمع باللغة الإنجليزية.
يستمع النظام إلى الكلام الأوكراني، ويفهم معناه، ويترجمه، وينشئ صوتاً إنجليزياً للمستمع.
الهدف ليس ببساطة ترجمة الكلمات.
الهدف هو جعل التواصل بين الأشخاص الذين يتحدثون لغات مختلفة يشعر بأنه قريب قدر الإمكان من محادثة عادية.
يصبح هذا التمييز مهماً عندما نقارن أنظمة الكلام إلى الكلام الحديثة مع خطوط أنابيب ترجمة الصوت التقليدية.
النهج التقليدي: STT → الترجمة → TTS
لسنوات عديدة، تم بناء أنظمة ترجمة الصوت من عدة تقنيات منفصلة.
تبدو البنية المعمارية عادة بهذا الشكل:
1. تحويل الكلام إلى نص (STT)
يتم تحويل صوت المتحدث إلى نص مكتوب.
↓
2. الترجمة الآلية (MT)
يتم ترجمة النص المكتوب إلى لغة أخرى.
↓
3. تحويل النص إلى كلام (TTS)
يتم تحويل النص المترجم إلى كلام اصطناعي.
يصبح خط الأنابيب الكامل:
الصوت → STT → النص → الترجمة → النص → TTS → الصوت
هذه البنية المعمارية تعمل.
في الواقع، لقد شغلت العديد من أنظمة ترجمة الكلام لسنوات.
كما أنها مفيدة عندما يكون الهدف الأساسي هو النسخ أو الترجمات أو ملاحظات الاجتماعات القابلة للبحث، أو الحالات التي يحتاج فيها المطورون إلى التحكم الكامل في كل مرحلة معالجة.
لكن المحادثة البشرية المباشرة تقدم متطلباً آخر:
السرعة.
لماذا قد تبدو خط أنابيب الترجمة المتسلسل بطيئاً
كل خطوة في خط أنابيب ترجمة الصوت التقليدي تستغرق وقتاً.
يحتاج نظام التعرف على الكلام إلى صوت كافٍ لفهم ما تم قوله.
ثم يعالج نظام الترجمة النص الناتج.
ثم ينشئ نظام تحويل النص إلى كلام تدفق صوتي جديد.
قد تكون كل مكون فردي سريعاً.
لكن تأخيراتها يمكن أن تتراكم.
هناك مشكلة أخرى.
تعتمد كل مرحلة على مخرجات المرحلة السابقة.
إذا أساء نظام التعرف على الكلام فهم كلمة، يتلقى نموذج الترجمة النص الخاطئ.
إذا غيرت الترجمة المعنى، فإن نظام تحويل النص إلى كلام ببساطة ينطق ذلك النص المترجم.
بعبارة أخرى، يمكن أن تنتشر الأخطاء عبر خط الأنابيب:
خطأ التعرف على الكلام → خطأ الترجمة → خطأ الكلام المترجم
أثناء ترجمة المستندات قد يكون هذا مقبولاً.
أثناء محادثة مباشرة، حتى بضع ثوان إضافية أو توقف محرج يمكن أن يغير تماماً كيفية شعور التواصل.
يتوقف الناس عن التحدث بشكل طبيعي.
ينتظرون.
يتحققون مما إذا كانت الترجمة قد انتهت.
ثم يرد الشخص الآخر.
بدلاً من محادثة، يبدأ التواصل بالشعور وكأنه تبادل الأدوار مع آلة.
ترجمة الكلام إلى الكلام الأصلية في الوقت الفعلي تغير البنية المعمارية
يمكن لنماذج الذكاء الاصطناعي متعددة الأنماط الحديثة أن تعمل مع إدخال الصوت وإخراج الصوت ضمن نفس التفاعل في الوقت الفعلي.
بدلاً من مطالبة المطورين بربط ثلاثة أنظمة مستقلة لكل عبارة منطوقة، يمكن لنموذج في الوقت الفعلي أن يعالج الصوت الوارد بشكل مستمر وينشئ مخرجات منطوقة.
من وجهة نظر المستخدم، يصبح التدفق أقرب بكثير إلى:
الكلام → فهم الذكاء الاصطناعي والترجمة → الكلام
يُشار إلى هذا عموماً باسم ترجمة الكلام إلى الكلام في الوقت الفعلي.
التمييز المهم ليس أن النص لا يمكن أن يكون موجوداً في أي مكان داخل نموذج الذكاء الاصطناعي.
قد تستخدم النماذج الحديثة تمثيلات داخلية عديدة.
الفرق معماري:
لا يتعين على المحادثة المباشرة أن تنتظر خدمة نسخ منفصلة، ثم خدمة ترجمة نص منفصلة، ثم خدمة تركيب كلام منفصلة قبل أن يتمكن الصوت المترجم من البدء.
هذا يجعل نوعاً مختلفاً جداً من التفاعل ممكناً.
"الفوري" لا يعني دائماً نفس الشيء
يُستخدم مصطلح الترجمة الفورية على نطاق واسع في الصناعة.
يمكن لمنتج أن يسمي نفسه فورياً من الناحية الفنية إذا أنتج ترجمة بعد بضع ثوان من تحدث شخص ما.
بالنسبة للترجمات، قد يكون هذا مقبولاً تماماً.
لكن المحادثة البشرية أكثر حساسية للتأخير.
فكر في تجربتين.
التجربة أ: الترجمة المتسلسلة
تتحدث.
ينتظر النظام صوتاً كافياً.
يصبح كلامك نصاً.
يتم ترجمة النص.
يتم إرسال النص المترجم إلى مولد صوت.
يسمع المشارك الآخر الترجمة.
ثم يردون.
التجربة ب: ترجمة الكلام إلى الكلام في الوقت الفعلي
تبدأ بالتحدث.
يعالج النموذج تدفق الصوت كجزء من جلسة مستمرة.
يفهم المحادثة الجارية ويبدأ في إنشاء كلام مترجم مع اعتماد أقل بكثير على مراحل المعالجة المنفصلة.
تصبح المحادثة أقرب إلى تبادل الأدوار الطبيعي.
يمكن وصف كلا النظامين من الناحية الفنية بأنهما "فوريان".
لكن التجربة يمكن أن تكون مختلفة جداً.
لماذا يعتبر التأخير أكثر أهمية من معظم معايير الترجمة
غالباً ما يتم تقييم منتجات الترجمة من خلال الدقة.
الدقة مهمة بوضوح.
لكن أثناء التواصل المباشر، هناك بُعد آخر مهم بنفس القدر:
تأخير المحادثة.
تخيل اجتماعاً تجارياً يضم ستة أشخاص يتحدثون عدة لغات.
إذا أدخلت كل جملة مترجمة عدة ثوان من الصمت، فإن هذه التأخيرات تتضاعف عبر الاجتماع.
يبدأ المشاركون في مقاطعة الترجمات.
يبدأ بعض الناس بالتحدث قبل انتهاء الترجمات السابقة.
يتوقف آخرون عن المشاركة لأن متابعة المحادثة تصبح صعبة.
قد تكون الترجمة نفسها صحيحة بينما تجربة الاجتماع لا تزال سيئة.
بالنسبة للتواصل متعدد اللغات المباشر، لا يمكن قياس جودة الترجمة فقط من خلال ما إذا كانت الكلمات صحيحة.
يجب أن تأخذ في الاعتبار أيضاً:
مدى سرعة بدء الكلام المترجم؛
كيف يمكن للمشاركين تبادل الأدوار بشكل طبيعي؛
ما إذا كان يمكن التعامل مع المقاطعات؛
ما إذا كان النظام يفهم السياق الحواري؛
ما إذا كان يحتاج المستخدمون إلى انتظار جمل كاملة؛
مدى جودة تدفق المحادثة عبر لغات متعددة.
هذا هو السبب في أن تقنية ترجمة الكلام إلى الكلام في الوقت الفعلي مهمة بشكل خاص للاجتماعات.
الكلام يحتوي على أكثر من مجرد كلمات
قيد آخر لتحويل الكلام إلى نص عادي هو أن الكلام البشري يحتوي على معلومات يصعب تمثيلها بالكامل في نسخة.
يتواصل الناس من خلال:
النبرة؛
الإيقاع؛
الفواصل؛
التركيز؛
التردد؛
سرعة الكلام؛
السياق الحواري.
تقوم أنظمة STT التقليدية أولاً بضغط الرسالة المنطوقة إلى نص.
قد تُفقد بعض المعلومات من الصوت الأصلي قبل أن تبدأ الترجمة حتى.
يمكن لنماذج الكلام إلى الكلام الحديثة أن تعمل مباشرة مع الصوت وتتمتع بإمكانية الوصول إلى المزيد من إشارة الكلام الأصلية.
هذا لا يعني أن كل تفصيل دقيق سيبقى دائماً بعد الترجمة.
لكنه يخلق إمكانية تفاعلات صوتية أكثر طبيعية بكثير من الأنظمة المبنية فقط حول النص.
ترجمة الكلام إلى الكلام مقابل ترجمة الكلام إلى النص
يتم الخلط بين هذه التقنيات أحياناً، لكنها تحل مشاكل مختلفة.
ترجمة الكلام إلى النص تحول اللغة المنطوقة إلى نص مترجم.
على سبيل المثال:
كلام ياباني → ترجمات إنجليزية
هذا مفيد جداً للتسميات التوضيحية وإمكانية الوصول.
ترجمة الكلام إلى الكلام تنتج صوتاً مترجماً:
كلام ياباني → كلام إنجليزي
هذا يسمح للمستمع بمتابعة المحادثة دون قراءة الترجمات باستمرار.
يدعم Voicli الترجمات المباشرة كجزء من تجربة الاجتماع، لكن ترجمة الصوت مصممة لشيء أوسع: السماح للناس بالفعل بالتحدث عبر اللغات، بدلاً من مجرد قراءة ترجمات ما قاله الآخرون.
لماذا يستخدم Voicli ترجمة الكلام إلى الكلام في الوقت الفعلي
تم بناء Voicli حول فكرة بسيطة:
يجب أن يتمكن الناس من الانضمام إلى نفس الاجتماع والتحدث باللغة التي يشعرون بالراحة فيها.
قد يتحدث أحد المشاركين باللغة الأوكرانية.
قد يتحدث آخر باللغة اليابانية.
قد يفضل آخر اللغة الإنجليزية.
قد يتحدث آخر اللغة الكورية.
بدلاً من إجبار الجميع على التبديل إلى لغة ثانية مشتركة، يتعامل Voicli مع الترجمة أثناء المحادثة.
يمكن لكل مشارك اختيار اللغة التي يريد سماعها.
يمكن للمنصة توفير صوت مترجم أو ترجمات أو الصوت الأصلي حسب تفضيل المستمع.
بالنسبة لترجمة الصوت المباشرة، يستخدم Voicli بنية معمارية لترجمة الكلام إلى الكلام في الوقت الفعلي بدلاً من الاعتماد حصرياً على:
STT → ترجمة النص → TTS
خط الأنابيب لكل عبارة مترجمة.
هذا الفرق المعماري مهم لأن Voicli لا يحاول بناء أداة نسخ تتحدث النص المترجم.
الهدف هو بناء طبقة اتصال متعددة اللغات للمحادثات الحقيقية.
عندما يكون STT + الترجمة + TTS لا يزال الحل الصحيح
لا تجعل تقنية الكلام إلى الكلام خطوط الأنابيب التقليدية عتيقة.
هناك العديد من الحالات التي يكون فيها STT → الترجمة → TTS مفيداً أو حتى مفضلاً.
على سبيل المثال:
نسخ الاجتماعات تحتاج إلى نص دقيق.
سجل المحادثات القابل للبحث يتطلب تمثيل نصي.
الترجمات تعتمد بشكل طبيعي على النسخ.
أنظمة الامتثال قد تحتاج إلى تخزين ما تم التعرف عليه بالضبط.
الترجمة غير المتزامنة لا تتطلب زمن انتقال منخفضاً جداً.
سير العمل المتخصص قد يحتاج المطورون إلى فحص وتعديل كل مرحلة وسيطة.
هذا هو السبب في أن Voicli يستخدم أيضاً تقنيات ذكاء اصطناعي مختلفة حسب المهمة.
المفتاح هو اختيار البنية المعمارية الصحيحة للتجربة التي يتم بناؤها.
بالنسبة للنسخة، النص هو المنتج.
بالنسبة لمحادثة متعددة اللغات مباشرة، المحادثة نفسها هي المنتج.
من أدوات الترجمة إلى المحادثات متعددة اللغات
لعقود من الزمن، كانت الترجمة الآلية تتعلق بشكل أساسي بتحويل المعلومات من لغة إلى أخرى.
أولاً المستندات.
ثم المواقع الإلكترونية.
ثم الرسائل.
ثم الترجمات.
تمثل ترجمة الكلام إلى الكلام في الوقت الفعلي اتجاهاً مختلفاً.
بدلاً من السؤال:
"كم بسرعة يمكننا ترجمة هذه الجملة؟"
يصبح السؤال الأكثر أهمية:
"هل يمكن لشخصين يتحدثان لغات مختلفة أن يتواصلا بشكل طبيعي؟"
هذا يغير كيفية تصميم أنظمة الترجمة.
يصبح التأخير حرجاً.
يصبح تبادل الأدوار حرجاً.
تصبح جودة الصوت حرجة.
يصبح السياق حرجاً.
وتصبح الترجمة جزءاً من البنية التحتية للاتصال بدلاً من أداة منفصلة يستخدمها الناس بوعي.
مستقبل الاجتماعات متعددة اللغات
الهدف طويل الأجل لترجمة الكلام ليس جعل الناس يفكرون في تقنية الترجمة بشكل متكرر.
إنه العكس.
يجب أن تختفي الترجمة تدريجياً في المحادثة.
تتحدث بلغتك.
يتحدث الشخص الآخر بلغته.
والتكنولوجيا تتعامل مع ما يحدث بينكما.
ستظل هناك تحديات.
اللهجات والضوضاء الخلفية والمصطلحات الخاصة بالمجال والمتحدثون المتداخلون والأسماء والسياق الثقافي يمكن أن تؤثر جميعها على ترجمة الذكاء الاصطناعي.
لكن نماذج متعددة الأنماط في الوقت الفعلي تغير ما هو ممكن من الناحية الفنية.
نحن ننتقل من:
التسجيل → النسخ → الترجمة → التركيب → الاستماع
نحو:
التحدث → الفهم → الترجمة → الاستماع
وفي النهاية، قد تكون أنجح تقنية ترجمة هي التقنية التي بالكاد يلاحظها المشاركون.
يجب أن تشعر الترجمة الفورية بأنها تواصل
تسمية منتج "فوري" أمر سهل.
جعل التواصل متعدد اللغات يشعر فعلاً بأنه فوري أصعب بكثير.
الفرق ليس فقط ميلي ثانية على معيار.
إنه ما إذا كان يمكن للناس التحدث بشكل طبيعي.
ما إذا كانوا يستطيعون الرد دون انتظار.
ما إذا كان اجتماع متعدد اللغات يشعر بأنه محادثة بدلاً من سلسلة من الرسائل المترجمة.
هذه هي المشكلة التي يعمل عليها Voicli.
ترجمة الكلام إلى الكلام في الوقت الفعلي للمحادثات حيث يمكن للجميع التحدث بلغتهم الخاصة.
الأسئلة الشائعة
ما هي ترجمة الكلام إلى الكلام؟
ترجمة الكلام إلى الكلام تحول اللغة المنطوقة مباشرة إلى مخرجات منطوقة بلغة أخرى. يمكن لأنظمة الذكاء الاصطناعي الحديثة معالجة إدخال الصوت وإنشاء صوت مترجم ضمن جلسة في الوقت الفعلي.
ما الفرق بين ترجمة الكلام إلى الكلام وترجمة الكلام إلى النص؟
ترجمة الكلام إلى النص تنتج نصاً مكتوباً مترجماً، مثل الترجمات. ترجمة الكلام إلى الكلام تنتج صوتاً مترجماً يمكن للمستمع سماعه.
كيف تعمل ترجمة الصوت التقليدية؟
تستخدم الأنظمة التقليدية عادة ثلاث مراحل: التعرف على الكلام إلى النص، والترجمة الآلية، وتركيب النص إلى الكلام. يُطلق على هذا غالباً بنية معمارية متسلسلة لترجمة الكلام.
لماذا قد يكون لـ STT → الترجمة → TTS تأخير أعلى؟
يجب على كل مرحلة معالجة المعلومات وتمرير مخرجاتها إلى المكون التالي. يمكن للوقت المعالجة المتراكم أن يقدم تأخيراً إضافياً، بينما يمكن لأخطاء مرحلة واحدة أن تؤثر أيضاً على المراحل اللاحقة.
هل ترجمة الكلام إلى الكلام هي نفس الترجمة الفورية المتزامنة؟
إنها مفاهيم مرتبطة لكن ليست متطابقة. الترجمة الفورية المتزامنة البشرية يتم تنفيذها بواسطة مترجمين فوريين محترفين. تحاول ترجمة الكلام إلى الكلام بالذكاء الاصطناعي توفير تجربة اتصال متعددة اللغات منخفضة التأخير مماثلة تلقائياً.
هل يمكن استخدام ترجمة الكلام إلى الكلام في الاجتماعات التجارية؟
نعم. ترجمة الكلام إلى الكلام في الوقت الفعلي مفيدة بشكل خاص للاجتماعات الدولية واستدعاءات العملاء والمحادثات البيعية والفرق البعيدة والمقابلات والحالات الأخرى حيث لا يشارك المشاركون نفس اللغة.
ماذا يفعل Voicli؟
Voicli هي منصة اتصال فيديو متعددة اللغات مع ترجمة صوت في الوقت الفعلي وترجمات مباشرة. يمكن للمشاركين التحدث بلغاتهم المفضلة بينما يتعامل Voicli مع الترجمة أثناء المحادثة.
جرب Voicli وتحدث بلغتك. دع الاجتماع يتعامل مع الترجمة.