Echtzeit-Sprache-zu-Sprache-Übersetzung: Warum nicht alle „Echtzeit"-Sprachübersetzungen gleich sind
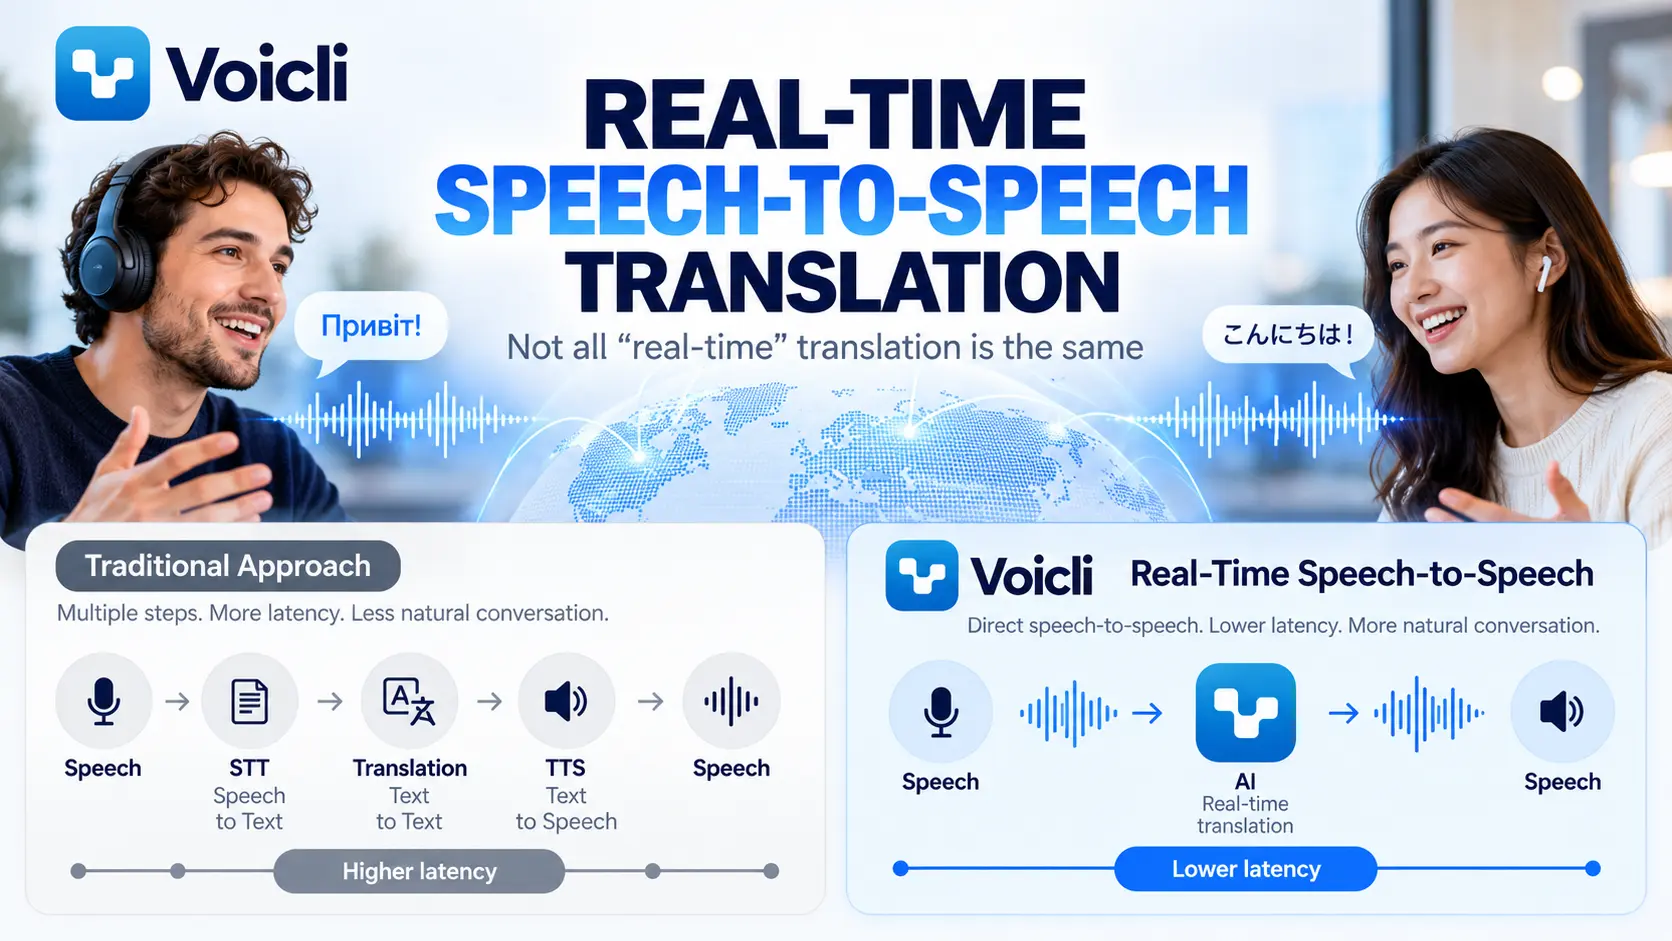
Echtzeit-Sprachübersetzung wird zu einer häufigen Funktion in Meeting-Plattformen, Kommunikationstools und KI-Anwendungen.
Aber es gibt ein wichtiges Detail, das oft hinter den Worten "Echtzeit-Übersetzung" verborgen ist.
Zwei Produkte können beide sagen, dass sie Sprache in Echtzeit übersetzen, während sie darunter sehr unterschiedliche Technologien verwenden.
Das eine kann ein Gespräch so verarbeiten:
Sprache → Transkription → Textübersetzung → Text-zu-Sprache → übersetzte Audio
Das andere kann die Interaktion als kontinuierliches Sprache-zu-Sprache-Erlebnis verarbeiten, bei dem Audio direkt innerhalb eines Echtzeit-Multimodal-Modells verstanden und übersetzt wird.
Beide Ansätze können übersetzte Sprache erzeugen.
Aber sie schaffen nicht unbedingt das gleiche Gesprächserlebnis.
Bei Voicli ist unsere Live-Sprachübersetzung um Echtzeit-Sprache-zu-Sprache-Übersetzung herum konzipiert, die es Teilnehmern ermöglicht, natürlich in ihren eigenen Sprachen zu sprechen, während übersetzte Sprache für die Zuhörer erzeugt wird.
Was genau ist also Sprache-zu-Sprache-Übersetzung, und warum ist die Architektur wichtig?
Was ist Echtzeit-Sprache-zu-Sprache-Übersetzung?
Sprache-zu-Sprache-Übersetzung (S2ST) ist eine Technologie, die gesprochene Sprache empfängt und gesprochene Ausgabe in einer anderen Sprache erzeugt.
In einem Live-System erfolgt dieser Prozess kontinuierlich, während Menschen ein Gespräch führen.
Zum Beispiel:
Eine Person spricht Ukrainisch.
Ein anderer Teilnehmer möchte Englisch hören.
Das System hört die ukrainische Sprache, versteht ihre Bedeutung, übersetzt sie und erzeugt englische Audio für den Zuhörer.
Das Ziel ist nicht einfach, Wörter zu übersetzen.
Das Ziel ist, die Kommunikation zwischen Menschen, die verschiedene Sprachen sprechen, so natürlich wie möglich zu gestalten.
Diese Unterscheidung wird wichtig, wenn wir moderne Sprache-zu-Sprache-Systeme mit traditionellen Sprachübersetzungs-Pipelines vergleichen.
Der traditionelle Ansatz: STT → Übersetzung → TTS
Seit vielen Jahren werden Sprachübersetzungssysteme aus mehreren separaten Technologien aufgebaut.
Die Architektur sieht normalerweise so aus:
1. Sprache-zu-Text (STT)
Die Audio des Sprechers wird in geschriebenen Text umgewandelt.
↓
2. Maschinenübersetzung (MT)
Der geschriebene Text wird in eine andere Sprache übersetzt.
↓
3. Text-zu-Sprache (TTS)
Der übersetzte Text wird zurück in künstliche Sprache umgewandelt.
Die vollständige Pipeline wird zu:
Audio → STT → Text → Übersetzung → Text → TTS → Audio
Diese Architektur funktioniert.
Tatsächlich hat sie viele Sprachübersetzungssysteme seit Jahren angetrieben.
Sie ist auch nützlich, wenn das Hauptziel Transkription, Untertitel, durchsuchbare Meeting-Notizen oder Situationen sind, in denen Entwickler vollständige Kontrolle über jede Verarbeitungsstufe benötigen.
Aber Live-Menschenkommunikation führt eine weitere Anforderung ein:
Geschwindigkeit.
Warum eine kaskadierende Übersetzungs-Pipeline langsam wirken kann
Jeder Schritt in einer traditionellen Sprachübersetzungs-Pipeline braucht Zeit.
Das Spracherkennungssystem benötigt genug Audio, um zu verstehen, was gesagt wurde.
Dann verarbeitet das Übersetzungssystem den resultierenden Text.
Dann erzeugt das Text-zu-Sprache-System einen neuen Audio-Stream.
Jede einzelne Komponente kann schnell sein.
Aber ihre Verzögerungen können sich ansammeln.
Es gibt noch ein anderes Problem.
Jede Stufe hängt von der Ausgabe der vorherigen Stufe ab.
Wenn die Spracherkennung ein Wort missversteht, erhält das Übersetzungsmodell den falschen Text.
Wenn die Übersetzung die Bedeutung ändert, spricht das TTS-System einfach diesen übersetzten Text.
Mit anderen Worten, Fehler können sich durch die Pipeline ausbreiten:
Spracherkennungsfehler → Übersetzungsfehler → gesprochener Übersetzungsfehler
Bei der Dokumentenübersetzung kann dies akzeptabel sein.
Während eines Live-Gesprächs können sogar ein paar zusätzliche Sekunden oder eine unbeholfene Pause völlig verändern, wie sich die Kommunikation anfühlt.
Menschen sprechen nicht mehr natürlich.
Sie warten.
Sie überprüfen, ob die Übersetzung beendet ist.
Dann antwortet die andere Person.
Statt eines Gesprächs beginnt die Kommunikation, sich wie ein Wechselspiel mit einer Maschine anzufühlen.
Native Echtzeit-Sprache-zu-Sprache ändert die Architektur
Moderne multimodale KI-Modelle können mit Audio-Eingabe und Audio-Ausgabe innerhalb der gleichen Echtzeit-Interaktion arbeiten.
Anstatt dass Entwickler für jeden gesprochenen Satz drei unabhängige Systeme verbinden müssen, kann ein Echtzeit-Modell kontinuierlich eingehende Audio verarbeiten und gesprochene Ausgabe erzeugen.
Aus der Perspektive des Benutzers wird der Ablauf viel näher an:
Sprache → KI-Verständnis und Übersetzung → Sprache
Dies wird allgemein als Echtzeit-Sprache-zu-Sprache-Übersetzung bezeichnet.
Die wichtige Unterscheidung ist nicht, dass Text niemals irgendwo innerhalb eines KI-Modells existieren kann.
Moderne Modelle können viele interne Darstellungen verwenden.
Der Unterschied ist architektonisch:
Das Live-Gespräch muss nicht auf einen separaten Transkriptionsdienst, dann einen separaten Textübersetzungsdienst und dann einen separaten Sprachsynthesedienst warten, bevor übersetzte Audio beginnen kann.
Das macht eine ganz andere Art von Interaktion möglich.
„Echtzeit" bedeutet nicht immer das Gleiche
Der Begriff Echtzeit-Übersetzung wird in der Branche breit verwendet.
Ein Produkt kann sich technisch als Echtzeit bezeichnen, wenn es eine Übersetzung ein paar Sekunden nach dem Sprechen erzeugt.
Für Untertitel kann das völlig akzeptabel sein.
Aber menschliches Gespräch ist viel empfindlicher gegenüber Verzögerung.
Betrachten Sie zwei Erfahrungen.
Erlebnis A: Kaskadierende Übersetzung
Sie sprechen.
Das System wartet auf genug Audio.
Ihre Sprache wird zu Text.
Der Text wird übersetzt.
Der übersetzte Text wird an einen Sprachgenerator gesendet.
Der andere Teilnehmer hört die Übersetzung.
Dann antworten sie.
Erlebnis B: Echtzeit-Sprache-zu-Sprache
Sie beginnen zu sprechen.
Das Modell verarbeitet den Audio-Stream als Teil einer kontinuierlichen Sitzung.
Es versteht das laufende Gespräch und beginnt, übersetzte Sprache mit deutlich weniger Abhängigkeit von separaten Verarbeitungsstufen zu erzeugen.
Das Gespräch wird näher an natürliches Wechselspiel.
Beide Systeme können technisch als „Echtzeit" beschrieben werden.
Aber das Erlebnis kann sehr unterschiedlich sein.
Warum Latenz wichtiger ist als die meisten Übersetzungs-Benchmarks
Übersetzungsprodukte werden oft nach Genauigkeit bewertet.
Genauigkeit ist offensichtlich wichtig.
Aber während der Live-Kommunikation gibt es eine andere gleich wichtige Dimension:
Gesprächslatenz.
Stellen Sie sich ein Geschäftsmeeting mit sechs Personen vor, die mehrere Sprachen sprechen.
Wenn jeder übersetzte Satz mehrere Sekunden Stille einführt, multiplizieren sich diese Verzögerungen über das Meeting.
Teilnehmer beginnen, Übersetzungen zu unterbrechen.
Einige Personen beginnen zu sprechen, bevor vorherige Übersetzungen beendet sind.
Andere hören auf zu partizipieren, weil das Folgen des Gesprächs schwierig wird.
Die Übersetzung selbst kann korrekt sein, während das Meeting-Erlebnis immer noch schlecht ist.
Für Live-Mehrsprachenkommunikation kann die Übersetzungsqualität daher nicht nur danach gemessen werden, ob die Wörter korrekt sind.
Sie sollte auch berücksichtigen:
wie schnell übersetzte Sprache beginnt;
wie natürlich Teilnehmer Wechsel nehmen können;
ob Unterbrechungen gehandhabt werden können;
ob das System Gesprächskontext versteht;
ob Benutzer auf vollständige Sätze warten müssen;
wie gut das Gespräch über mehrere Sprachen hinweg fließt.
Deshalb ist Echtzeit-Sprache-zu-Sprache-Technologie besonders wichtig für Meetings.
Sprache enthält mehr als Wörter
Eine weitere Einschränkung der Umwandlung von Sprache in reinen Text ist, dass menschliche Sprache Informationen enthält, die schwer vollständig in einer Transkription dargestellt werden können.
Menschen kommunizieren durch:
Ton;
Rhythmus;
Pausen;
Betonung;
Zögern;
Sprechgeschwindigkeit;
Gesprächskontext.
Traditionelle STT-Systeme komprimieren zunächst die gesprochene Nachricht in Text.
Einige Informationen aus der ursprünglichen Audio können daher verloren gehen, bevor die Übersetzung überhaupt beginnt.
Moderne Sprache-zu-Sprache-Modelle können direkt mit Audio arbeiten und haben Zugriff auf mehr des ursprünglichen Sprachsignals.
Das bedeutet nicht, dass jede Nuance die Übersetzung immer übersteht.
Aber es schafft die Möglichkeit von viel natürlicheren Sprachinteraktionen als Systeme, die nur um Text herum aufgebaut sind.
Sprache-zu-Sprache vs. Sprache-zu-Text-Übersetzung
Diese Technologien werden manchmal verwechselt, aber sie lösen unterschiedliche Probleme.
Sprache-zu-Text-Übersetzung konvertiert gesprochene Sprache in übersetzten Text.
Zum Beispiel:
Japanische Sprache → englische Untertitel
Dies ist äußerst nützlich für Bildunterschriften und Barrierefreiheit.
Sprache-zu-Sprache-Übersetzung erzeugt übersetzte Audio:
Japanische Sprache → englische Sprache
Dies ermöglicht es dem Zuhörer, dem Gespräch zu folgen, ohne ständig Untertitel zu lesen.
Voicli unterstützt Live-Untertitel als Teil des Meeting-Erlebnisses, aber Sprachübersetzung ist für etwas Breiteres konzipiert: Menschen die Möglichkeit zu geben, tatsächlich über Sprachen hinweg zu sprechen, anstatt einfach Übersetzungen dessen zu lesen, was andere gesagt haben.
Warum Voicli Echtzeit-Sprache-zu-Sprache-Übersetzung verwendet
Voicli wurde um eine einfache Idee herum aufgebaut:
Menschen sollten in das gleiche Meeting beitreten und die Sprache sprechen können, in der sie sich am wohlsten fühlen.
Ein Teilnehmer könnte Ukrainisch sprechen.
Ein anderer könnte Japanisch sprechen.
Ein anderer könnte Englisch bevorzugen.
Ein anderer könnte Koreanisch sprechen.
Anstatt alle zu zwingen, zu einer gemeinsamen Zweitsprache zu wechseln, handhabt Voicli die Übersetzung während des Gesprächs.
Jeder Teilnehmer kann die Sprache auswählen, die er hören möchte.
Die Plattform kann übersetzte Sprache, Untertitel oder die ursprüngliche Audio je nach Vorliebe des Zuhörers bereitstellen.
Für Live-Sprachübersetzung verwendet Voicli eine Echtzeit-Sprache-zu-Sprache-Architektur, anstatt sich ausschließlich auf die traditionelle zu verlassen:
STT → Textübersetzung → TTS
Pipeline für jeden übersetzten Äußerung.
Dieser architektonische Unterschied ist wichtig, weil Voicli nicht versucht, ein Transkriptionstool zu bauen, das zufällig übersetzten Text spricht.
Das Ziel ist, eine mehrsprachige Kommunikationsschicht für echte Gespräche zu bauen.
Wann STT + Übersetzung + TTS immer noch die richtige Lösung ist
Sprache-zu-Sprache-Technologie macht traditionelle Pipelines nicht obsolet.
Es gibt viele Situationen, in denen STT → Übersetzung → TTS nützlich oder sogar vorzuziehen ist.
Zum Beispiel:
Meeting-Transkripte benötigen genauen Text.
Durchsuchbare Gesprächsverlauf erfordert Textdarstellung.
Untertitel hängen natürlich von Transkription ab.
Compliance-Systeme müssen möglicherweise genau speichern, was erkannt wurde.
Asynchrone Übersetzung erfordert keine extrem niedrige Latenz.
Spezialisierte Workflows können Entwickler benötigen, um jede Zwischenstufe zu inspizieren und zu ändern.
Deshalb verwendet Voicli auch unterschiedliche KI-Technologien je nach Aufgabe.
Der Schlüssel ist, die richtige Architektur für das Erlebnis zu wählen, das gebaut wird.
Für eine Transkription ist Text das Produkt.
Für ein Live-Mehrsprachengespräch ist das Gespräch selbst das Produkt.
Von Übersetzungstools zu mehrsprachigen Gesprächen
Seit Jahrzehnten geht es bei maschineller Übersetzung hauptsächlich darum, Informationen von einer Sprache in eine andere zu konvertieren.
Zuerst Dokumente.
Dann Websites.
Dann Nachrichten.
Dann Untertitel.
Echtzeit-Sprache-zu-Sprache-Übersetzung stellt eine andere Richtung dar.
Anstatt zu fragen:
„Wie schnell können wir diesen Satz übersetzen?"
wird die wichtigere Frage:
„Können zwei Menschen, die verschiedene Sprachen sprechen, natürlich kommunizieren?"
Das ändert, wie Übersetzungssysteme konzipiert werden müssen.
Latenz wird kritisch.
Wechselspiel wird kritisch.
Audioqualität wird kritisch.
Kontext wird kritisch.
Und Übersetzung wird Teil der Kommunikationsinfrastruktur, anstatt ein separates Tool, das Menschen bewusst verwenden.
Die Zukunft mehrsprachiger Meetings
Das langfristige Ziel der Sprachübersetzung ist nicht, dass Menschen öfter über Übersetzungstechnologie nachdenken.
Es ist das Gegenteil.
Übersetzung sollte allmählich in das Gespräch verschwinden.
Sie sprechen Ihre Sprache.
Die andere Person spricht ihre.
Und die Technologie handhabt, was zwischen Ihnen passiert.
Es wird immer noch Herausforderungen geben.
Akzente, Hintergrundgeräusche, fachspezifische Terminologie, überlappende Sprecher, Namen und kultureller Kontext können alle die KI-Übersetzung beeinflussen.
Aber Echtzeit-Multimodal-Modelle ändern, was technisch möglich ist.
Wir bewegen uns von:
aufnehmen → transkribieren → übersetzen → synthetisieren → hören
hin zu:
sprechen → verstehen → übersetzen → hören
Und schließlich kann die erfolgreichste Übersetzungstechnologie die Technologie sein, die Teilnehmer kaum bemerken.
Echtzeit-Übersetzung sollte sich wie Kommunikation anfühlen
Ein Produkt „Echtzeit" zu nennen ist einfach.
Mehrsprachenkommunikation tatsächlich Echtzeit-Gefühl zu geben ist viel schwieriger.
Der Unterschied ist nicht nur Millisekunden auf einem Benchmark.
Es ist, ob Menschen natürlich sprechen können.
Ob sie antworten können, ohne zu warten.
Ob sich ein mehrsprachiges Meeting wie ein Gespräch anfühlt, anstatt wie eine Abfolge von übersetzten Nachrichten.
Das ist das Problem, an dem Voicli arbeitet.
Echtzeit-Sprache-zu-Sprache-Übersetzung für Gespräche, in denen jeder seine eigene Sprache sprechen kann.
Häufig gestellte Fragen
Was ist Sprache-zu-Sprache-Übersetzung?
Sprache-zu-Sprache-Übersetzung konvertiert gesprochene Sprache direkt in gesprochene Ausgabe in einer anderen Sprache. Moderne KI-Systeme können Audio-Eingabe verarbeiten und übersetzte Audio innerhalb einer Echtzeit-Sitzung erzeugen.
Was ist der Unterschied zwischen Sprache-zu-Sprache- und Sprache-zu-Text-Übersetzung?
Sprache-zu-Text-Übersetzung erzeugt übersetzten geschriebenen Text, wie Untertitel. Sprache-zu-Sprache-Übersetzung erzeugt übersetzte Audio, die der Zuhörer hören kann.
Wie funktioniert traditionelle Sprachübersetzung?
Traditionelle Systeme verwenden häufig drei Stufen: Sprache-zu-Text-Erkennung, Maschinenübersetzung und Text-zu-Sprache-Synthese. Dies wird oft als kaskadierende Sprachübersetzungsarchitektur bezeichnet.
Warum kann STT → Übersetzung → TTS höhere Latenz haben?
Jede Stufe muss Informationen verarbeiten und ihre Ausgabe an die nächste Komponente weitergeben. Die akkumulierte Verarbeitungszeit kann zusätzliche Verzögerung einführen, während Fehler aus einer Stufe auch nachfolgende Stufen beeinflussen können.
Ist Sprache-zu-Sprache-Übersetzung das Gleiche wie simultane Interpretation?
Sie sind verwandte Konzepte, aber nicht identisch. Menschliche simultane Interpretation wird von professionellen Dolmetschern durchgeführt. KI-Sprache-zu-Sprache-Übersetzung versucht, ein ähnliches niedriger-Latenz-Mehrsprachenkommunikationserlebnis automatisch bereitzustellen.
Kann Sprache-zu-Sprache-Übersetzung für Geschäftsmeetings verwendet werden?
Ja. Echtzeit-Sprache-zu-Sprache-Übersetzung ist besonders nützlich für internationale Meetings, Kundenanrufe, Verkaufsgespräche, Remote-Teams, Interviews und andere Situationen, in denen Teilnehmer nicht die gleiche Sprache teilen.
Was macht Voicli?
Voicli ist eine mehrsprachige Videokommunikationsplattform mit Echtzeit-Sprachübersetzung und Live-Untertiteln. Teilnehmer können ihre bevorzugten Sprachen sprechen, während Voicli die Übersetzung während des Gesprächs handhabt.
Probieren Sie Voicli aus und sprechen Sie Ihre Sprache. Lassen Sie das Meeting die Übersetzung handeln.