Traducción de voz en tiempo real de voz a voz: Por qué no toda la traducción de voz "en tiempo real" es igual
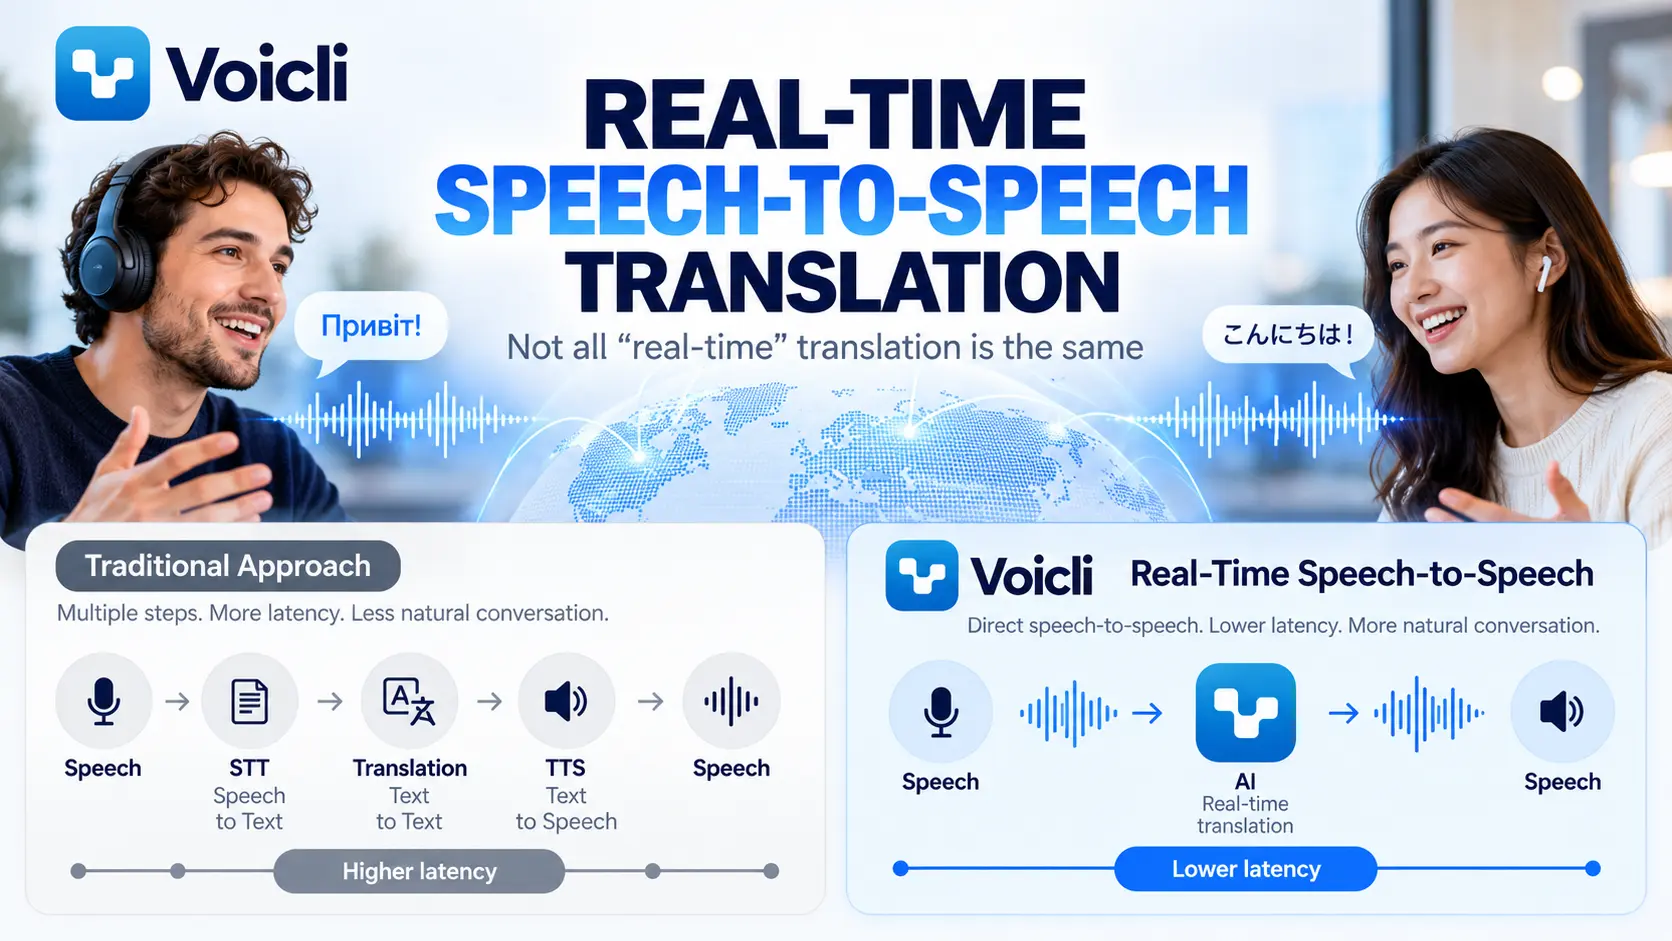
La traducción de voz en tiempo real se está convirtiendo en una característica común en plataformas de reuniones, herramientas de comunicación y aplicaciones de IA.
Pero hay un detalle importante que a menudo se oculta detrás de las palabras "traducción en tiempo real."
Dos productos pueden decir que traducen voz en tiempo real mientras utilizan tecnologías muy diferentes por debajo.
Uno puede procesar una conversación así:
Voz → transcripción → traducción de texto → síntesis de voz → audio traducido
Otro puede procesar la interacción como una experiencia continua de voz a voz, donde el audio se entiende y se traduce directamente dentro de un modelo multimodal en tiempo real.
Ambos enfoques pueden producir voz traducida.
Pero no necesariamente crean la misma experiencia de conversación.
En Voicli, nuestra traducción de voz en vivo está diseñada alrededor de la traducción de voz a voz en tiempo real, permitiendo que los participantes hablen naturalmente en sus propios idiomas mientras se genera voz traducida para las personas que escuchan.
Entonces, ¿qué es exactamente la traducción de voz a voz y por qué importa la arquitectura?
¿Qué es la traducción de voz a voz en tiempo real?
La traducción de voz a voz (S2ST) es una tecnología que recibe lenguaje hablado y produce salida hablada en otro idioma.
En un sistema en vivo, este proceso ocurre continuamente mientras las personas tienen una conversación.
Por ejemplo:
Una persona habla ucraniano.
Otro participante quiere escuchar en inglés.
El sistema escucha el habla en ucraniano, entiende su significado, lo traduce y genera audio en inglés para el oyente.
El objetivo no es simplemente traducir palabras.
El objetivo es hacer que la comunicación entre personas que hablan diferentes idiomas se sienta lo más cercana posible a una conversación normal.
Esta distinción se vuelve importante cuando comparamos sistemas modernos de voz a voz con canalizaciones tradicionales de traducción de voz.
El enfoque tradicional: STT → Traducción → TTS
Durante muchos años, los sistemas de traducción de voz se han construido a partir de varias tecnologías separadas.
La arquitectura generalmente se ve así:
1. Voz a texto (STT)
El audio del hablante se convierte en texto escrito.
↓
2. Traducción automática (MT)
El texto escrito se traduce a otro idioma.
↓
3. Síntesis de voz (TTS)
El texto traducido se convierte nuevamente en voz artificial.
La canalización completa se convierte en:
Audio → STT → Texto → Traducción → Texto → TTS → Audio
Esta arquitectura funciona.
De hecho, ha impulsado muchos sistemas de traducción de voz durante años.
También es útil cuando el objetivo principal es la transcripción, subtítulos, notas de reunión buscables, o situaciones donde los desarrolladores necesitan control completo sobre cada etapa de procesamiento.
Pero la conversación humana en vivo introduce otro requisito:
velocidad.
Por qué una canalización de traducción en cascada puede parecer lenta
Cada paso en una canalización tradicional de traducción de voz toma tiempo.
El sistema de reconocimiento de voz necesita suficiente audio para entender lo que se dijo.
Luego el sistema de traducción procesa el texto resultante.
Luego el sistema de síntesis de voz genera un nuevo flujo de audio.
Cada componente individual puede ser rápido.
Pero sus retrasos pueden acumularse.
Hay otro problema.
Cada etapa depende de la salida de la etapa anterior.
Si el reconocimiento de voz malinterpreta una palabra, el modelo de traducción recibe el texto incorrecto.
Si la traducción cambia el significado, el sistema TTS simplemente pronuncia ese texto traducido.
En otras palabras, los errores pueden propagarse a través de la canalización:
Error de reconocimiento de voz → error de traducción → error de voz traducida
Durante la traducción de documentos esto puede ser aceptable.
Durante una conversación en vivo, incluso unos pocos segundos adicionales o una pausa incómoda pueden cambiar completamente cómo se siente la comunicación.
Las personas dejan de hablar naturalmente.
Esperan.
Comprueban si la traducción ha terminado.
Luego la otra persona responde.
En lugar de una conversación, la comunicación comienza a parecer como turnarse con una máquina.
La traducción de voz a voz nativa en tiempo real cambia la arquitectura
Los modelos modernos de IA multimodal pueden trabajar con entrada de audio y salida de audio dentro de la misma interacción en tiempo real.
En lugar de requerir que los desarrolladores conecten tres sistemas independientes para cada frase hablada, un modelo en tiempo real puede procesar continuamente el audio entrante y generar salida hablada.
Desde la perspectiva del usuario, el flujo se vuelve mucho más cercano a:
Voz → Comprensión y traducción de IA → Voz
Esto se conoce generalmente como traducción de voz a voz en tiempo real.
La distinción importante no es que el texto nunca pueda existir en ningún lugar dentro de un modelo de IA.
Los modelos modernos pueden usar muchas representaciones internas.
La diferencia es arquitectónica:
La conversación en vivo no tiene que esperar a un servicio de transcripción separado, luego a un servicio de traducción de texto separado, y luego a un servicio de síntesis de voz separado antes de que pueda comenzar el audio traducido.
Eso hace posible un tipo de interacción muy diferente.
"En tiempo real" no siempre significa lo mismo
El término traducción en tiempo real se usa ampliamente en toda la industria.
Un producto puede técnicamente llamarse en tiempo real si genera una traducción unos segundos después de que alguien hable.
Para subtítulos, eso puede ser perfectamente aceptable.
Pero la conversación humana es mucho más sensible al retraso.
Considera dos experiencias.
Experiencia A: Traducción en cascada
Hablas.
El sistema espera suficiente audio.
Tu voz se convierte en texto.
El texto se traduce.
El texto traducido se envía a un generador de voz.
El otro participante escucha la traducción.
Luego responden.
Experiencia B: Voz a voz en tiempo real
Comienzas a hablar.
El modelo procesa el flujo de audio como parte de una sesión continua.
Entiende la conversación en curso y comienza a generar voz traducida con una dependencia significativamente menor de etapas de procesamiento separadas.
La conversación se vuelve más cercana a los turnos naturales.
Ambos sistemas pueden describirse técnicamente como "en tiempo real".
Pero la experiencia puede ser muy diferente.
Por qué la latencia importa más que la mayoría de los puntos de referencia de traducción
Los productos de traducción a menudo se evalúan por precisión.
La precisión es obviamente importante.
Pero durante la comunicación en vivo hay otra dimensión igualmente importante:
latencia de conversación.
Imagina una reunión de negocios con seis personas hablando varios idiomas.
Si cada oración traducida introduce varios segundos de silencio, esos retrasos se multiplican en toda la reunión.
Los participantes comienzan a interrumpir las traducciones.
Algunas personas comienzan a hablar antes de que las traducciones anteriores hayan terminado.
Otros dejan de participar porque seguir la conversación se vuelve difícil.
La traducción en sí puede ser correcta mientras que la experiencia de la reunión sigue siendo pobre.
Para la comunicación multilingüe en vivo, la calidad de la traducción por lo tanto no puede medirse solo por si las palabras son correctas.
También debe considerar:
qué tan rápido comienza la voz traducida;
qué tan naturalmente pueden los participantes turnarse;
si se pueden manejar las interrupciones;
si el sistema entiende el contexto conversacional;
si los usuarios necesitan esperar oraciones completas;
qué tan bien fluye la conversación entre múltiples idiomas.
Por eso la tecnología de voz a voz en tiempo real es especialmente importante para las reuniones.
La voz contiene más que palabras
Otra limitación de convertir la voz en texto plano es que el habla humana contiene información que es difícil de representar completamente en una transcripción.
Las personas se comunican a través de:
tono;
ritmo;
pausas;
énfasis;
vacilación;
velocidad del habla;
contexto conversacional.
Los sistemas STT tradicionales primero comprimen el mensaje hablado en texto.
Parte de la información del audio original puede perderse antes de que la traducción comience.
Los modelos modernos de voz a voz pueden trabajar directamente con audio y tienen acceso a más de la señal de voz original.
Esto no significa que cada matiz siempre sobrevivirá a la traducción.
Pero crea la posibilidad de interacciones de voz mucho más naturales que los sistemas construidos solo alrededor de texto.
Voz a voz vs traducción de voz a texto
Estas tecnologías a veces se confunden, pero resuelven problemas diferentes.
La traducción de voz a texto convierte el lenguaje hablado en texto traducido.
Por ejemplo:
Voz en japonés → Subtítulos en inglés
Esto es extremadamente útil para subtítulos y accesibilidad.
La traducción de voz a voz produce audio traducido:
Voz en japonés → Voz en inglés
Esto permite al oyente seguir la conversación sin estar constantemente leyendo subtítulos.
Voicli admite subtítulos en vivo como parte de la experiencia de reunión, pero la traducción de voz está diseñada para algo más amplio: permitir que las personas realmente hablen entre idiomas, en lugar de simplemente leer traducciones de lo que otros dijeron.
Por qué Voicli usa traducción de voz a voz en tiempo real
Voicli fue construido alrededor de una idea simple:
Las personas deberían poder unirse a la misma reunión y hablar el idioma en el que se sienten más cómodas.
Un participante podría hablar ucraniano.
Otro podría hablar japonés.
Otro podría preferir inglés.
Otro podría hablar coreano.
En lugar de obligar a todos a cambiar a un idioma segundo común, Voicli maneja la traducción durante la conversación.
Cada participante puede seleccionar el idioma que desea escuchar.
La plataforma puede proporcionar voz traducida, subtítulos, o el audio original dependiendo de la preferencia del oyente.
Para la traducción de voz en vivo, Voicli utiliza una arquitectura de voz a voz en tiempo real en lugar de depender exclusivamente de la tradicional:
STT → traducción de texto → TTS
canalización para cada enunciado traducido.
Esa diferencia arquitectónica es importante porque Voicli no está intentando construir una herramienta de transcripción que simplemente hable texto traducido.
El objetivo es construir una capa de comunicación multilingüe para conversaciones reales.
Cuándo STT + Traducción + TTS sigue siendo la solución correcta
La tecnología de voz a voz no hace que las canalizaciones tradicionales sean obsoletas.
Hay muchas situaciones donde STT → traducción → TTS es útil o incluso preferible.
Por ejemplo:
Las transcripciones de reuniones necesitan texto preciso.
El historial de conversación buscable requiere representación de texto.
Los subtítulos dependen naturalmente de la transcripción.
Los sistemas de cumplimiento pueden necesitar almacenar exactamente lo que se reconoció.
La traducción asincrónica no requiere latencia extremadamente baja.
Los flujos de trabajo especializados pueden necesitar que los desarrolladores inspeccionen y modifiquen cada etapa intermedia.
Por eso Voicli también utiliza diferentes tecnologías de IA dependiendo de la tarea.
La clave es elegir la arquitectura correcta para la experiencia que se está construyendo.
Para una transcripción, el texto es el producto.
Para una conversación multilingüe en vivo, la conversación en sí es el producto.
De herramientas de traducción a conversaciones multilingües
Durante décadas, la traducción automática ha sido principalmente sobre convertir información de un idioma a otro.
Primero documentos.
Luego sitios web.
Luego mensajes.
Luego subtítulos.
La traducción de voz a voz en tiempo real representa una dirección diferente.
En lugar de preguntar:
"¿Qué tan rápido podemos traducir esta oración?"
la pregunta más importante se convierte en:
"¿Pueden dos personas que hablan diferentes idiomas comunicarse naturalmente?"
Eso cambia cómo necesitan diseñarse los sistemas de traducción.
La latencia se vuelve crítica.
Los turnos se vuelven críticos.
La calidad del audio se vuelve crítica.
El contexto se vuelve crítico.
Y la traducción se convierte en parte de la infraestructura de comunicación en lugar de una herramienta separada que las personas usan conscientemente.
El futuro de las reuniones multilingües
El objetivo a largo plazo de la traducción de voz no es hacer que las personas piensen en la tecnología de traducción más a menudo.
Es lo opuesto.
La traducción debería desaparecer gradualmente en la conversación.
Hablas tu idioma.
La otra persona habla el suyo.
Y la tecnología maneja lo que sucede entre ustedes.
Todavía habrá desafíos.
Los acentos, el ruido de fondo, la terminología específica del dominio, los hablantes superpuestos, los nombres y el contexto cultural pueden afectar la traducción de IA.
Pero los modelos multimodales en tiempo real están cambiando lo que es técnicamente posible.
Nos estamos moviendo de:
grabar → transcribir → traducir → sintetizar → escuchar
hacia:
hablar → entender → traducir → escuchar
Y eventualmente, la tecnología de traducción más exitosa puede ser la tecnología que los participantes apenas notan.
La traducción en tiempo real debería parecer comunicación
Llamar a un producto "en tiempo real" es fácil.
Hacer que la comunicación multilingüe realmente se sienta en tiempo real es mucho más difícil.
La diferencia no es solo milisegundos en un punto de referencia.
Es si las personas pueden hablar naturalmente.
Si pueden responder sin esperar.
Si una reunión multilingüe se siente como una conversación en lugar de una secuencia de mensajes traducidos.
Ese es el problema en el que Voicli está trabajando.
Preguntas frecuentes
¿Qué es la traducción de voz a voz?
¿Cuál es la diferencia entre traducción de voz a voz y traducción de voz a texto?
¿Cómo funciona la traducción de voz tradicional?
¿Por qué STT → traducción → TTS puede tener mayor latencia?
¿Es la traducción de voz a voz lo mismo que la interpretación simultánea?
¿Se puede usar la traducción de voz a voz para reuniones de negocios?
¿Qué hace Voicli?
Prueba Voicli y habla tu idioma. Deja que la reunión maneje la traducción.