Traduction vocale en temps réel : Pourquoi toute traduction vocale « en temps réel » n'est pas identique
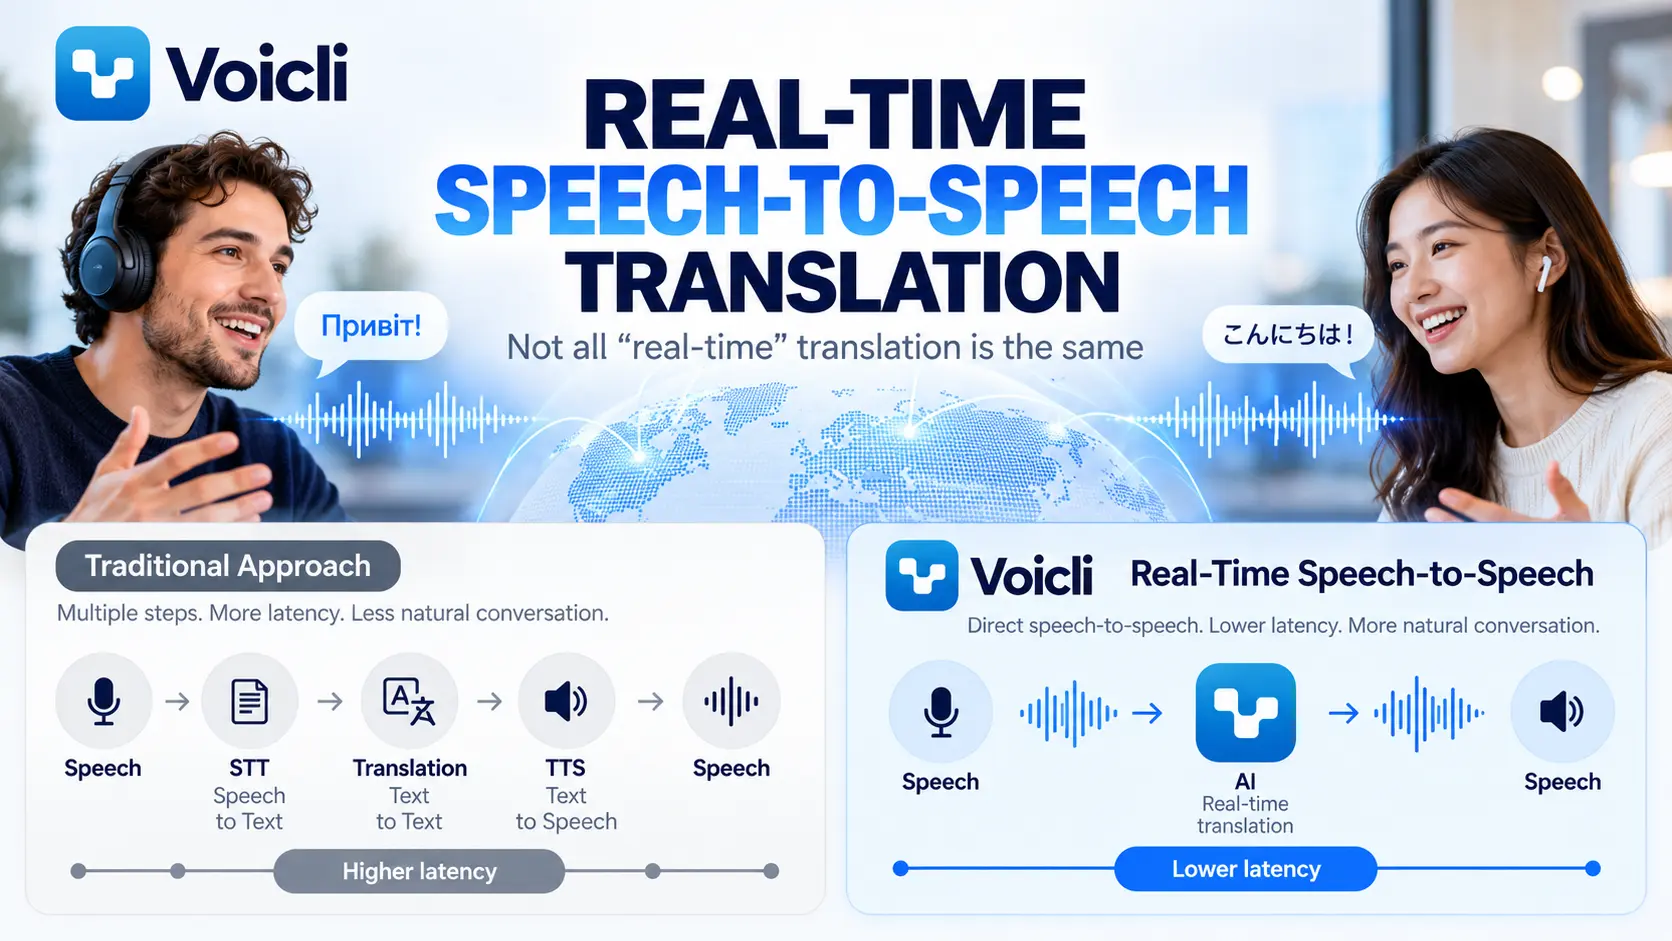
La traduction vocale en temps réel devient une fonctionnalité courante dans les plateformes de réunion, les outils de communication et les applications d'IA.
Mais il y a un détail important qui est souvent caché derrière les mots « traduction en temps réel ».
Deux produits peuvent tous deux affirmer qu'ils traduisent la parole en temps réel tout en utilisant des technologies très différentes en arrière-plan.
L'un peut traiter une conversation comme ceci :
Parole → transcription → traduction de texte → synthèse vocale → audio traduit
Un autre peut traiter l'interaction comme une expérience continue de traduction vocale, où l'audio est compris et traduit directement dans un modèle multimodal en temps réel.
Les deux approches peuvent produire de la parole traduite.
Mais elles ne créent pas nécessairement la même expérience de conversation.
Chez Voicli, notre traduction vocale en direct est conçue autour de la traduction vocale en temps réel, permettant aux participants de parler naturellement dans leurs propres langues tandis que la parole traduite est générée pour les personnes qui écoutent.
Alors, qu'est-ce que la traduction vocale exactement, et pourquoi l'architecture est-elle importante ?
Qu'est-ce que la traduction vocale en temps réel ?
La traduction vocale (S2ST) est une technologie qui reçoit la langue parlée et produit une sortie parlée dans une autre langue.
Dans un système en direct, ce processus se déroule continuellement pendant que les gens ont une conversation.
Par exemple :
Une personne parle l'ukrainien.
Un autre participant souhaite entendre l'anglais.
Le système écoute la parole ukrainienne, comprend son sens, la traduit et génère de l'audio en anglais pour l'auditeur.
L'objectif n'est pas simplement de traduire des mots.
L'objectif est de rendre la communication entre des personnes parlant des langues différentes aussi proche que possible d'une conversation normale.
Cette distinction devient importante lorsque nous comparons les systèmes modernes de traduction vocale avec les pipelines traditionnels de traduction vocale.
L'approche traditionnelle : STT → Traduction → TTS
Pendant de nombreuses années, les systèmes de traduction vocale ont été construits à partir de plusieurs technologies distinctes.
L'architecture ressemble généralement à ceci :
1. Reconnaissance vocale (STT)
L'audio du locuteur est converti en texte écrit.
↓
2. Traduction automatique (MT)
Le texte écrit est traduit dans une autre langue.
↓
3. Synthèse vocale (TTS)
Le texte traduit est reconverti en parole artificielle.
Le pipeline complet devient :
Audio → STT → Texte → Traduction → Texte → TTS → Audio
Cette architecture fonctionne.
En fait, elle a alimenté de nombreux systèmes de traduction vocale pendant des années.
Elle est également utile lorsque l'objectif principal est la transcription, les sous-titres, les notes de réunion consultables, ou les situations où les développeurs ont besoin d'un contrôle complet sur chaque étape du traitement.
Mais la conversation humaine en direct introduit une autre exigence :
la vitesse.
Pourquoi un pipeline de traduction en cascade peut sembler lent
Chaque étape d'un pipeline de traduction vocale traditionnel prend du temps.
Le système de reconnaissance vocale a besoin de suffisamment d'audio pour comprendre ce qui a été dit.
Ensuite, le système de traduction traite le texte résultant.
Ensuite, le système de synthèse vocale génère un nouveau flux audio.
Chaque composant individuel peut être rapide.
Mais leurs délais peuvent s'accumuler.
Il y a un autre problème.
Chaque étape dépend de la sortie de l'étape précédente.
Si la reconnaissance vocale mal comprend un mot, le modèle de traduction reçoit le mauvais texte.
Si la traduction change le sens, le système TTS parle simplement ce texte traduit.
En d'autres termes, les erreurs peuvent se propager dans le pipeline :
Erreur de reconnaissance vocale → erreur de traduction → erreur de traduction parlée
Lors de la traduction de documents, cela peut être acceptable.
Lors d'une conversation en direct, même quelques secondes supplémentaires ou une pause maladroite peuvent complètement changer la façon dont la communication se sent.
Les gens cessent de parler naturellement.
Ils attendent.
Ils vérifient si la traduction est terminée.
Ensuite, l'autre personne répond.
Au lieu d'une conversation, la communication commence à ressembler à prendre des tours avec une machine.
La traduction vocale native en temps réel change l'architecture
Les modèles d'IA multimodaux modernes peuvent fonctionner avec une entrée audio et une sortie audio dans la même interaction en temps réel.
Au lieu d'exiger que les développeurs connectent trois systèmes indépendants pour chaque phrase parlée, un modèle en temps réel peut traiter continuellement l'audio entrant et générer une sortie parlée.
Du point de vue de l'utilisateur, le flux devient beaucoup plus proche de :
Parole → Compréhension et traduction par l'IA → Parole
Ceci est généralement appelé traduction vocale en temps réel.
La distinction importante n'est pas que le texte ne peut jamais exister nulle part à l'intérieur d'un modèle d'IA.
Les modèles modernes peuvent utiliser de nombreuses représentations internes.
La différence est architecturale :
La conversation en direct n'a pas à attendre un service de transcription distinct, puis un service de traduction de texte distinct, puis un service de synthèse vocale distinct avant que l'audio traduit puisse commencer.
Cela rend un type d'interaction très différent possible.
« En temps réel » ne signifie pas toujours la même chose
Le terme traduction en temps réel est utilisé largement dans l'industrie.
Un produit peut techniquement s'appeler en temps réel s'il génère une traduction quelques secondes après que quelqu'un parle.
Pour les sous-titres, cela peut être parfaitement acceptable.
Mais la conversation humaine est beaucoup plus sensible au délai.
Considérez deux expériences.
Expérience A : Traduction en cascade
Vous parlez.
Le système attend suffisamment d'audio.
Votre parole devient du texte.
Le texte est traduit.
Le texte traduit est envoyé à un générateur vocal.
L'autre participant entend la traduction.
Ensuite, ils répondent.
Expérience B : Traduction vocale en temps réel
Vous commencez à parler.
Le modèle traite le flux audio dans le cadre d'une session continue.
Il comprend la conversation en cours et commence à générer de la parole traduite avec une dépendance significativement réduite sur les étapes de traitement distinctes.
La conversation devient plus proche de la prise de parole naturelle.
Les deux systèmes peuvent techniquement être décrits comme « en temps réel ».
Mais l'expérience peut être très différente.
Pourquoi la latence est plus importante que la plupart des critères de traduction
Les produits de traduction sont souvent évalués par la précision.
La précision est évidemment importante.
Mais lors de la communication en direct, il y a une autre dimension tout aussi importante :
la latence de conversation.
Imaginez une réunion d'affaires avec six personnes parlant plusieurs langues.
Si chaque phrase traduite introduit plusieurs secondes de silence, ces délais se multiplient dans la réunion.
Les participants commencent à interrompre les traductions.
Certaines personnes commencent à parler avant que les traductions précédentes ne soient terminées.
D'autres cessent de participer parce que suivre la conversation devient difficile.
La traduction elle-même peut être correcte tandis que l'expérience de réunion est toujours mauvaise.
Pour la communication multilingue en direct, la qualité de la traduction ne peut donc pas être mesurée uniquement par le fait que les mots sont corrects.
Elle devrait également considérer :
la rapidité avec laquelle la parole traduite commence ;
la façon dont les participants peuvent naturellement prendre la parole ;
si les interruptions peuvent être gérées ;
si le système comprend le contexte conversationnel ;
si les utilisateurs doivent attendre des phrases complètes ;
la fluidité de la conversation dans plusieurs langues.
C'est pourquoi la technologie de traduction vocale en temps réel est particulièrement importante pour les réunions.
La parole contient plus que des mots
Une autre limitation de la conversion de la parole en texte brut est que la parole humaine contient des informations difficiles à représenter complètement dans une transcription.
Les gens communiquent par :
le ton ;
le rythme ;
les pauses ;
l'emphase ;
l'hésitation ;
la vitesse de parole ;
le contexte conversationnel.
Les systèmes STT traditionnels compriment d'abord le message parlé en texte.
Certaines informations de l'audio original peuvent donc être perdues avant même que la traduction ne commence.
Les modèles modernes de traduction vocale peuvent fonctionner directement avec l'audio et ont accès à plus du signal vocal original.
Cela ne signifie pas que chaque nuance survivra toujours à la traduction.
Mais cela crée la possibilité d'interactions vocales beaucoup plus naturelles que les systèmes construits uniquement autour du texte.
Traduction vocale par rapport à traduction vocale-texte
Ces technologies sont parfois confondues, mais elles résolvent des problèmes différents.
La traduction vocale-texte convertit la langue parlée en texte traduit.
Par exemple :
Parole japonaise → Sous-titres en anglais
Ceci est extrêmement utile pour les légendes et l'accessibilité.
La traduction vocale produit de l'audio traduit :
Parole japonaise → Parole en anglais
Cela permet à l'auditeur de suivre la conversation sans lire constamment les sous-titres.
Voicli prend en charge les sous-titres en direct dans le cadre de l'expérience de réunion, mais la traduction vocale est conçue pour quelque chose de plus large : permettre aux gens de réellement communiquer dans des langues différentes, plutôt que simplement de lire les traductions de ce que les autres ont dit.
Pourquoi Voicli utilise la traduction vocale en temps réel
Voicli a été construit autour d'une idée simple :
Les gens devraient pouvoir rejoindre la même réunion et parler la langue dans laquelle ils sont les plus à l'aise.
Un participant pourrait parler l'ukrainien.
Un autre pourrait parler le japonais.
Un autre pourrait préférer l'anglais.
Un autre pourrait parler le coréen.
Au lieu de forcer tout le monde à passer à une langue seconde commune, Voicli gère la traduction pendant la conversation.
Chaque participant peut sélectionner la langue qu'il souhaite entendre.
La plateforme peut fournir de la parole traduite, des sous-titres, ou l'audio original selon la préférence de l'auditeur.
Pour la traduction vocale en direct, Voicli utilise une architecture de traduction vocale en temps réel plutôt que de s'appuyer exclusivement sur la traduction traditionnelle :
STT → traduction de texte → TTS
pipeline pour chaque énoncé traduit.
Cette différence architecturale est importante car Voicli n'essaie pas de construire un outil de transcription qui parle simplement du texte traduit.
L'objectif est de construire une couche de communication multilingue pour les vraies conversations.
Quand STT + Traduction + TTS est toujours la bonne solution
La technologie de traduction vocale ne rend pas les pipelines traditionnels obsolètes.
Il y a de nombreuses situations où STT → traduction → TTS est utile ou même préférable.
Par exemple :
Les transcriptions de réunion ont besoin de texte précis.
L'historique de conversation consultable nécessite une représentation textuelle.
Les sous-titres dépendent naturellement de la transcription.
Les systèmes de conformité peuvent avoir besoin de stocker exactement ce qui a été reconnu.
La traduction asynchrone ne nécessite pas une latence extrêmement faible.
Les flux de travail spécialisés peuvent avoir besoin que les développeurs inspectent et modifient chaque étape intermédiaire.
C'est pourquoi Voicli utilise également différentes technologies d'IA selon la tâche.
La clé est de choisir la bonne architecture pour l'expérience en cours de construction.
Pour une transcription, le texte est le produit.
Pour une conversation multilingue en direct, la conversation elle-même est le produit.
Des outils de traduction aux conversations multilingues
Pendant des décennies, la traduction automatique a principalement consisté à convertir des informations d'une langue à une autre.
D'abord les documents.
Ensuite les sites web.
Ensuite les messages.
Ensuite les sous-titres.
La traduction vocale en temps réel représente une direction différente.
Au lieu de demander :
« À quelle vitesse pouvons-nous traduire cette phrase ? »
la question la plus importante devient :
« Deux personnes parlant des langues différentes peuvent-elles communiquer naturellement ? »
Cela change la façon dont les systèmes de traduction doivent être conçus.
La latence devient critique.
La prise de parole devient critique.
La qualité audio devient critique.
Le contexte devient critique.
Et la traduction devient partie de l'infrastructure de communication plutôt qu'un outil distinct que les gens utilisent consciemment.
L'avenir des réunions multilingues
L'objectif à long terme de la traduction vocale n'est pas de faire penser aux gens à la technologie de traduction plus souvent.
C'est le contraire.
La traduction devrait progressivement disparaître dans la conversation.
Vous parlez votre langue.
L'autre personne parle la sienne.
Et la technologie gère ce qui se passe entre vous.
Il y aura toujours des défis.
Les accents, le bruit de fond, la terminologie spécifique au domaine, les locuteurs qui se chevauchent, les noms et le contexte culturel peuvent tous affecter la traduction par IA.
Mais les modèles multimodaux en temps réel changent ce qui est techniquement possible.
Nous passons de :
enregistrer → transcrire → traduire → synthétiser → écouter
vers :
parler → comprendre → traduire → entendre
Et finalement, la technologie de traduction la plus réussie peut être la technologie que les participants remarquent à peine.
La traduction en temps réel devrait ressembler à de la communication
Appeler un produit « en temps réel » est facile.
Rendre la communication multilingue réellement en temps réel est beaucoup plus difficile.
La différence n'est pas seulement des millisecondes sur un critère.
C'est si les gens peuvent parler naturellement.
S'ils peuvent répondre sans attendre.
Si une réunion multilingue ressemble à une conversation plutôt qu'à une séquence de messages traduits.
C'est le problème sur lequel Voicli travaille.
Questions fréquemment posées
Qu'est-ce que la traduction vocale ?
La traduction vocale convertit la langue parlée directement en sortie parlée dans une autre langue. Les systèmes d'IA modernes peuvent traiter l'entrée audio et générer de l'audio traduit dans une session en temps réel.
Quelle est la différence entre la traduction vocale et la traduction vocale-texte ?
La traduction vocale-texte produit du texte écrit traduit, comme les sous-titres. La traduction vocale produit de l'audio traduit que l'auditeur peut entendre.
Comment fonctionne la traduction vocale traditionnelle ?
Les systèmes traditionnels utilisent généralement trois étapes : la reconnaissance vocale, la traduction automatique et la synthèse vocale. Ceci est souvent appelé une architecture de traduction vocale en cascade.
Pourquoi STT → traduction → TTS peut-il avoir une latence plus élevée ?
Chaque étape doit traiter les informations et transmettre sa sortie au composant suivant. Le temps de traitement accumulé peut introduire un délai supplémentaire, tandis que les erreurs d'une étape peuvent également affecter les étapes suivantes.
La traduction vocale est-elle la même que l'interprétation simultanée ?
Ce sont des concepts connexes mais non identiques. L'interprétation simultanée humaine est effectuée par des interprètes professionnels. La traduction vocale par IA tente de fournir une expérience de communication multilingue à faible délai similaire automatiquement.
La traduction vocale peut-elle être utilisée pour les réunions d'affaires ?
Oui. La traduction vocale en temps réel est particulièrement utile pour les réunions internationales, les appels clients, les conversations commerciales, les équipes distantes, les entretiens et d'autres situations où les participants ne partagent pas la même langue.
Que fait Voicli ?
Voicli est une plateforme de communication vidéo multilingue avec traduction vocale en temps réel et sous-titres en direct. Les participants peuvent parler leurs langues préférées tandis que Voicli gère la traduction pendant la conversation.
Essayez Voicli et parlez votre langue. Laissez la réunion gérer la traduction.