תרגום דיבור בזמן אמת: למה לא כל תרגום קול "בזמן אמת" זהה
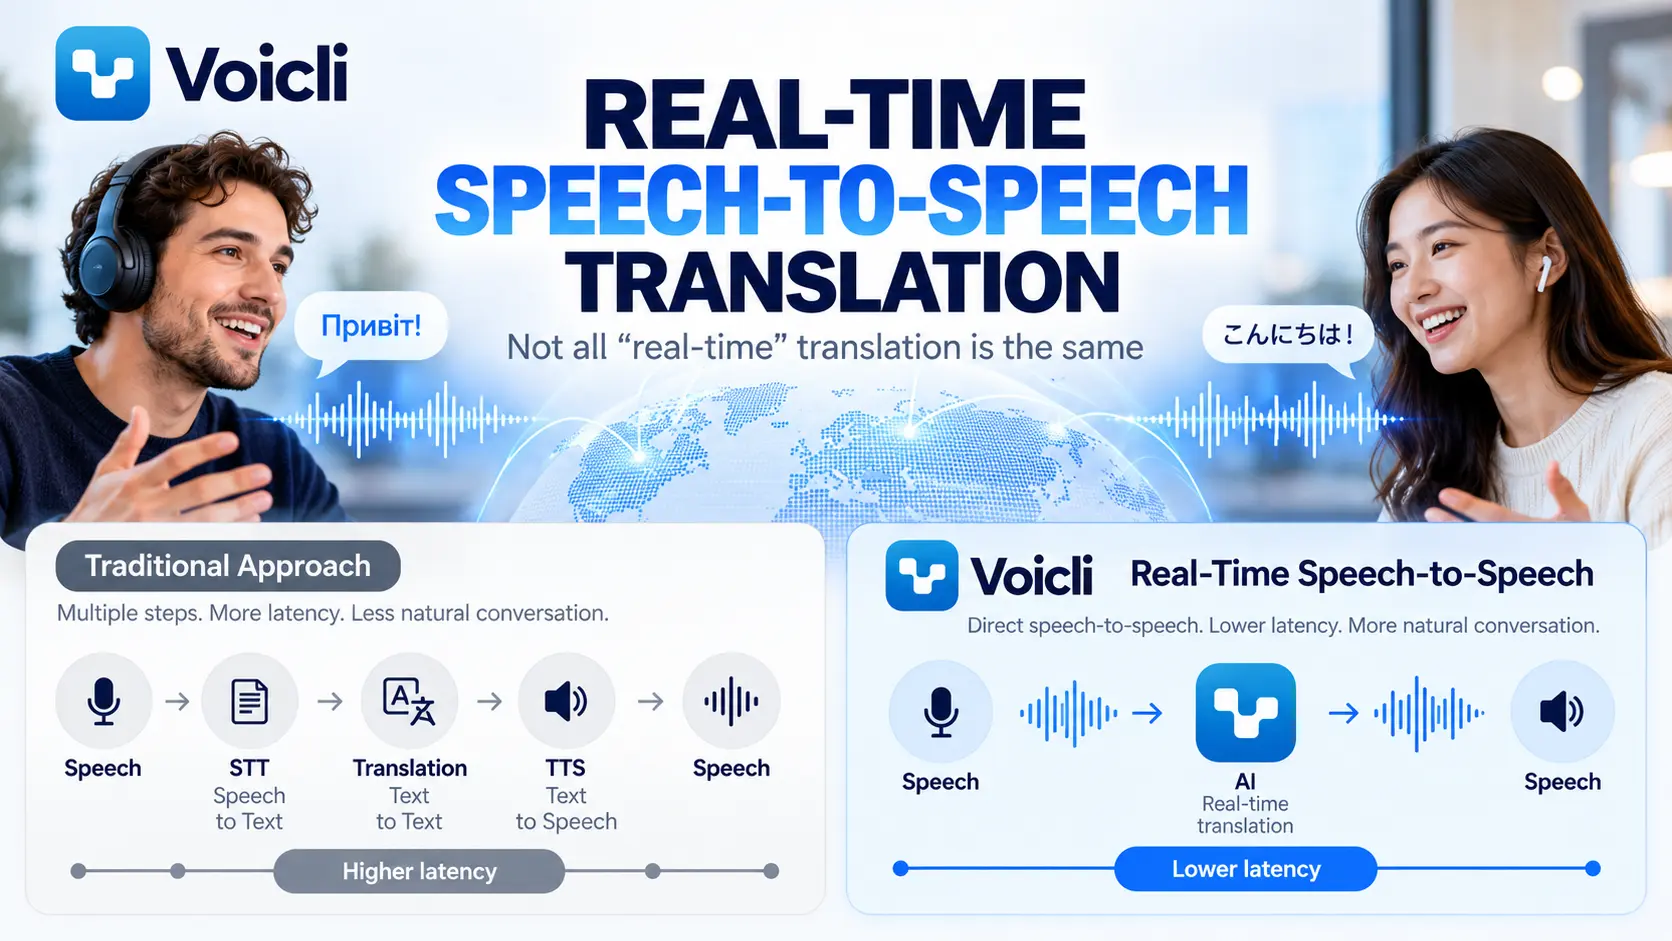
תרגום קול בזמן אמת הופך לתכונה נפוצה בפלטפורמות פגישות, כלים תקשורתיים ויישומי AI.
אך יש פרט חשוב שלעתים קרובות מוסתר מאחורי המילים "תרגום בזמן אמת."
שני מוצרים עשויים שניהם לומר שהם מתרגמים דיבור בזמן אמת תוך שימוש בטכנולוגיות שונות מאוד בבסיס.
אחד עשוי לעבד שיחה כך:
דיבור → תמלול → תרגום טקסט → טקסט לדיבור → אודיו מתורגם
אחר יכול לעבד את האינטראקציה כחוויית דיבור לדיבור רציפה, כאשר אודיו מובן ומתורגם ישירות בתוך מודל מולטימודלי בזמן אמת.
שתי הגישות יכולות לייצר דיבור מתורגם.
אך הן לא בהכרח יוצרות את אותה חוויית שיחה.
ב-Voicli, תרגום הקול החי שלנו מעוצב סביב תרגום דיבור בזמן אמת, המאפשר למשתתפים לדבר באופן טבעי בשפות שלהם בעוד שדיבור מתורגם נוצר לאנשים המאזינים.
אז מה בדיוק הוא תרגום דיבור לדיבור, ולמה הארכיטקטורה חשובה?
מה הוא תרגום דיבור בזמן אמת?
תרגום דיבור לדיבור (S2ST) היא טכנולוגיה המקבלת שפה מדוברת ומייצרת פלט מדובר בשפה אחרת.
במערכת חיה, תהליך זה מתרחש ברציפות בזמן שאנשים מנהלים שיחה.
לדוגמה:
אדם מדבר אוקראינית.
משתתף אחר רוצה לשמוע אנגלית.
המערכת מאזינה לדיבור האוקראיני, מבינה את משמעותו, מתרגמת אותו ויוצרת אודיו באנגלית למאזין.
המטרה היא לא פשוט לתרגם מילים.
המטרה היא להפוך את התקשורת בין אנשים המדברים שפות שונות לקרובה ככל האפשר לשיחה רגילה.
הבחנה זו הופכת חשובה כאשר אנו משווים מערכות דיבור לדיבור מודרניות עם צינורות תרגום קול מסורתיים.
הגישה המסורתית: STT → תרגום → TTS
במשך שנים רבות, מערכות תרגום קול בנויות מכמה טכנולוגיות נפרדות.
הארכיטקטורה בדרך כלל נראית כך:
1. דיבור לטקסט (STT)
אודיו של הדובר מומר לטקסט כתוב.
↓
2. תרגום מכונה (MT)
הטקסט הכתוב מתורגם לשפה אחרת.
↓
3. טקסט לדיבור (TTS)
הטקסט המתורגם מומר חזרה לדיבור מלאכותי.
הצינור המלא הופך ל:
אודיו → STT → טקסט → תרגום → טקסט → TTS → אודיו
ארכיטקטורה זו עובדת.
למעשה, היא הנעילה מערכות תרגום דיבור רבות במשך שנים.
היא גם שימושית כאשר המטרה העיקרית היא תמלול, כתוביות, הערות פגישה ניתנות לחיפוש, או מצבים שבהם מפתחים צריכים שליטה מלאה על כל שלב עיבוד.
אך שיחה אנושית חיה מציגה דרישה נוספת:
מהירות.
למה צינור תרגום מדורג יכול להרגיש איטי
כל שלב בצינור תרגום קול מסורתי לוקח זמן.
מערכת ההכרה בדיבור צריכה מספיק אודיו כדי להבין מה נאמר.
אז מערכת התרגום מעבדת את הטקסט שהתקבל.
אז מערכת הטקסט לדיבור יוצרת זרם אודיו חדש.
כל רכיב בודד עשוי להיות מהיר.
אך ההשהיות שלהם יכולות להצטבר.
יש בעיה נוספת.
כל שלב תלוי בפלט של השלב הקודם.
אם הכרה בדיבור מבינה בטעות מילה, מודל התרגום מקבל טקסט שגוי.
אם התרגום משנה את המשמעות, מערכת ה-TTS פשוט מדברת את הטקסט המתורגם.
במילים אחרות, שגיאות יכולות להתפשט דרך הצינור:
שגיאת הכרה בדיבור → שגיאת תרגום → שגיאת דיבור מתורגם
במהלך תרגום מסמכים זה עשוי להיות מקובל.
במהלך שיחה חיה, אפילו כמה שניות נוספות או הפסקה מביכה יכולות לשנות לחלוטין כיצד התקשורת מרגישה.
אנשים מפסיקים לדבר באופן טבעי.
הם מחכים.
הם בודקים אם התרגום הסתיים.
אז האדם השני מגיב.
במקום שיחה, התקשורת מתחילה להרגיש כמו לקיחת תורים עם מכונה.
תרגום דיבור בזמן אמת מקומי משנה את הארכיטקטורה
מודלי AI מולטימודליים מודרניים יכולים לעבוד עם קלט אודיו ופלט אודיו בתוך אותה אינטראקציה בזמן אמת.
במקום לדרוש ממפתחים לחבר שלוש מערכות עצמאיות לכל ביטוי מדובר, מודל בזמן אמת יכול לעבד ברציפות אודיו נכנס ויוצר פלט מדובר.
מנקודת המבט של המשתמש, הזרימה הופכת להרבה יותר קרובה ל:
דיבור → הבנה ותרגום של AI → דיבור
זה בדרך כלל מכונה תרגום דיבור בזמן אמת.
ההבחנה החשובה היא לא שטקסט לא יכול להיות קיים בשום מקום בתוך מודל AI.
מודלים מודרניים עשויים להשתמש בייצוגים פנימיים רבים.
ההבדל הוא ארכיטקטוני:
השיחה החיה לא צריכה להמתין לשירות תמלול נפרד, ואז לשירות תרגום טקסט נפרד, ואז לשירות סינתזה דיבור נפרד לפני שאודיו מתורגם יכול להתחיל.
זה הופך סוג אינטראקציה שונה מאוד לאפשרי.
"בזמן אמת" לא תמיד אומר את אותו הדבר
המונח תרגום בזמן אמת משמש בהרחבה בכל התעשייה.
מוצר יכול מבחינה טכנית לקרוא לעצמו בזמן אמת אם הוא יוצר תרגום כמה שניות אחרי שמישהו מדבר.
לכתוביות, זה עשוי להיות מקובל לחלוטין.
אך שיחה אנושית הרבה יותר רגישה לעיכוב.
שקול שתי חוויות.
חוויה א': תרגום מדורג
אתה מדבר.
המערכת מחכה לאודיו מספיק.
הדיבור שלך הופך לטקסט.
הטקסט מתורגם.
הטקסט המתורגם נשלח ליוצר קול.
המשתתף השני שומע את התרגום.
אז הם מגיבים.
חוויה ב': תרגום דיבור בזמן אמת
אתה מתחיל לדבר.
המודל מעבד את זרם האודיו כחלק מסשן רציף.
הוא מבין את השיחה המתמשכת ומתחיל ליצור דיבור מתורגם עם תלות משמעותית הרבה יותר נמוכה בשלבי עיבוד נפרדים.
השיחה הופכת קרובה יותר לתורים טבעיים.
שתי המערכות יכולות להיות מתוארות מבחינה טכנית כ"בזמן אמת".
אך החוויה יכולה להיות שונה מאוד.
למה זמן התגובה חשוב יותר מרוב מדדי התרגום
מוצרי תרגום מוערכים לעתים קרובות לפי דיוק.
דיוק הוא כמובן חשוב.
אך במהלך תקשורת חיה יש מימד שווה בחשיבות:
זמן תגובה בשיחה.
דמיין פגישת עסקים עם שישה אנשים המדברים כמה שפות.
אם כל משפט מתורגם מציג כמה שניות של שתיקה, ההשהיות הללו מתרבות על פני הפגישה.
משתתפים מתחילים להפריע לתרגומים.
חלק מהאנשים מתחילים לדבר לפני שתרגומים קודמים הסתיימו.
אחרים מפסיקים להשתתף כי עקיבה אחר השיחה הופכת קשה.
התרגום עצמו עשוי להיות נכון בעוד שחוויית הפגישה עדיין גרועה.
לתקשורת רב-לשונית חיה, איכות התרגום לא יכולה להיות נמדדת רק לפי האם המילים נכונות.
היא צריכה גם לשקול:
כמה מהר דיבור מתורגם מתחיל;
כמה טבעי משתתפים יכולים לקחת תורים;
האם הפרעות יכולות להיות מטופלות;
האם המערכת מבינה הקשר שיחה;
האם משתמשים צריכים להמתין למשפטים שלמים;
כמה טוב השיחה זורמת על פני שפות מרובות.
זו הסיבה שתכנולוגיית תרגום דיבור בזמן אמת חשובה במיוחד לפגישות.
דיבור מכיל יותר מאשר מילים
מגבלה נוספת של המרת דיבור לטקסט רגיל היא שדיבור אנושי מכיל מידע שקשה לייצג לחלוטין בתמלול.
אנשים מתקשרים דרך:
טון;
קצב;
הפסקות;
הדגשה;
היסוס;
מהירות דיבור;
הקשר שיחה.
מערכות STT מסורתיות תחילה דוחסות את ההודעה המדוברת לטקסט.
חלק מהמידע מאודיו המקורי יכול לכן להיות אבוד לפני שתרגום אפילו מתחיל.
מודלי דיבור לדיבור מודרניים יכולים לעבוד ישירות עם אודיו ויש להם גישה ליותר מאות האות המדוברת המקורית.
זה לא אומר שכל ניואנס תמיד ישרוד תרגום.
אך זה יוצר את האפשרות של אינטראקציות קול הרבה יותר טבעיות מאשר מערכות בנויות רק סביב טקסט.
תרגום דיבור לדיבור מול תרגום דיבור לטקסט
טכנולוגיות אלה לעתים קרובות מבולבלות, אך הן פותרות בעיות שונות.
תרגום דיבור לטקסט ממיר שפה מדוברת לטקסט מתורגם.
לדוגמה:
דיבור יפני → כתוביות באנגלית
זה שימושי ביותר לכתוביות וגישה.
תרגום דיבור לדיבור מייצר אודיו מתורגם:
דיבור יפני → דיבור באנגלית
זה מאפשר למאזין לעקוב אחר השיחה ללא קריאה קבועה של כתוביות.
Voicli תומך בכתוביות חיות כחלק מחוויית הפגישה, אך תרגום קול מעוצב למשהו רחב יותר: לאפשר לאנשים בעצם לדבר על פני שפות, במקום פשוט לקרוא תרגומים של מה שאחרים אמרו.
למה Voicli משתמש בתרגום דיבור בזמן אמת
Voicli בנויה סביב רעיון פשוט:
אנשים צריכים להיות מסוגלים להצטרף לאותה פגישה ולדבר בשפה שבה הם הכי נוחים.
משתתף אחד עשוי לדבר אוקראינית.
אחר עשוי לדבר יפנית.
אחר עשוי להעדיף אנגלית.
אחר עשוי לדבר קוריאנית.
במקום לכפות על כולם להחליף לשפה שנייה משותפת, Voicli מטפלת בתרגום במהלך השיחה.
כל משתתף יכול לבחור את השפה שהוא רוצה לשמוע.
הפלטפורמה יכולה לספק קול מתורגם, כתוביות, או אודיו מקורי בהתאם להעדפת המאזין.
לתרגום קול חי, Voicli משתמשת בארכיטקטורת דיבור לדיבור בזמן אמת במקום להסתמך בלעדית על ה:
STT → תרגום טקסט → TTS
צינור לכל ביטוי מתורגם.
הבדל ארכיטקטוני זה חשוב כי Voicli לא מנסה לבנות כלי תמלול שקורא אודיו מתורגם.
המטרה היא לבנות שכבת תקשורת רב-לשונית לשיחות אמיתיות.
כאשר STT + תרגום + TTS עדיין הפתרון הנכון
טכנולוגיית דיבור לדיבור לא הופכת צינורות מסורתיים למיושנים.
יש מצבים רבים שבהם STT → תרגום → TTS שימושי או אפילו עדיף.
לדוגמה:
תמלולי פגישות צריכים טקסט מדויק.
היסטוריית שיחה ניתנת לחיפוש דורשת ייצוג טקסט.
כתוביות תלויות באופן טבעי בתמלול.
מערכות ציות עשויות להצטרך לאחסן בדיוק מה שהוכר.
תרגום אסינכרוני לא דורש זמן תגובה נמוך ביותר.
זרימות עבודה מיוחדות עשויות להצטרך למפתחים לבדוק ולשנות כל שלב ביניים.
זו הסיבה שVoicli משתמשת גם בטכנולוגיות AI שונות בהתאם למשימה.
המפתח הוא בחירת הארכיטקטורה הנכונה לחוויה שמתבנית.
לתמלול, הטקסט הוא המוצר.
לשיחה רב-לשונית חיה, השיחה עצמה היא המוצר.
מכלים תרגום לשיחות רב-לשוניות
במשך עשרות שנים, תרגום מכונה היה בעיקר על המרת מידע משפה אחת לאחרת.
תחילה מסמכים.
אז אתרים.
אז הודעות.
אז כתוביות.
תרגום דיבור בזמן אמת מייצג כיוון שונה.
במקום לשאול:
"כמה מהר אנחנו יכולים לתרגם את המשפט הזה?"
השאלה החשובה יותר הופכת ל:
"האם שני אנשים המדברים שפות שונות יכולים להתקשר באופן טבעי?"
זה משנה כיצד מערכות תרגום צריכות להיות מעוצבות.
זמן התגובה הופך קריטי.
לקיחת תורים הופכת קריטית.
איכות אודיו הופכת קריטית.
הקשר הופך קריטי.
ותרגום הופך לחלק מתשתית התקשורת במקום כלי נפרד שאנשים משתמשים בו בעיצומיות.
העתיד של פגישות רב-לשוניות
המטרה לטווח ארוך של תרגום דיבור היא לא להפוך אנשים לחושבים על טכנולוגיית תרגום בתדירות גבוהה יותר.
זה ההפך.
התרגום צריך בהדרגה להיעלם לתוך השיחה.
אתה מדבר בשפה שלך.
האדם השני מדבר בשלו.
והטכנולוגיה מטפלת במה שקורה בינך לבינו.
עדיין יהיו אתגרים.
הגיות, רעש רקע, טרמינולוגיה ספציפית לתחום, דוברים חופפים, שמות והקשר תרבותי יכולים כולם להשפיע על תרגום AI.
אך מודלים מולטימודליים בזמן אמת משנים מה שאפשרי מבחינה טכנית.
אנחנו עוברים מ:
הקלטה → תמלול → תרגום → סינתזה → האזנה
לכיוון:
דיבור → הבנה → תרגום → שמיעה
ובסופו של דבר, הטכנולוגיית התרגום המוצלחת ביותר עשויה להיות הטכנולוגיה שמשתתפים בקושי שמים לב אליה.
תרגום בזמן אמת צריך להרגיש כמו תקשורת
קריאה למוצר "בזמן אמת" קלה.
הפיכת תקשורת רב-לשונית בפועל להרגיש בזמן אמת הרבה יותר קשה.
ההבדל הוא לא רק אלפיות שניה בהשוואה.
זה האם אנשים יכולים לדבר באופן טבעי.
האם הם יכולים להגיב ללא המתנה.
האם פגישה רב-לשונית מרגישה כמו שיחה במקום רצף של הודעות מתורגמות.
זו הבעיה שVoicli עובדת עליה.
תרגום דיבור בזמן אמת לשיחות שבהן כולם יכולים לדבר בשפה שלהם.
שאלות נפוצות
מה הוא תרגום דיבור לדיבור?
תרגום דיבור לדיבור ממיר שפה מדוברת ישירות לפלט מדובר בשפה אחרת. מערכות AI מודרניות יכולות לעבד קלט אודיו ליצור אודיו מתורגם בתוך סשן בזמן אמת.
מה ההבדל בין תרגום דיבור לדיבור לתרגום דיבור לטקסט?
תרגום דיבור לטקסט מייצר טקסט כתוב מתורגם, כגון כתוביות. תרגום דיבור לדיבור מייצר אודיו מתורגם שהמאזין יכול לשמוע.
כיצד עובדת תרגום קול מסורתי?
מערכות מסורתיות בדרך כלל משתמשות בשלוש שלבים: הכרה בדיבור לטקסט, תרגום מכונה וסינתזה טקסט לדיבור. זה לעתים קרובות נקרא ארכיטקטורת תרגום דיבור מדורגת.
למה STT → תרגום → TTS יכול להיות בעל זמן תגובה גבוה יותר?
כל שלב חייב לעבד מידע ולהעביר את הפלט שלו לרכיב הבא. הזמן העיבוד המצטבר יכול להציג עיכוב נוסף, בעוד שגיאות משלב אחד יכולות גם להשפיע על שלבים עוקבים.
האם תרגום דיבור לדיבור זהה לפירוש סימולטני?
הם קונספטים קשורים אך לא זהים. פירוש סימולטני אנושי מבוצע על ידי מתורגמים מקצועיים. תרגום דיבור לדיבור של AI מנסה לספק חוויית תקשורת רב-לשונית דומה בעיכוב נמוך באופן אוטומטי.
האם ניתן להשתמש בתרגום דיבור לדיבור לפגישות עסקיות?
כן. תרגום דיבור בזמן אמת שימושי במיוחד לפגישות בינלאומיות, שיחות עם לקוחות, שיחות מכירות, צוותים מרוחקים, ראיונות ומצבים אחרים שבהם משתתפים לא חולקים את אותה שפה.
מה עושה Voicli?
Voicli היא פלטפורמת תקשורת וידאו רב-לשונית עם תרגום קול בזמן אמת וכתוביות חיות. משתתפים יכולים לדבר בשפות המועדפות שלהם בעוד Voicli מטפלת בתרגום במהלך השיחה.
נסו את Voicli ודברו בשפה שלכם. תנו לפגישה להטפל בתרגום.