रीयल-टाइम स्पीच-टू-स्पीच अनुवाद: क्यों सभी "रीयल-टाइम" वॉयस अनुवाद समान नहीं हैं
Key Takeaways
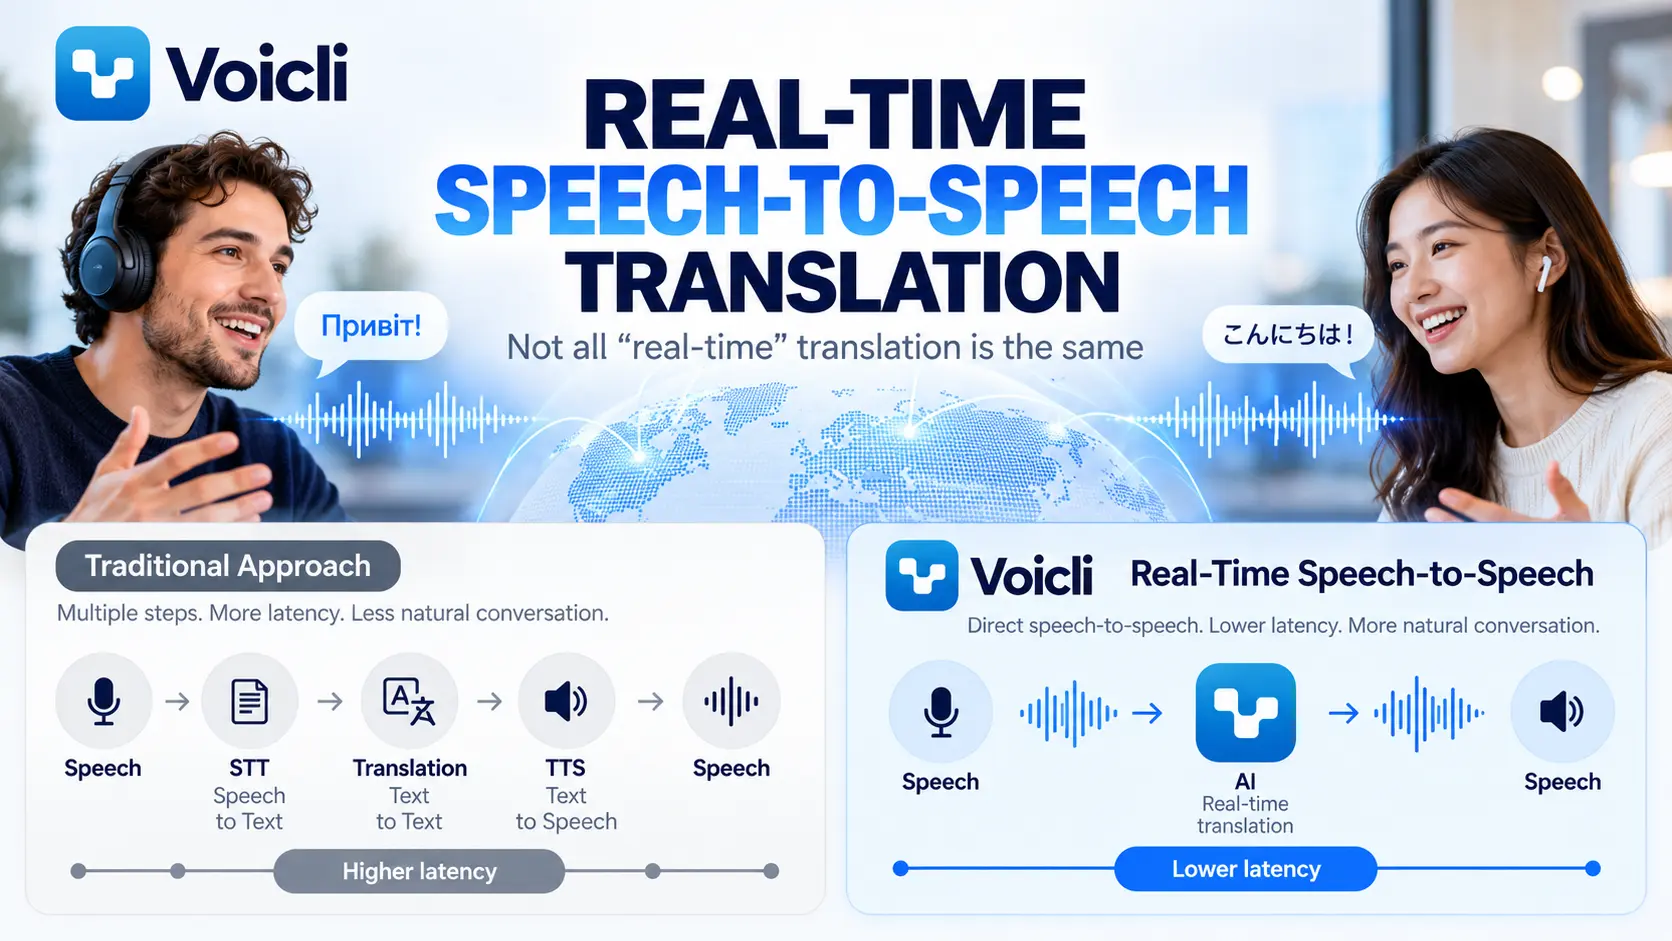
- रीयल-टाइम स्पीच-टू-स्पीच अनुवाद ऑडियो को सीधे संसाधित करता है, जबकि पारंपरिक सिस्टम भाषण को पाठ में परिवर्तित करते हैं, फिर अनुवाद करते हैं, फिर वापस भाषण में परिवर्तित करते हैं।
- कैस्केडेड STT → अनुवाद → TTS पाइपलाइन में प्रत्येक चरण विलंब जोड़ता है और एक चरण से त्रुटियां अगले चरणों को प्रभावित कर सकती हैं।
- लाइव बहुभाषी बातचीत के लिए, विलंब और प्राकृतिक बारी-बारी अनुवाद सटीकता जितनी ही महत्वपूर्ण है।
- भाषण में टोन, लय, जोर और संदर्भ जैसी जानकारी होती है जो पाठ में पूरी तरह से प्रतिनिधित्व नहीं की जा सकती।
- स्पीच-टू-स्पीच अनुवाद (अनुवादित ऑडियो) स्पीच-टू-टेक्स्ट अनुवाद (अनुवादित पाठ/उपशीर्षक) से अलग है।
- Voicli रीयल-टाइम स्पीच-टू-स्पीच आर्किटेक्चर का उपयोग करता है ताकि प्रतिभागी अपनी पसंदीदा भाषाओं में बोल सकें और प्राकृतिक बहुभाषी बातचीत हो सके।
रीयल-टाइम वॉयस अनुवाद मीटिंग प्लेटफॉर्म, संचार उपकरण और AI अनुप्रयोगों में एक सामान्य सुविधा बन रहा है।
लेकिन एक महत्वपूर्ण विवरण है जो अक्सर शब्दों "रीयल-टाइम अनुवाद" के पीछे छिपा होता है।
दो उत्पाद दोनों कह सकते हैं कि वे भाषण का रीयल-टाइम में अनुवाद करते हैं जबकि अंदर बहुत अलग तकनीकें उपयोग करते हैं।
एक बातचीत को इस तरह संसाधित कर सकता है:
भाषण → प्रतिलेखन → पाठ अनुवाद → पाठ-से-भाषण → अनुवादित ऑडियो
दूसरा इंटरैक्शन को एक सतत स्पीच-टू-स्पीच अनुभव के रूप में संसाधित कर सकता है, जहां ऑडियो को एक रीयल-टाइम मल्टीमॉडल मॉडल के भीतर सीधे समझा और अनुवादित किया जाता है।
दोनों दृष्टिकोण अनुवादित भाषण का उत्पादन कर सकते हैं।
लेकिन वे आवश्यक रूप से समान बातचीत का अनुभव नहीं बनाते हैं।
Voicli में, हमारा लाइव वॉयस अनुवाद रीयल-टाइम स्पीच-टू-स्पीच अनुवाद के चारों ओर डिज़ाइन किया गया है, जो प्रतिभागियों को अपनी भाषाओं में स्वाभाविक रूप से बोलने की अनुमति देता है जबकि सुनने वाले लोगों के लिए अनुवादित भाषण उत्पन्न होता है।
तो स्पीच-टू-स्पीच अनुवाद वास्तव में क्या है, और आर्किटेक्चर क्यों महत्वपूर्ण है?
रीयल-टाइम स्पीच-टू-स्पीच अनुवाद क्या है?
स्पीच-टू-स्पीच अनुवाद (S2ST) एक तकनीक है जो बोली जाने वाली भाषा को प्राप्त करती है और दूसरी भाषा में बोली जाने वाली आउटपुट का उत्पादन करती है।
एक लाइव सिस्टम में, यह प्रक्रिया लगातार होती है जबकि लोग बातचीत कर रहे होते हैं।
उदाहरण के लिए:
एक व्यक्ति यूक्रेनी बोलता है।
एक अन्य प्रतिभागी अंग्रेजी सुनना चाहता है।
सिस्टम यूक्रेनी भाषण को सुनता है, इसका अर्थ समझता है, इसका अनुवाद करता है, और श्रोता के लिए अंग्रेजी ऑडियो उत्पन्न करता है।
लक्ष्य केवल शब्दों का अनुवाद करना नहीं है।
लक्ष्य विभिन्न भाषाएं बोलने वाले लोगों के बीच संचार को सामान्य बातचीत के जितना करीब संभव हो सके बनाना है।
यह अंतर महत्वपूर्ण हो जाता है जब हम आधुनिक स्पीच-टू-स्पीच सिस्टम की तुलना पारंपरिक वॉयस अनुवाद पाइपलाइन से करते हैं।
पारंपरिक दृष्टिकोण: STT → अनुवाद → TTS
कई वर्षों से, वॉयस अनुवाद सिस्टम कई अलग-अलग तकनीकों से बनाए गए हैं।
आर्किटेक्चर आमतौर पर इस तरह दिखता है:
1. स्पीच-टू-टेक्स्ट (STT)
वक्ता के ऑडियो को लिखित पाठ में परिवर्तित किया जाता है।
↓
2. मशीन अनुवाद (MT)
लिखित पाठ को दूसरी भाषा में अनुवादित किया जाता है।
↓
3. टेक्स्ट-टू-स्पीच (TTS)
अनुवादित पाठ को कृत्रिम भाषण में परिवर्तित किया जाता है।
संपूर्ण पाइपलाइन बन जाती है:
ऑडियो → STT → पाठ → अनुवाद → पाठ → TTS → ऑडियो
यह आर्किटेक्चर काम करता है।
वास्तव में, यह कई वर्षों से कई भाषण अनुवाद सिस्टम को शक्ति दे रहा है।
यह तब भी उपयोगी है जब प्राथमिक लक्ष्य प्रतिलेखन, उपशीर्षक, खोजने योग्य मीटिंग नोट्स, या ऐसी स्थितियां हों जहां डेवलपर्स को प्रत्येक प्रसंस्करण चरण पर पूर्ण नियंत्रण की आवश्यकता हो।
लेकिन लाइव मानव बातचीत एक और आवश्यकता का परिचय देती है:
गति।
क्यों एक कैस्केडेड अनुवाद पाइपलाइन धीमी महसूस कर सकती है
पारंपरिक वॉयस अनुवाद पाइपलाइन में प्रत्येक चरण समय लेता है।
भाषण पहचान प्रणाली को यह समझने के लिए पर्याप्त ऑडियो की आवश्यकता है कि क्या कहा गया था।
फिर अनुवाद प्रणाली परिणामी पाठ को संसाधित करती है।
फिर टेक्स्ट-टू-स्पीच प्रणाली एक नई ऑडियो स्ट्रीम उत्पन्न करती है।
प्रत्येक व्यक्तिगत घटक तेज़ हो सकता है।
लेकिन उनके विलंब जमा हो सकते हैं।
एक और समस्या है।
प्रत्येक चरण पिछले चरण के आउटपुट पर निर्भर करता है।
यदि भाषण पहचान किसी शब्द को गलत समझती है, तो अनुवाद मॉडल को गलत पाठ मिलता है।
यदि अनुवाद अर्थ को बदलता है, तो TTS प्रणाली बस उस अनुवादित पाठ को बोलती है।
दूसरे शब्दों में, त्रुटियां पाइपलाइन के माध्यम से प्रसारित हो सकती हैं:
भाषण पहचान त्रुटि → अनुवाद त्रुटि → बोली गई अनुवाद त्रुटि
दस्तावेज़ अनुवाद के दौरान यह स्वीकार्य हो सकता है।
लाइव बातचीत के दौरान, कुछ अतिरिक्त सेकंड या एक अजीब विराम भी संचार की भावना को पूरी तरह बदल सकता है।
लोग स्वाभाविक रूप से बोलना बंद कर देते हैं।
वे प्रतीक्षा करते हैं।
वे जांचते हैं कि क्या अनुवाद समाप्त हो गया है।
फिर दूसरा व्यक्ति जवाब देता है।
बातचीत के बजाय, संचार एक मशीन के साथ बारी-बारी से लेना शुरू कर देता है।
नेटिव रीयल-टाइम स्पीच-टू-स्पीच आर्किटेक्चर को बदलता है
आधुनिक मल्टीमॉडल AI मॉडल एक ही रीयल-टाइम इंटरैक्शन के भीतर ऑडियो इनपुट और ऑडियो आउटपुट के साथ काम कर सकते हैं।
डेवलपर्स को हर बोले गए वाक्यांश के लिए तीन स्वतंत्र सिस्टम को कनेक्ट करने की आवश्यकता के बजाय, एक रीयल-टाइम मॉडल लगातार आने वाली ऑडियो को संसाधित कर सकता है और बोली जाने वाली आउटपुट उत्पन्न कर सकता है।
उपयोगकर्ता के दृष्टिकोण से, प्रवाह बहुत करीब हो जाता है:
भाषण → AI समझ और अनुवाद → भाषण
इसे आमतौर पर रीयल-टाइम स्पीच-टू-स्पीच अनुवाद कहा जाता है।
महत्वपूर्ण अंतर यह नहीं है कि पाठ कभी भी AI मॉडल के अंदर कहीं मौजूद हो सकता है।
आधुनिक मॉडल कई आंतरिक प्रतिनिधित्व का उपयोग कर सकते हैं।
अंतर आर्किटेक्चरल है:
लाइव बातचीत को एक अलग प्रतिलेखन सेवा, फिर एक अलग पाठ अनुवाद सेवा, और फिर एक अलग भाषण संश्लेषण सेवा के लिए प्रतीक्षा नहीं करनी पड़ती है इससे पहले कि अनुवादित ऑडियो शुरू हो सके।
यह एक बहुत ही अलग प्रकार की इंटरैक्शन संभव बनाता है।
"रीयल-टाइम" हमेशा एक ही चीज़ का मतलब नहीं है
शब्द रीयल-टाइम अनुवाद पूरे उद्योग में व्यापक रूप से उपयोग किया जाता है।
एक उत्पाद तकनीकी रूप से खुद को रीयल-टाइम कह सकता है यदि वह किसी के बोलने के कुछ सेकंड बाद अनुवाद उत्पन्न करता है।
उपशीर्षक के लिए, यह पूरी तरह स्वीकार्य हो सकता है।
लेकिन मानव बातचीत विलंब के प्रति बहुत अधिक संवेदनशील है।
दो अनुभवों पर विचार करें।
अनुभव A: कैस्केडेड अनुवाद
आप बोलते हैं।
सिस्टम पर्याप्त ऑडियो के लिए प्रतीक्षा करता है।
आपका भाषण पाठ बन जाता है।
पाठ का अनुवाद किया जाता है।
अनुवादित पाठ एक वॉयस जेनरेटर को भेजा जाता है।
अन्य प्रतिभागी को अनुवाद सुनाई देता है।
फिर वे जवाब देते हैं।
अनुभव B: रीयल-टाइम स्पीच-टू-स्पीच
आप बोलना शुरू करते हैं।
मॉडल ऑडियो स्ट्रीम को एक सतत सत्र के हिस्से के रूप में संसाधित करता है।
यह चल रही बातचीत को समझता है और अलग-अलग प्रसंस्करण चरणों पर काफी कम निर्भरता के साथ अनुवादित भाषण उत्पन्न करना शुरू करता है।
बातचीत प्राकृतिक बारी-बारी के करीब हो जाती है।
दोनों सिस्टम तकनीकी रूप से "रीयल-टाइम" के रूप में वर्णित किए जा सकते हैं।
लेकिन अनुभव बहुत अलग हो सकता है।
क्यों विलंब अधिकांश अनुवाद बेंचमार्क से अधिक महत्वपूर्ण है
अनुवाद उत्पादों का मूल्यांकन अक्सर सटीकता द्वारा किया जाता है।
सटीकता स्पष्ट रूप से महत्वपूर्ण है।
लेकिन लाइव संचार के दौरान एक और समान रूप से महत्वपूर्ण आयाम है:
बातचीत विलंब।
कल्पना करें कि छह लोगों के साथ एक व्यावसायिक बैठक कई भाषाएं बोल रहे हैं।
यदि हर अनुवादित वाक्य कई सेकंड की चुप्पी का परिचय देता है, तो वे विलंब पूरी बैठक में गुणा हो जाते हैं।
प्रतिभागी अनुवाद में बाधा डालना शुरू करते हैं।
कुछ लोग पिछले अनुवाद समाप्त होने से पहले बोलना शुरू कर देते हैं।
अन्य भाग लेना बंद कर देते हैं क्योंकि बातचीत का पालन करना मुश्किल हो जाता है।
अनुवाद स्वयं सही हो सकता है जबकि बैठक का अनुभव अभी भी खराब है।
लाइव बहुभाषी संचार के लिए, अनुवाद गुणवत्ता इसलिए केवल यह मापी नहीं जा सकती कि शब्द सही हैं या नहीं।
इसे निम्नलिखित पर भी विचार करना चाहिए:
अनुवादित भाषण कितनी जल्दी शुरू होता है;
प्रतिभागी कितनी स्वाभाविक रूप से बारी ले सकते हैं;
क्या बाधाओं को संभाला जा सकता है;
क्या सिस्टम बातचीत के संदर्भ को समझता है;
क्या उपयोगकर्ताओं को पूर्ण वाक्यों के लिए प्रतीक्षा करनी पड़ती है;
बातचीत कई भाषाओं में कितनी अच्छी तरह बहती है।
यह कारण है कि रीयल-टाइम स्पीच-टू-स्पीच तकनीक विशेष रूप से बैठकों के लिए महत्वपूर्ण है।
भाषण में शब्दों से अधिक होता है
भाषण को सादे पाठ में परिवर्तित करने की एक और सीमा यह है कि मानव भाषण में ऐसी जानकारी होती है जो प्रतिलेखन में पूरी तरह से प्रतिनिधित्व करना मुश्किल है।
लोग निम्नलिखित के माध्यम से संचार करते हैं:
टोन;
लय;
विराम;
जोर;
संकोच;
बोलने की गति;
बातचीत का संदर्भ।
पारंपरिक STT सिस्टम पहले बोली गई संदेश को पाठ में संपीड़ित करते हैं।
मूल ऑडियो से कुछ जानकारी इसलिए अनुवाद शुरू होने से पहले खो सकती है।
आधुनिक स्पीच-टू-स्पीच मॉडल सीधे ऑडियो के साथ काम कर सकते हैं और मूल भाषण संकेत के अधिक हिस्से तक पहुंच सकते हैं।
इसका मतलब यह नहीं है कि हर बारीकी हमेशा अनुवाद से बचेगी।
लेकिन यह केवल पाठ के चारों ओर बनाए गए सिस्टम की तुलना में बहुत अधिक प्राकृतिक वॉयस इंटरैक्शन की संभावना बनाता है।
स्पीच-टू-स्पीच बनाम स्पीच-टू-टेक्स्ट अनुवाद
ये तकनीकें कभी-कभी भ्रमित होती हैं, लेकिन वे विभिन्न समस्याओं को हल करती हैं।
स्पीच-टू-टेक्स्ट अनुवाद बोली जाने वाली भाषा को अनुवादित पाठ में परिवर्तित करता है।
उदाहरण के लिए:
जापानी भाषण → अंग्रेजी उपशीर्षक
यह कैप्शन और पहुंच के लिए अत्यंत उपयोगी है।
स्पीच-टू-स्पीच अनुवाद अनुवादित ऑडियो का उत्पादन करता है:
जापानी भाषण → अंग्रेजी भाषण
यह श्रोता को लगातार उपशीर्षक पढ़े बिना बातचीत का पालन करने की अनुमति देता है।
Voicli बैठक के अनुभव के हिस्से के रूप में लाइव उपशीर्षक का समर्थन करता है, लेकिन वॉयस अनुवाद कुछ व्यापक के लिए डिज़ाइन किया गया है: लोगों को वास्तव में भाषाओं के पार बात करने की अनुमति देना, बजाय केवल दूसरों ने जो कहा उसके अनुवाद को पढ़ने के।
Voicli क्यों रीयल-टाइम स्पीच-टू-स्पीच अनुवाद का उपयोग करता है
Voicli एक सरल विचार के चारों ओर बनाया गया था:
लोगों को एक ही बैठक में शामिल होने और उस भाषा में बोलने में सक्षम होना चाहिए जिसमें वे सबसे सहज हैं।
एक प्रतिभागी यूक्रेनी बोल सकता है।
दूसरा जापानी बोल सकता है।
दूसरा अंग्रेजी पसंद कर सकता है।
दूसरा कोरियाई बोल सकता है।
सभी को एक सामान्य दूसरी भाषा में स्विच करने के लिए मजबूर करने के बजाय, Voicli बातचीत के दौरान अनुवाद को संभालता है।
प्रत्येक प्रतिभागी वह भाषा चुन सकता है जो वह सुनना चाहता है।
प्लेटफॉर्म श्रोता की पसंद के आधार पर अनुवादित वॉयस, उपशीर्षक, या मूल ऑडियो प्रदान कर सकता है।
लाइव वॉयस अनुवाद के लिए, Voicli पारंपरिक के विशेष रूप से भरोसा करने के बजाय एक रीयल-टाइम स्पीच-टू-स्पीच आर्किटेक्चर का उपयोग करता है:
STT → पाठ अनुवाद → TTS
हर अनुवादित उच्चारण के लिए पाइपलाइन।
यह आर्किटेक्चरल अंतर महत्वपूर्ण है क्योंकि Voicli एक प्रतिलेखन उपकरण बनाने की कोशिश नहीं कर रहा है जो अनुवादित पाठ को बोलता है।
लक्ष्य एक वास्तविक बातचीत के लिए बहुभाषी संचार परत बनाना है।
जब STT + अनुवाद + TTS अभी भी सही समाधान है
स्पीच-टू-स्पीच तकनीक पारंपरिक पाइपलाइनों को अप्रचलित नहीं बनाती है।
ऐसी कई स्थितियां हैं जहां STT → अनुवाद → TTS उपयोगी है या यहां तक कि बेहतर है।
उदाहरण के लिए:
बैठक प्रतिलेखन को सटीक पाठ की आवश्यकता है।
खोजने योग्य बातचीत इतिहास को पाठ प्रतिनिधित्व की आवश्यकता है।
उपशीर्षक स्वाभाविक रूप से प्रतिलेखन पर निर्भर करते हैं।
अनुपालन प्रणाली को यह संग्रहीत करने की आवश्यकता हो सकती है कि वास्तव में क्या पहचाना गया था।
अतुल्यकालिक अनुवाद को अत्यंत कम विलंब की आवश्यकता नहीं है।
विशेष वर्कफ़्लो को डेवलपर्स को हर मध्यवर्ती चरण का निरीक्षण और संशोधन करने की आवश्यकता हो सकती है।
यही कारण है कि Voicli कार्य के आधार पर विभिन्न AI तकनीकों का भी उपयोग करता है।
मुख्य बात सही अनुभव के लिए सही आर्किटेक्चर चुनना है।
एक प्रतिलेखन के लिए, पाठ उत्पाद है।
एक लाइव बहुभाषी बातचीत के लिए, बातचीत स्वयं उत्पाद है।
अनुवाद उपकरण से बहुभाषी बातचीत तक
दशकों से, मशीन अनुवाद मुख्य रूप से एक भाषा से दूसरी भाषा में जानकारी परिवर्तित करने के बारे में रहा है।
पहले दस्तावेज़।
फिर वेबसाइटें।
फिर संदेश।
फिर उपशीर्षक।
रीयल-टाइम स्पीच-टू-स्पीच अनुवाद एक अलग दिशा का प्रतिनिधित्व करता है।
इसके बजाय कि पूछा जाए:
"हम इस वाक्य का कितनी जल्दी अनुवाद कर सकते हैं?"
अधिक महत्वपूर्ण प्रश्न बन जाता है:
"क्या दो लोग जो विभिन्न भाषाएं बोलते हैं स्वाभाविक रूप से संचार कर सकते हैं?"
यह बदलता है कि अनुवाद सिस्टम को कैसे डिज़ाइन किया जाना चाहिए।
विलंब महत्वपूर्ण हो जाता है।
बारी-बारी महत्वपूर्ण हो जाती है।
ऑडियो गुणवत्ता महत्वपूर्ण हो जाती है।
संदर्भ महत्वपूर्ण हो जाता है।
और अनुवाद संचार बुनियादी ढांचे का हिस्सा बन जाता है बजाय एक अलग उपकरण के जो लोग सचेत रूप से उपयोग करते हैं।
बहुभाषी बैठकों का भविष्य
भाषण अनुवाद का दीर्घकालिक लक्ष्य लोगों को अनुवाद तकनीक के बारे में अधिक बार सोचने के लिए नहीं बनाना है।
यह विपरीत है।
अनुवाद धीरे-धीरे बातचीत में गायब हो जाना चाहिए।
आप अपनी भाषा बोलते हैं।
दूसरा व्यक्ति अपनी भाषा बोलता है।
और तकनीक आपके बीच क्या होता है इसे संभालता है।
अभी भी चुनौतियां होंगी।
लहजे, पृष्ठभूमि शोर, डोमेन-विशिष्ट शब्दावली, ओवरलैपिंग वक्ता, नाम, और सांस्कृतिक संदर्भ सभी AI अनुवाद को प्रभावित कर सकते हैं।
लेकिन रीयल-टाइम मल्टीमॉडल मॉडल तकनीकी रूप से संभव है इसे बदल रहे हैं।
हम इससे आगे बढ़ रहे हैं:
रिकॉर्ड → प्रतिलेखन → अनुवाद → संश्लेषण → सुनें
की ओर:
बोलें → समझें → अनुवाद करें → सुनें
और अंततः, सबसे सफल अनुवाद तकनीक वह तकनीक हो सकती है जिसे प्रतिभागी मुश्किल से नोटिस करते हैं।
रीयल-टाइम अनुवाद संचार की तरह महसूस होना चाहिए
किसी उत्पाद को "रीयल-टाइम" कहना आसान है।
बहुभाषी संचार को वास्तव में रीयल-टाइम महसूस कराना बहुत कठिन है।
अंतर केवल बेंचमार्क पर मिलीसेकंड नहीं है।
यह है कि क्या लोग स्वाभाविक रूप से बोल सकते हैं।
क्या वे प्रतीक्षा किए बिना जवाब दे सकते हैं।
क्या एक बहुभाषी बैठक अनुवादित संदेशों के अनुक्रम के बजाय एक बातचीत की तरह महसूस होती है।
यह समस्या है जिस पर Voicli काम कर रहा है।
बातचीत के लिए रीयल-टाइम स्पीच-टू-स्पीच अनुवाद जहां हर कोई अपनी भाषा बोल सकता है।
अक्सर पूछे जाने वाले प्रश्न
स्पीच-टू-स्पीच अनुवाद क्या है?
स्पीच-टू-स्पीच अनुवाद बोली जाने वाली भाषा को सीधे दूसरी भाषा में बोली जाने वाली आउटपुट में परिवर्तित करता है। आधुनिक AI सिस्टम एक रीयल-टाइम सत्र के भीतर ऑडियो इनपुट को संसाधित कर सकते हैं और अनुवादित ऑडियो उत्पन्न कर सकते हैं।
स्पीच-टू-स्पीच और स्पीच-टू-टेक्स्ट अनुवाद में क्या अंतर है?
स्पीच-टू-टेक्स्ट अनुवाद अनुवादित लिखित पाठ का उत्पादन करता है, जैसे उपशीर्षक। स्पीच-टू-स्पीच अनुवाद अनुवादित ऑडियो का उत्पादन करता है जो श्रोता सुन सकता है।
पारंपरिक वॉयस अनुवाद कैसे काम करता है?
पारंपरिक सिस्टम आमतौर पर तीन चरणों का उपयोग करते हैं: भाषण-से-पाठ पहचान, मशीन अनुवाद, और पाठ-से-भाषण संश्लेषण। इसे अक्सर कैस्केडेड भाषण अनुवाद आर्किटेक्चर कहा जाता है।
STT → अनुवाद → TTS में उच्च विलंब क्यों हो सकता है?
प्रत्येक चरण को जानकारी को संसाधित करना चाहिए और अपना आउटपुट अगले घटक को पास करना चाहिए। संचित प्रसंस्करण समय अतिरिक्त विलंब का परिचय दे सकता है, जबकि एक चरण से त्रुटियां बाद के चरणों को भी प्रभावित कर सकती हैं।
क्या स्पीच-टू-स्पीच अनुवाद समवर्ती व्याख्या के समान है?
वे संबंधित अवधारणाएं हैं लेकिन समान नहीं हैं। मानव समवर्ती व्याख्या पेशेवर दुभाषियों द्वारा की जाती है। AI स्पीच-टू-स्पीच अनुवाद स्वचालित रूप से समान कम-विलंब बहुभाषी संचार अनुभव प्रदान करने का प्रयास करता है।
क्या स्पीच-टू-स्पीच अनुवाद का उपयोग व्यावसायिक बैठकों के लिए किया जा सकता है?
हां। रीयल-टाइम स्पीच-टू-स्पीच अनुवाद अंतर्राष्ट्रीय बैठकों, ग्राहक कॉल, बिक्री बातचीत, दूरस्थ टीमों, साक्षात्कार, और अन्य स्थितियों के लिए विशेष रूप से उपयोगी है जहां प्रतिभागी एक ही भाषा साझा नहीं करते हैं।
Voicli क्या करता है?
Voicli रीयल-टाइम वॉयस अनुवाद और लाइव उपशीर्षक के साथ एक बहुभाषी वीडियो संचार प्लेटफॉर्म है। प्रतिभागी अपनी पसंदीदा भाषाएं बोल सकते हैं जबकि Voicli बातचीत के दौरान अनुवाद को संभालता है।
Voicli आजमाएं और अपनी भाषा बोलें। बैठक को अनुवाद को संभालने दें।