Terjemahan Ucapan Waktu Nyata: Mengapa Tidak Semua "Waktu Nyata" Terjemahan Suara Sama
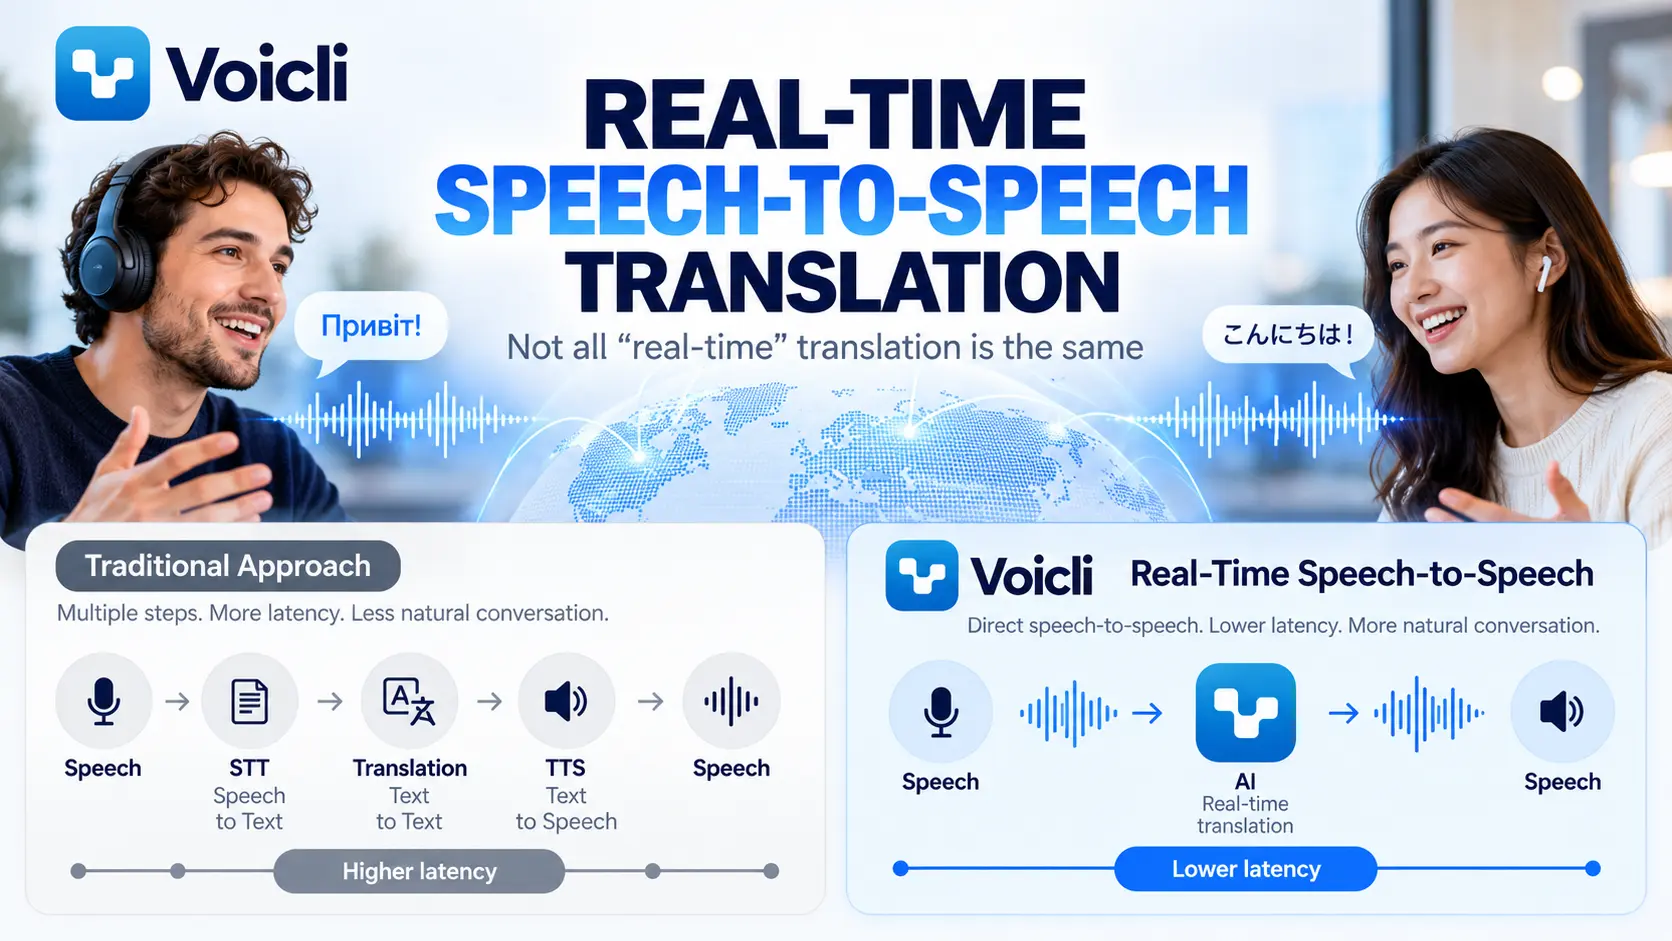
Terjemahan suara waktu nyata menjadi fitur umum dalam platform pertemuan, alat komunikasi, dan aplikasi AI.
Namun ada detail penting yang sering tersembunyi di balik kata-kata "terjemahan waktu nyata."
Dua produk mungkin sama-sama mengatakan mereka menerjemahkan ucapan secara waktu nyata sambil menggunakan teknologi yang sangat berbeda di baliknya.
Satu mungkin memproses percakapan seperti ini:
Ucapan → transkripsi → terjemahan teks → teks-ke-ucapan → audio terjemahan
Yang lain dapat memproses interaksi sebagai pengalaman ucapan-ke-ucapan berkelanjutan, di mana audio dipahami dan diterjemahkan langsung dalam model multimodal waktu nyata.
Kedua pendekatan dapat menghasilkan ucapan terjemahan.
Namun mereka tidak harus menciptakan pengalaman percakapan yang sama.
Di Voicli, terjemahan suara langsung kami dirancang di sekitar terjemahan ucapan waktu nyata, memungkinkan peserta berbicara secara alami dalam bahasa mereka sendiri sambil ucapan terjemahan dihasilkan untuk orang-orang yang mendengarkan.
Jadi apa sebenarnya terjemahan ucapan-ke-ucapan, dan mengapa arsitektur penting?
Apa Itu Terjemahan Ucapan Waktu Nyata?
Terjemahan ucapan-ke-ucapan (S2ST) adalah teknologi yang menerima bahasa lisan dan menghasilkan keluaran lisan dalam bahasa lain.
Dalam sistem langsung, proses ini terjadi terus-menerus saat orang-orang sedang melakukan percakapan.
Sebagai contoh:
Seseorang berbicara dalam bahasa Ukraina.
Peserta lain ingin mendengar bahasa Inggris.
Sistem mendengarkan ucapan Ukraina, memahami maknanya, menerjemahkannya, dan menghasilkan audio bahasa Inggris untuk pendengar.
Tujuannya bukan hanya menerjemahkan kata-kata.
Tujuannya adalah membuat komunikasi antara orang-orang yang berbicara bahasa berbeda terasa sedekat mungkin dengan percakapan normal.
Perbedaan ini menjadi penting ketika kami membandingkan sistem ucapan-ke-ucapan modern dengan saluran terjemahan suara tradisional.
Pendekatan Tradisional: STT → Terjemahan → TTS
Selama bertahun-tahun, sistem terjemahan suara telah dibangun dari beberapa teknologi terpisah.
Arsitekturnya biasanya terlihat seperti ini:
1. Ucapan-ke-Teks (STT)
Audio pembicara diubah menjadi teks tertulis.
↓
2. Terjemahan Mesin (MT)
Teks tertulis diterjemahkan ke bahasa lain.
↓
3. Teks-ke-Ucapan (TTS)
Teks terjemahan diubah kembali menjadi ucapan buatan.
Saluran lengkapnya menjadi:
Audio → STT → Teks → Terjemahan → Teks → TTS → Audio
Arsitektur ini berfungsi.
Sebenarnya, ini telah mendukung banyak sistem terjemahan ucapan selama bertahun-tahun.
Ini juga berguna ketika tujuan utamanya adalah transkripsi, subtitle, catatan pertemuan yang dapat dicari, atau situasi di mana pengembang membutuhkan kontrol penuh atas setiap tahap pemrosesan.
Namun percakapan manusia langsung memperkenalkan persyaratan lain:
kecepatan.
Mengapa Saluran Terjemahan Berjenjang Dapat Terasa Lambat
Setiap langkah dalam saluran terjemahan suara tradisional membutuhkan waktu.
Sistem pengenalan ucapan membutuhkan cukup audio untuk memahami apa yang dikatakan.
Kemudian sistem terjemahan memproses teks yang dihasilkan.
Kemudian sistem teks-ke-ucapan menghasilkan aliran audio baru.
Setiap komponen individual mungkin cepat.
Namun penundaan mereka dapat terakumulasi.
Ada masalah lain.
Setiap tahap bergantung pada keluaran tahap sebelumnya.
Jika pengenalan ucapan salah memahami kata, model terjemahan menerima teks yang salah.
Jika terjemahan mengubah makna, sistem TTS hanya berbicara teks terjemahan itu.
Dengan kata lain, kesalahan dapat menyebar melalui saluran:
Kesalahan pengenalan ucapan → kesalahan terjemahan → kesalahan terjemahan lisan
Selama terjemahan dokumen ini mungkin dapat diterima.
Selama percakapan langsung, bahkan beberapa detik ekstra atau jeda yang canggung dapat sepenuhnya mengubah cara komunikasi terasa.
Orang berhenti berbicara secara alami.
Mereka menunggu.
Mereka memeriksa apakah terjemahan telah selesai.
Kemudian orang lain merespons.
Alih-alih percakapan, komunikasi mulai terasa seperti bergantian dengan mesin.
Terjemahan Ucapan Waktu Nyata Asli Mengubah Arsitektur
Model AI multimodal modern dapat bekerja dengan input audio dan output audio dalam interaksi waktu nyata yang sama.
Alih-alih mengharuskan pengembang untuk menghubungkan tiga sistem independen untuk setiap frasa yang diucapkan, model waktu nyata dapat terus-menerus memproses audio masuk dan menghasilkan keluaran lisan.
Dari perspektif pengguna, alurnya menjadi jauh lebih dekat dengan:
Ucapan → pemahaman dan terjemahan AI → Ucapan
Ini umumnya disebut sebagai terjemahan ucapan waktu nyata.
Perbedaan penting bukan bahwa teks tidak pernah dapat ada di mana pun di dalam model AI.
Model modern mungkin menggunakan banyak representasi internal.
Perbedaannya adalah arsitektur:
Percakapan langsung tidak harus menunggu layanan transkripsi terpisah, kemudian layanan terjemahan teks terpisah, dan kemudian layanan sintesis ucapan terpisah sebelum audio terjemahan dapat dimulai.
Itu membuat jenis interaksi yang sangat berbeda menjadi mungkin.
"Waktu Nyata" Tidak Selalu Berarti Hal yang Sama
Istilah terjemahan waktu nyata digunakan secara luas di seluruh industri.
Produk secara teknis dapat menyebut dirinya waktu nyata jika menghasilkan terjemahan beberapa detik setelah seseorang berbicara.
Untuk subtitle, itu mungkin sangat dapat diterima.
Namun percakapan manusia jauh lebih sensitif terhadap penundaan.
Pertimbangkan dua pengalaman.
Pengalaman A: Terjemahan Berjenjang
Anda berbicara.
Sistem menunggu cukup audio.
Ucapan Anda menjadi teks.
Teks diterjemahkan.
Teks terjemahan dikirim ke pembuat suara.
Peserta lain mendengar terjemahan.
Kemudian mereka merespons.
Pengalaman B: Terjemahan Ucapan Waktu Nyata
Anda mulai berbicara.
Model memproses aliran audio sebagai bagian dari sesi berkelanjutan.
Ini memahami percakapan yang sedang berlangsung dan mulai menghasilkan ucapan terjemahan dengan ketergantungan yang jauh lebih rendah pada tahap pemrosesan terpisah.
Percakapan menjadi lebih dekat dengan pergantian alami.
Kedua sistem secara teknis dapat dijelaskan sebagai "waktu nyata."
Namun pengalamannya bisa sangat berbeda.
Mengapa Latensi Lebih Penting Daripada Sebagian Besar Tolok Ukur Terjemahan
Produk terjemahan sering dievaluasi berdasarkan akurasi.
Akurasi jelas penting.
Namun selama komunikasi langsung ada dimensi lain yang sama pentingnya:
latensi percakapan.
Bayangkan rapat bisnis dengan enam orang berbicara dalam beberapa bahasa.
Jika setiap kalimat terjemahan memperkenalkan beberapa detik keheningan, penundaan itu berlipat ganda di seluruh rapat.
Peserta mulai mengganggu terjemahan.
Beberapa orang mulai berbicara sebelum terjemahan sebelumnya selesai.
Yang lain berhenti berpartisipasi karena mengikuti percakapan menjadi sulit.
Terjemahan itu sendiri mungkin benar sementara pengalaman rapat masih buruk.
Untuk komunikasi multibahasa langsung, kualitas terjemahan oleh karena itu tidak dapat diukur hanya dengan apakah kata-katanya benar.
Ini juga harus mempertimbangkan:
seberapa cepat ucapan terjemahan dimulai;
seberapa alami peserta dapat bergantian;
apakah gangguan dapat ditangani;
apakah sistem memahami konteks percakapan;
apakah pengguna perlu menunggu kalimat lengkap;
seberapa baik percakapan mengalir di berbagai bahasa.
Inilah mengapa teknologi terjemahan ucapan waktu nyata sangat penting untuk pertemuan.
Ucapan Berisi Lebih Dari Sekadar Kata-Kata
Keterbatasan lain dari mengubah ucapan menjadi teks biasa adalah bahwa ucapan manusia berisi informasi yang sulit direpresentasikan sepenuhnya dalam transkrip.
Orang berkomunikasi melalui:
nada;
ritme;
jeda;
penekanan;
keraguan;
kecepatan berbicara;
konteks percakapan.
Sistem STT tradisional pertama-tama mengompresi pesan lisan menjadi teks.
Beberapa informasi dari audio asli dapat hilang sebelum terjemahan bahkan dimulai.
Model ucapan-ke-ucapan modern dapat bekerja langsung dengan audio dan memiliki akses ke lebih banyak sinyal ucapan asli.
Ini tidak berarti setiap nuansa akan selalu bertahan dalam terjemahan.
Namun ini menciptakan kemungkinan interaksi suara yang jauh lebih alami daripada sistem yang dibangun hanya di sekitar teks.
Terjemahan Ucapan-ke-Ucapan vs Terjemahan Ucapan-ke-Teks
Teknologi ini kadang-kadang membingungkan, tetapi mereka menyelesaikan masalah yang berbeda.
Terjemahan ucapan-ke-teks mengubah bahasa lisan menjadi teks terjemahan.
Sebagai contoh:
Ucapan Jepang → subtitle Inggris
Ini sangat berguna untuk caption dan aksesibilitas.
Terjemahan ucapan-ke-ucapan menghasilkan audio terjemahan:
Ucapan Jepang → ucapan Inggris
Ini memungkinkan pendengar mengikuti percakapan tanpa terus-menerus membaca subtitle.
Voicli mendukung subtitle langsung sebagai bagian dari pengalaman pertemuan, tetapi terjemahan suara dirancang untuk sesuatu yang lebih luas: memungkinkan orang untuk benar-benar berbicara lintas bahasa, bukan hanya membaca terjemahan apa yang dikatakan orang lain.
Mengapa Voicli Menggunakan Terjemahan Ucapan Waktu Nyata
Voicli dibangun di sekitar ide sederhana:
Orang harus dapat bergabung dengan rapat yang sama dan berbicara dalam bahasa yang paling mereka nyaman.
Satu peserta mungkin berbicara bahasa Ukraina.
Yang lain mungkin berbicara bahasa Jepang.
Yang lain mungkin lebih suka bahasa Inggris.
Yang lain mungkin berbicara bahasa Korea.
Alih-alih memaksa semua orang untuk beralih ke bahasa kedua yang sama, Voicli menangani terjemahan selama percakapan.
Setiap peserta dapat memilih bahasa yang ingin mereka dengarkan.
Platform dapat menyediakan suara terjemahan, subtitle, atau audio asli tergantung pada preferensi pendengar.
Untuk terjemahan suara langsung, Voicli menggunakan arsitektur ucapan-ke-ucapan waktu nyata daripada mengandalkan secara eksklusif pada:
STT → terjemahan teks → TTS
saluran untuk setiap ucapan terjemahan.
Perbedaan arsitektur itu penting karena Voicli tidak mencoba membangun alat transkripsi yang kebetulan berbicara teks terjemahan.
Tujuannya adalah membangun lapisan komunikasi multibahasa untuk percakapan nyata.
Kapan STT + Terjemahan + TTS Masih Solusi yang Tepat
Teknologi ucapan-ke-ucapan tidak membuat saluran tradisional usang.
Ada banyak situasi di mana STT → terjemahan → TTS berguna atau bahkan lebih disukai.
Sebagai contoh:
Transkrip pertemuan membutuhkan teks yang akurat.
Riwayat percakapan yang dapat dicari memerlukan representasi teks.
Subtitle secara alami bergantung pada transkripsi.
Sistem kepatuhan mungkin perlu menyimpan dengan tepat apa yang dikenali.
Terjemahan asinkron tidak memerlukan latensi yang sangat rendah.
Alur kerja khusus mungkin memerlukan pengembang untuk memeriksa dan memodifikasi setiap tahap perantara.
Itulah mengapa Voicli juga menggunakan teknologi AI yang berbeda tergantung pada tugasnya.
Kuncinya adalah memilih arsitektur yang tepat untuk pengalaman yang sedang dibangun.
Untuk transkrip, teks adalah produknya.
Untuk percakapan multibahasa langsung, percakapan itu sendiri adalah produknya.
Dari Alat Terjemahan ke Percakapan Multibahasa
Selama beberapa dekade, terjemahan mesin terutama tentang mengubah informasi dari satu bahasa ke bahasa lain.
Pertama dokumen.
Kemudian situs web.
Kemudian pesan.
Kemudian subtitle.
Terjemahan ucapan waktu nyata mewakili arah yang berbeda.
Alih-alih bertanya:
"Seberapa cepat kita dapat menerjemahkan kalimat ini?"
pertanyaan yang lebih penting menjadi:
"Bisakah dua orang yang berbicara bahasa berbeda berkomunikasi secara alami?"
Itu mengubah cara sistem terjemahan perlu dirancang.
Latensi menjadi kritis.
Pergantian giliran menjadi kritis.
Kualitas audio menjadi kritis.
Konteks menjadi kritis.
Dan terjemahan menjadi bagian dari infrastruktur komunikasi daripada alat terpisah yang orang gunakan secara sadar.
Masa Depan Pertemuan Multibahasa
Tujuan jangka panjang terjemahan ucapan bukan untuk membuat orang berpikir tentang teknologi terjemahan lebih sering.
Ini adalah kebalikannya.
Terjemahan harus secara bertahap menghilang ke dalam percakapan.
Anda berbicara bahasa Anda.
Orang lain berbicara bahasa mereka.
Dan teknologi menangani apa yang terjadi di antara Anda.
Masih akan ada tantangan.
Aksen, kebisingan latar belakang, terminologi khusus domain, pembicara yang tumpang tindih, nama, dan konteks budaya semuanya dapat mempengaruhi terjemahan AI.
Namun model multimodal waktu nyata mengubah apa yang secara teknis mungkin.
Kami bergerak dari:
rekam → transkripsi → terjemahan → sintesis → dengarkan
menuju:
berbicara → pahami → terjemahkan → dengarkan
Dan pada akhirnya, teknologi terjemahan yang paling sukses mungkin adalah teknologi yang peserta hampir tidak perhatikan.
Terjemahan Waktu Nyata Harus Terasa Seperti Komunikasi
Memanggil produk "waktu nyata" mudah.
Membuat komunikasi multibahasa benar-benar terasa waktu nyata jauh lebih sulit.
Perbedaannya bukan hanya milidetik pada tolok ukur.
Ini adalah apakah orang dapat berbicara secara alami.
Apakah mereka dapat merespons tanpa menunggu.
Apakah rapat multibahasa terasa seperti percakapan daripada urutan pesan terjemahan.
Itulah masalah yang sedang dikerjakan Voicli.
Terjemahan ucapan waktu nyata untuk percakapan di mana semua orang dapat berbicara dalam bahasa mereka sendiri.
Pertanyaan yang Sering Diajukan
Apa itu terjemahan ucapan-ke-ucapan?
Terjemahan ucapan-ke-ucapan mengubah bahasa lisan secara langsung menjadi keluaran lisan dalam bahasa lain. Sistem AI modern dapat memproses input audio dan menghasilkan audio terjemahan dalam sesi waktu nyata.
Apa perbedaan antara terjemahan ucapan-ke-ucapan dan terjemahan ucapan-ke-teks?
Terjemahan ucapan-ke-teks menghasilkan teks tertulis terjemahan, seperti subtitle. Terjemahan ucapan-ke-ucapan menghasilkan audio terjemahan yang dapat didengar pendengar.
Bagaimana terjemahan suara tradisional bekerja?
Sistem tradisional umumnya menggunakan tiga tahap: pengenalan ucapan-ke-teks, terjemahan mesin, dan sintesis teks-ke-ucapan. Ini sering disebut arsitektur terjemahan ucapan berjenjang.
Mengapa STT → terjemahan → TTS dapat memiliki latensi yang lebih tinggi?
Setiap tahap harus memproses informasi dan meneruskan keluarannya ke komponen berikutnya. Waktu pemrosesan yang terakumulasi dapat memperkenalkan penundaan tambahan, sementara kesalahan dari satu tahap juga dapat mempengaruhi tahap berikutnya.
Apakah terjemahan ucapan-ke-ucapan sama dengan interpretasi simultan?
Mereka adalah konsep terkait tetapi tidak identik. Interpretasi simultan manusia dilakukan oleh penerjemah profesional. Terjemahan ucapan-ke-ucapan AI mencoba memberikan pengalaman komunikasi multibahasa dengan penundaan rendah yang serupa secara otomatis.
Bisakah terjemahan ucapan-ke-ucapan digunakan untuk rapat bisnis?
Ya. Terjemahan ucapan waktu nyata sangat berguna untuk rapat internasional, panggilan pelanggan, percakapan penjualan, tim jarak jauh, wawancara, dan situasi lain di mana peserta tidak berbagi bahasa yang sama.
Apa yang dilakukan Voicli?
Voicli adalah platform komunikasi video multibahasa dengan terjemahan suara waktu nyata dan subtitle langsung. Peserta dapat berbicara dalam bahasa pilihan mereka sementara Voicli menangani terjemahan selama percakapan.
Coba Voicli dan berbicara dalam bahasa Anda. Biarkan rapat menangani terjemahannya.