Traduzione vocale in tempo reale da voce a voce: perché non tutta la traduzione vocale "in tempo reale" è uguale
Key Takeaways
- La traduzione da voce a voce in tempo reale elabora l'audio direttamente, mentre i sistemi tradizionali convertono il discorso in testo, lo traducono e lo riconvertono in voce, introducendo latenza aggiuntiva.
- Ogni fase in una pipeline STT → traduzione → TTS accumula ritardi e gli errori di una fase possono propagarsi alle fasi successive, influenzando la qualità della traduzione finale.
- Per le conversazioni multilingue dal vivo, la latenza è critica quanto l'accuratezza della traduzione, poiché i ritardi eccessivi rendono difficile il turno naturale e la comunicazione fluida.
- Il discorso umano contiene informazioni come tono, ritmo, enfasi e contesto che vengono perse quando il discorso viene convertito in testo semplice prima della traduzione.
- La traduzione da voce a voce è progettata per le conversazioni dal vivo, mentre la traduzione da voce a testo è più adatta per sottotitoli e trascrizioni.
- Voicli utilizza l'architettura di traduzione da voce a voce in tempo reale per consentire ai partecipanti di parlare naturalmente nelle loro lingue preferite durante le riunioni multilingue.
- I sistemi STT → traduzione → TTS rimangono utili per trascrizioni, sottotitoli, conformità e situazioni in cui il testo è il prodotto finale desiderato.
La traduzione vocale in tempo reale sta diventando una funzione comune nelle piattaforme di riunioni, negli strumenti di comunicazione e nelle applicazioni di intelligenza artificiale.
Ma c'è un dettaglio importante che spesso si nasconde dietro le parole "traduzione in tempo reale."
Due prodotti possono entrambi affermare di tradurre il discorso in tempo reale mentre utilizzano tecnologie molto diverse sotto il cofano.
Uno potrebbe elaborare una conversazione così:
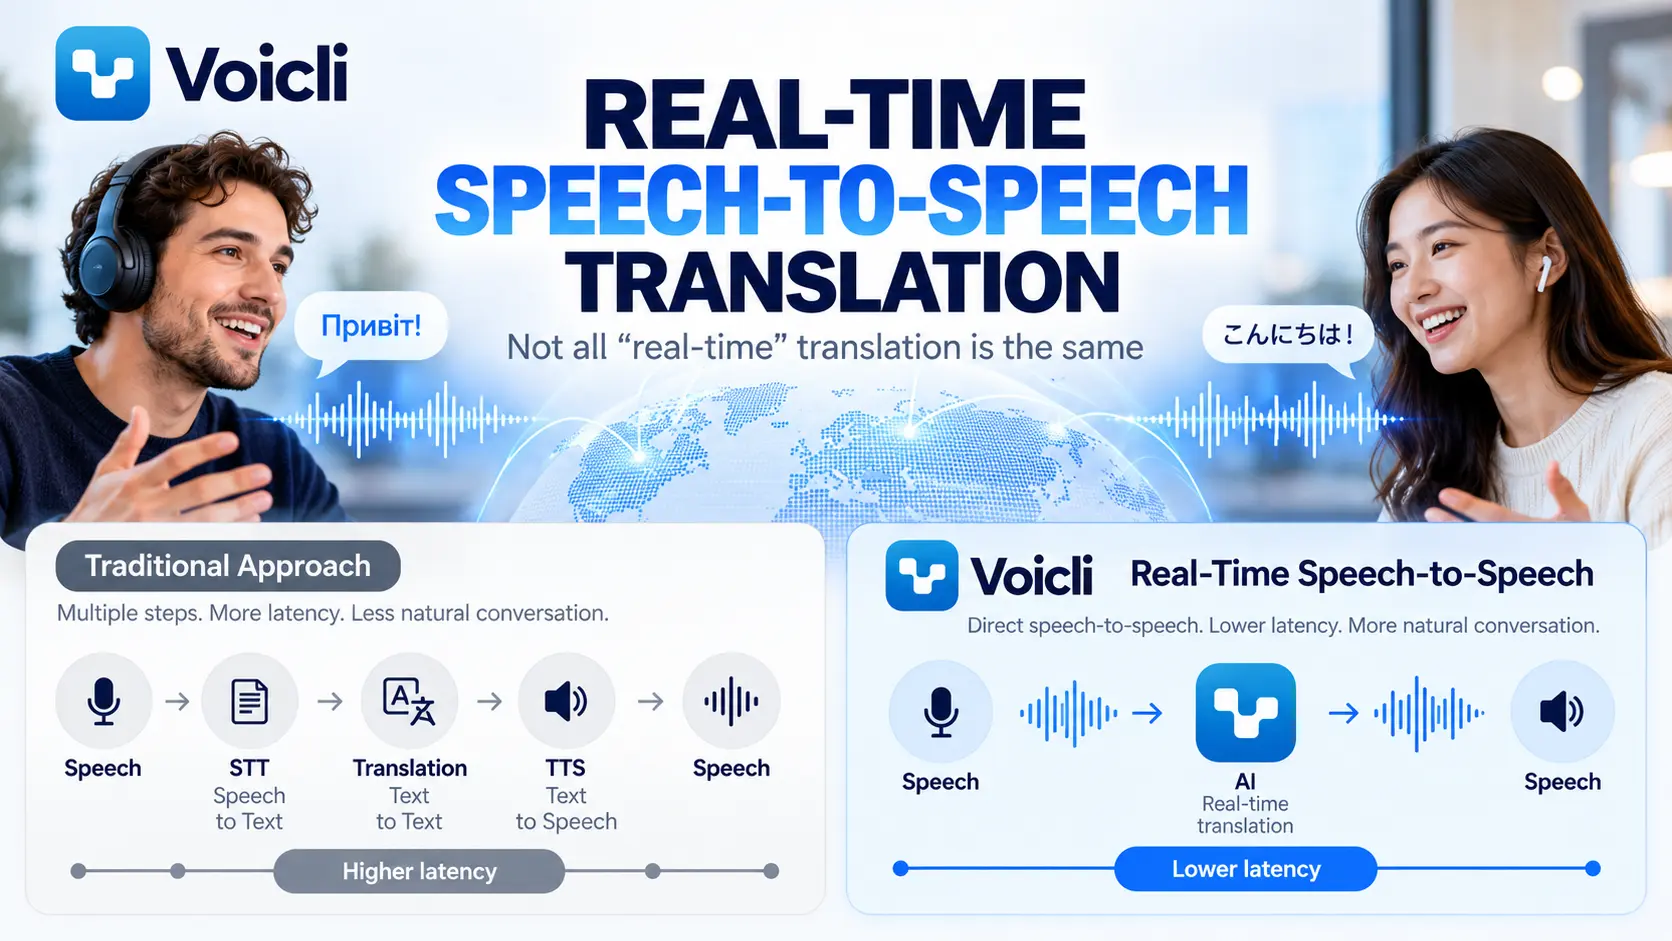
Voce → trascrizione → traduzione del testo → sintesi vocale → audio tradotto
Un altro può elaborare l'interazione come un'esperienza continua di traduzione da voce a voce, dove l'audio viene compreso e tradotto direttamente all'interno di un modello multimodale in tempo reale.
Entrambi gli approcci possono produrre discorsi tradotti.
Ma non creano necessariamente la stessa esperienza di conversazione.
In Voicli, la nostra traduzione vocale dal vivo è progettata attorno alla traduzione vocale in tempo reale da voce a voce, consentendo ai partecipanti di parlare naturalmente nelle loro lingue mentre il discorso tradotto viene generato per le persone che ascoltano.
Allora, cos'è esattamente la traduzione da voce a voce e perché l'architettura è importante?
Cos'è la traduzione vocale in tempo reale da voce a voce?
La traduzione da voce a voce (S2ST) è una tecnologia che riceve il linguaggio parlato e produce un output vocale in un'altra lingua.
In un sistema dal vivo, questo processo avviene continuamente mentre le persone stanno avendo una conversazione.
Ad esempio:
Una persona parla ucraino.
Un altro partecipante vuole ascoltare l'inglese.
Il sistema ascolta il discorso ucraino, ne comprende il significato, lo traduce e genera audio in inglese per l'ascoltatore.
L'obiettivo non è semplicemente tradurre le parole.
L'obiettivo è rendere la comunicazione tra persone che parlano lingue diverse il più possibile simile a una conversazione normale.
Questa distinzione diventa importante quando confrontiamo i moderni sistemi da voce a voce con le pipeline tradizionali di traduzione vocale.
L'approccio tradizionale: STT → Traduzione → TTS
Per molti anni, i sistemi di traduzione vocale sono stati costruiti da diverse tecnologie separate.
L'architettura di solito è così:
1. Riconoscimento vocale (STT)
L'audio del parlante viene convertito in testo scritto.
↓
2. Traduzione automatica (MT)
Il testo scritto viene tradotto in un'altra lingua.
↓
3. Sintesi vocale (TTS)
Il testo tradotto viene riconvertito in discorso artificiale.
La pipeline completa diventa:
Audio → STT → Testo → Traduzione → Testo → TTS → Audio
Questa architettura funziona.
In realtà, ha alimentato molti sistemi di traduzione vocale per anni.
È anche utile quando l'obiettivo principale è la trascrizione, i sottotitoli, le note di riunione ricercabili, o situazioni in cui gli sviluppatori hanno bisogno di un controllo completo su ogni fase di elaborazione.
Ma la conversazione umana dal vivo introduce un altro requisito:
velocità.
Perché una pipeline di traduzione a cascata può sembrare lenta
Ogni fase in una pipeline tradizionale di traduzione vocale richiede tempo.
Il sistema di riconoscimento vocale ha bisogno di abbastanza audio per capire cosa è stato detto.
Poi il sistema di traduzione elabora il testo risultante.
Poi il sistema di sintesi vocale genera un nuovo flusso audio.
Ogni singolo componente potrebbe essere veloce.
Ma i loro ritardi possono accumularsi.
C'è un altro problema.
Ogni fase dipende dall'output della fase precedente.
Se il riconoscimento vocale fraintende una parola, il modello di traduzione riceve il testo sbagliato.
Se la traduzione cambia il significato, il sistema TTS semplicemente pronuncia quel testo tradotto.
In altre parole, gli errori possono propagarsi attraverso la pipeline:
Errore di riconoscimento vocale → errore di traduzione → errore di traduzione vocale
Durante la traduzione di documenti questo potrebbe essere accettabile.
Durante una conversazione dal vivo, anche pochi secondi in più o una pausa imbarazzante possono cambiare completamente il modo in cui la comunicazione si sente.
Le persone smettono di parlare naturalmente.
Aspettano.
Controllano se la traduzione è finita.
Poi l'altra persona risponde.
Invece di una conversazione, la comunicazione inizia a sembrare come fare a turni con una macchina.
La traduzione da voce a voce nativa in tempo reale cambia l'architettura
I moderni modelli di intelligenza artificiale multimodale possono funzionare con input audio e output audio all'interno della stessa interazione in tempo reale.
Invece di richiedere agli sviluppatori di connettere tre sistemi indipendenti per ogni frase pronunciata, un modello in tempo reale può elaborare continuamente l'audio in arrivo e generare output vocale.
Dal punto di vista dell'utente, il flusso diventa molto più vicino a:
Voce → Comprensione e traduzione dell'IA → Voce
Questo è generalmente indicato come traduzione vocale in tempo reale da voce a voce.
La distinzione importante non è che il testo non possa mai esistere da nessuna parte all'interno di un modello di IA.
I moderni modelli possono utilizzare molte rappresentazioni interne.
La differenza è architettonica:
La conversazione dal vivo non deve aspettare un servizio di trascrizione separato, poi un servizio di traduzione del testo separato e poi un servizio di sintesi vocale separato prima che l'audio tradotto possa iniziare.
Questo rende possibile un tipo di interazione molto diverso.
"In tempo reale" non significa sempre la stessa cosa
Il termine traduzione in tempo reale è utilizzato ampiamente in tutto il settore.
Un prodotto può tecnicamente definirsi in tempo reale se genera una traduzione pochi secondi dopo che qualcuno parla.
Per i sottotitoli, questo potrebbe essere perfettamente accettabile.
Ma la conversazione umana è molto più sensibile al ritardo.
Considera due esperienze.
Esperienza A: Traduzione a cascata
Parli.
Il sistema aspetta abbastanza audio.
Il tuo discorso diventa testo.
Il testo viene tradotto.
Il testo tradotto viene inviato a un generatore vocale.
L'altro partecipante ascolta la traduzione.
Poi rispondono.
Esperienza B: Traduzione vocale in tempo reale da voce a voce
Inizi a parlare.
Il modello elabora il flusso audio come parte di una sessione continua.
Comprende la conversazione in corso e inizia a generare discorsi tradotti con una dipendenza significativamente inferiore da fasi di elaborazione separate.
La conversazione diventa più vicina al turno naturale.
Entrambi i sistemi possono tecnicamente essere descritti come "in tempo reale".
Ma l'esperienza può essere molto diversa.
Perché la latenza è più importante della maggior parte dei benchmark di traduzione
I prodotti di traduzione sono spesso valutati in base all'accuratezza.
L'accuratezza è ovviamente importante.
Ma durante la comunicazione dal vivo c'è un'altra dimensione altrettanto importante:
la latenza della conversazione.
Immagina una riunione d'affari con sei persone che parlano diverse lingue.
Se ogni frase tradotta introduce diversi secondi di silenzio, questi ritardi si moltiplicano durante la riunione.
I partecipanti iniziano a interrompere le traduzioni.
Alcune persone iniziano a parlare prima che le traduzioni precedenti siano finite.
Altri smettono di partecipare perché seguire la conversazione diventa difficile.
La traduzione stessa potrebbe essere corretta mentre l'esperienza della riunione è ancora scarsa.
Per la comunicazione multilingue dal vivo, la qualità della traduzione non può quindi essere misurata solo dal fatto che le parole siano corrette.
Dovrebbe anche considerare:
quanto velocemente inizia il discorso tradotto;
quanto naturalmente i partecipanti possono fare a turni;
se gli interruzioni possono essere gestite;
se il sistema comprende il contesto conversazionale;
se gli utenti devono aspettare frasi complete;
quanto bene la conversazione scorre tra più lingue.
Questo è il motivo per cui la tecnologia di traduzione vocale in tempo reale da voce a voce è particolarmente importante per le riunioni.
Il discorso contiene più delle parole
Un'altra limitazione della conversione del discorso in testo semplice è che il discorso umano contiene informazioni difficili da rappresentare completamente in una trascrizione.
Le persone comunicano attraverso:
tono;
ritmo;
pause;
enfasi;
esitazione;
velocità di parola;
contesto conversazionale.
I sistemi STT tradizionali comprimono prima il messaggio parlato in testo.
Alcune informazioni dall'audio originale possono quindi andare perse prima ancora che inizi la traduzione.
I moderni modelli da voce a voce possono funzionare direttamente con l'audio e hanno accesso a più del segnale vocale originale.
Questo non significa che ogni sfumatura sopravvivrà sempre alla traduzione.
Ma crea la possibilità di interazioni vocali molto più naturali rispetto ai sistemi costruiti solo attorno al testo.
Traduzione da voce a voce rispetto a traduzione da voce a testo
Queste tecnologie a volte vengono confuse, ma risolvono problemi diversi.
La traduzione da voce a testo converte il linguaggio parlato in testo tradotto.
Ad esempio:
Discorso giapponese → Sottotitoli in inglese
Questo è estremamente utile per didascalie e accessibilità.
La traduzione da voce a voce produce audio tradotto:
Discorso giapponese → Discorso in inglese
Questo consente all'ascoltatore di seguire la conversazione senza leggere costantemente i sottotitoli.
Voicli supporta sottotitoli dal vivo come parte dell'esperienza di riunione, ma la traduzione vocale è progettata per qualcosa di più ampio: consentire alle persone di effettivamente comunicare tra lingue, piuttosto che semplicemente leggere traduzioni di ciò che altri hanno detto.
Perché Voicli utilizza la traduzione vocale in tempo reale da voce a voce
Voicli è stato costruito attorno a un'idea semplice:
Le persone dovrebbero essere in grado di partecipare alla stessa riunione e parlare la lingua in cui si sentono più a loro agio.
Un partecipante potrebbe parlare ucraino.
Un altro potrebbe parlare giapponese.
Un altro potrebbe preferire l'inglese.
Un altro potrebbe parlare coreano.
Invece di costringere tutti a passare a una lingua seconda comune, Voicli gestisce la traduzione durante la conversazione.
Ogni partecipante può selezionare la lingua che vuole ascoltare.
La piattaforma può fornire voce tradotta, sottotitoli o l'audio originale a seconda della preferenza dell'ascoltatore.
Per la traduzione vocale dal vivo, Voicli utilizza un'architettura di traduzione vocale in tempo reale da voce a voce piuttosto che affidarsi esclusivamente alla tradizionale:
STT → traduzione del testo → TTS
pipeline per ogni enunciato tradotto.
Quella differenza architettonica è importante perché Voicli non sta cercando di costruire uno strumento di trascrizione che casualmente parli testo tradotto.
L'obiettivo è costruire un livello di comunicazione multilingue per conversazioni reali.
Quando STT + Traduzione + TTS è ancora la soluzione giusta
La tecnologia da voce a voce non rende obsolete le pipeline tradizionali.
Ci sono molte situazioni in cui STT → traduzione → TTS è utile o addirittura preferibile.
Ad esempio:
I trascritti delle riunioni hanno bisogno di testo accurato.
La cronologia delle conversazioni ricercabile richiede una rappresentazione testuale.
I sottotitoli dipendono naturalmente dalla trascrizione.
I sistemi di conformità potrebbero aver bisogno di archiviare esattamente ciò che è stato riconosciuto.
La traduzione asincrona non richiede una latenza estremamente bassa.
I flussi di lavoro specializzati potrebbero aver bisogno che gli sviluppatori ispezionino e modifichino ogni fase intermedia.
Ecco perché Voicli utilizza anche diverse tecnologie di IA a seconda dell'attività.
La chiave è scegliere l'architettura corretta per l'esperienza che si sta costruendo.
Per una trascrizione, il testo è il prodotto.
Per una conversazione multilingue dal vivo, la conversazione stessa è il prodotto.
Dagli strumenti di traduzione alle conversazioni multilingue
Per decenni, la traduzione automatica è stata principalmente una questione di conversione delle informazioni da una lingua all'altra.
Prima i documenti.
Poi i siti web.
Poi i messaggi.
Poi i sottotitoli.
La traduzione vocale in tempo reale da voce a voce rappresenta una direzione diversa.
Invece di chiedere:
"Quanto velocemente possiamo tradurre questa frase?"
la domanda più importante diventa:
"Due persone che parlano lingue diverse possono comunicare naturalmente?"
Questo cambia il modo in cui i sistemi di traduzione devono essere progettati.
La latenza diventa critica.
Il turno diventa critico.
La qualità dell'audio diventa critica.
Il contesto diventa critico.
E la traduzione diventa parte dell'infrastruttura di comunicazione piuttosto che uno strumento separato che le persone usano consapevolmente.
Il futuro delle riunioni multilingue
L'obiettivo a lungo termine della traduzione vocale non è far pensare alle persone più spesso alla tecnologia di traduzione.
È il contrario.
La traduzione dovrebbe gradualmente scomparire nella conversazione.
Tu parli la tua lingua.
L'altra persona parla la sua.
E la tecnologia gestisce ciò che accade tra voi.
Ci saranno ancora sfide.
Gli accenti, il rumore di fondo, la terminologia specifica del dominio, i parlanti sovrapposti, i nomi e il contesto culturale possono tutti influenzare la traduzione dell'IA.
Ma i modelli multimodali in tempo reale stanno cambiando ciò che è tecnicamente possibile.
Ci stiamo muovendo da:
registra → trascrivi → traduci → sintetizza → ascolta
verso:
parla → comprendi → traduci → ascolta
E alla fine, la tecnologia di traduzione più riuscita potrebbe essere la tecnologia che i partecipanti difficilmente notano.
La traduzione in tempo reale dovrebbe sembrare comunicazione
Chiamare un prodotto "in tempo reale" è facile.
Rendere la comunicazione multilingue effettivamente in tempo reale è molto più difficile.
La differenza non è solo millisecondi su un benchmark.
È se le persone possono parlare naturalmente.
Se possono rispondere senza aspettare.
Se una riunione multilingue sembra una conversazione piuttosto che una sequenza di messaggi tradotti.
Questo è il problema su cui Voicli sta lavorando.
Traduzione vocale in tempo reale da voce a voce per conversazioni dove tutti possono parlare la loro lingua.
Domande frequenti
Cos'è la traduzione da voce a voce?
La traduzione da voce a voce converte il linguaggio parlato direttamente in output vocale in un'altra lingua. I moderni sistemi di IA possono elaborare input audio e generare audio tradotto all'interno di una sessione in tempo reale.
Qual è la differenza tra traduzione da voce a voce e da voce a testo?
La traduzione da voce a testo produce testo scritto tradotto, come i sottotitoli. La traduzione da voce a voce produce audio tradotto che l'ascoltatore può ascoltare.
Come funziona la traduzione vocale tradizionale?
I sistemi tradizionali comunemente utilizzano tre fasi: riconoscimento da voce a testo, traduzione automatica e sintesi da testo a voce. Questo è spesso chiamato architettura di traduzione vocale a cascata.
Perché STT → traduzione → TTS può avere una latenza più elevata?
Ogni fase deve elaborare le informazioni e passare il suo output al componente successivo. Il tempo di elaborazione accumulato può introdurre ritardi aggiuntivi, mentre gli errori di una fase possono anche influenzare le fasi successive.
La traduzione da voce a voce è la stessa dell'interpretazione simultanea?
Sono concetti correlati ma non identici. L'interpretazione simultanea umana è eseguita da interpreti professionisti. La traduzione vocale da voce a voce dell'IA tenta di fornire automaticamente un'esperienza di comunicazione multilingue a bassa latenza simile.
La traduzione da voce a voce può essere utilizzata per riunioni aziendali?
Sì. La traduzione vocale in tempo reale da voce a voce è particolarmente utile per riunioni internazionali, chiamate con clienti, conversazioni di vendita, team remoti, interviste e altre situazioni in cui i partecipanti non condividono la stessa lingua.
Cosa fa Voicli?
Voicli è una piattaforma di comunicazione video multilingue con traduzione vocale in tempo reale e sottotitoli dal vivo. I partecipanti possono parlare le loro lingue preferite mentre Voicli gestisce la traduzione durante la conversazione.
Prova Voicli e parla la tua lingua. Lascia che la riunione gestisca la traduzione.