リアルタイム音声間翻訳:すべての「リアルタイム」音声翻訳が同じではない理由
Key Takeaways
- リアルタイム音声間翻訳は、従来のSTT→翻訳→TTSパイプラインとは異なるアーキテクチャを使用し、より低いレイテンシーと自然な会話フローを実現します。
- 音声テキスト翻訳は字幕を生成しますが、音声間翻訳はリスナーが聞くことができる翻訳音声を生成します。
- ライブ多言語会話では、翻訳の精度だけでなく、レイテンシー、ターンテイキング、オーディオ品質、コンテキスト理解も重要です。
- 従来のSTT→翻訳→TTSパイプラインは、会議トランスクリプト、字幕、検索可能な会話履歴などの特定の用途に対して依然として有用です。
- Voicliのリアルタイム音声間翻訳は、参加者が自分の言語で自然に話すことができ、翻訳が会話に統合される多言語コミュニケーション体験を実現します。
リアルタイム音声翻訳は、会議プラットフォーム、コミュニケーションツール、AIアプリケーションの一般的な機能になりつつあります。
しかし、「リアルタイム翻訳」という言葉の背後に隠されている重要な詳細があります。
2つの製品は、どちらも音声をリアルタイムで翻訳すると言っていても、その下で非常に異なるテクノロジーを使用している場合があります。
一方は、次のように会話を処理する場合があります:
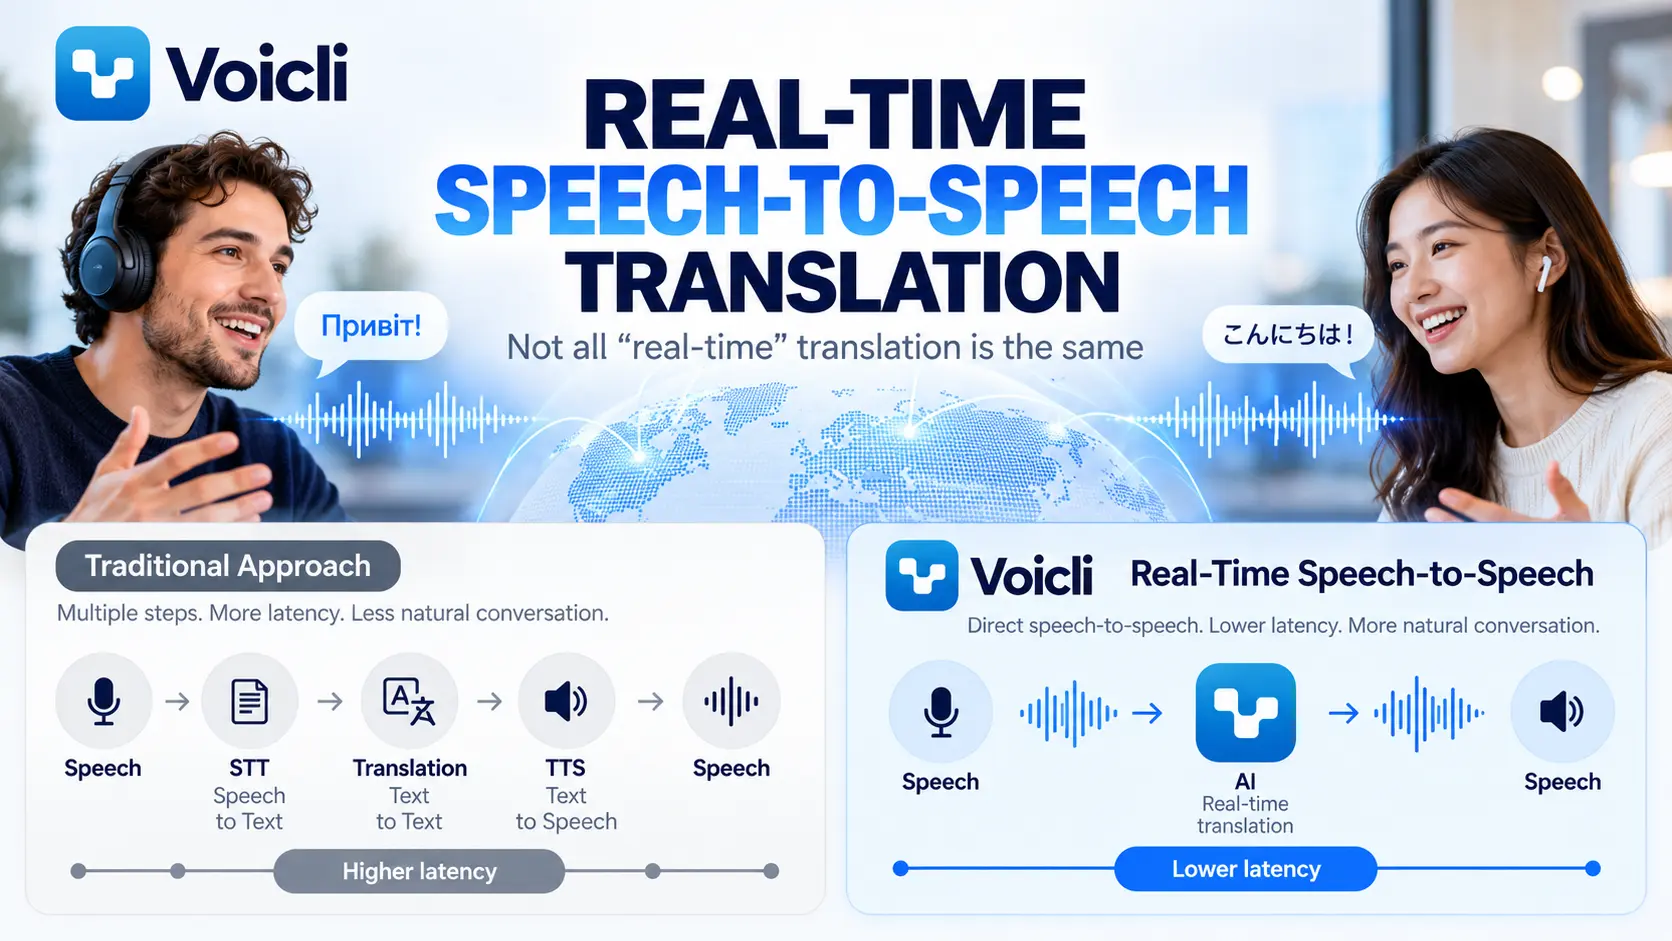
音声→文字起こし→テキスト翻訳→テキスト音声合成→翻訳音声
もう一方は、継続的な音声間翻訳体験として相互作用を処理でき、オーディオはリアルタイムマルチモーダルモデル内で直接理解および翻訳されます。
どちらのアプローチも翻訳音声を生成できます。
しかし、必ずしも同じ会話体験を作成するわけではありません。
Voicliでは、ライブ音声翻訳はリアルタイム音声間翻訳を中心に設計されており、参加者が自分の言語で自然に話すことができ、聞いている人のために翻訳音声が生成されます。
では、音声間翻訳とは正確には何であり、なぜアーキテクチャが重要なのでしょうか?
リアルタイム音声間翻訳とは何か
音声間翻訳(S2ST)は、話された言語を受け取り、別の言語で話された出力を生成するテクノロジーです。
ライブシステムでは、このプロセスは人々が会話をしている間、継続的に発生します。
例えば:
ある人がウクライナ語を話します。
別の参加者は英語で聞きたいと思っています。
システムはウクライナ語の音声を聞き、その意味を理解し、それを翻訳し、リスナーのために英語の音声を生成します。
目標は単に言葉を翻訳することではありません。
目標は、異なる言語を話す人々間のコミュニケーションを、通常の会話に可能な限り近づけることです。
この区別は、最新の音声間翻訳システムと従来の音声翻訳パイプラインを比較するときに重要になります。
従来のアプローチ:STT→翻訳→TTS
長年にわたり、音声翻訳システムは複数の独立したテクノロジーから構築されてきました。
アーキテクチャは通常、次のようになります:
1. 音声テキスト変換(STT)
スピーカーのオーディオが書かれたテキストに変換されます。
↓
2. 機械翻訳(MT)
書かれたテキストが別の言語に翻訳されます。
↓
3. テキスト音声合成(TTS)
翻訳されたテキストが人工音声に変換されます。
完全なパイプラインは次のようになります:
オーディオ→STT→テキスト→翻訳→テキスト→TTS→オーディオ
このアーキテクチャは機能します。
実際、長年にわたって多くの音声翻訳システムを支えてきました。
また、主な目標が文字起こし、字幕、検索可能な会議メモ、または開発者がすべての処理段階を完全に制御する必要がある状況の場合にも役立ちます。
しかし、ライブの人間の会話は別の要件をもたらします:
速度。
カスケード翻訳パイプラインが遅く感じられる理由
従来の音声翻訳パイプラインのすべてのステップには時間がかかります。
音声認識システムは、何が言われたかを理解するのに十分なオーディオが必要です。
その後、翻訳システムが結果のテキストを処理します。
その後、テキスト音声合成システムが新しいオーディオストリームを生成します。
個々のコンポーネントは高速である場合があります。
しかし、それらの遅延は蓄積する可能性があります。
別の問題があります。
各段階は前の段階の出力に依存します。
音声認識が単語を誤解すると、翻訳モデルは間違ったテキストを受け取ります。
翻訳が意味を変えると、TTSシステムはその翻訳されたテキストを単に話します。
言い換えれば、エラーはパイプラインを通じて伝播する可能性があります:
音声認識エラー→翻訳エラー→話された翻訳エラー
ドキュメント翻訳中は、これは許容される場合があります。
ライブ会話中は、数秒の追加時間や不快な沈黙でさえ、コミュニケーションの感じ方を完全に変える可能性があります。
人々は自然に話すのをやめます。
彼らは待ちます。
翻訳が終了したかどうかを確認します。
その後、もう一方の人が応答します。
会話の代わりに、コミュニケーションはマシンとターンを取るように感じ始めます。
ネイティブリアルタイム音声間翻訳がアーキテクチャを変える
最新のマルチモーダルAIモデルは、同じリアルタイム相互作用内でオーディオ入力とオーディオ出力を処理できます。
開発者が話された各フレーズに対して3つの独立したシステムを接続する必要がある代わりに、リアルタイムモデルは継続的に受信オーディオを処理し、話された出力を生成できます。
ユーザーの観点からは、フローは次のようにはるかに近くなります:
音声→AI理解と翻訳→音声
これは一般的にリアルタイム音声間翻訳と呼ばれます。
重要な区別は、テキストがAIモデル内のどこかに存在できないということではありません。
最新のモデルは多くの内部表現を使用する場合があります。
違いはアーキテクチャ的です:
ライブ会話は、翻訳音声が開始される前に、別の文字起こしサービス、次に別のテキスト翻訳サービス、次に別の音声合成サービスを待つ必要がありません。
これにより、非常に異なるタイプの相互作用が可能になります。
「リアルタイム」は常に同じ意味ではありません
リアルタイム翻訳という用語は、業界全体で広く使用されています。
製品は、誰かが話してから数秒後に翻訳を生成する場合、技術的にはリアルタイムと呼ぶことができます。
字幕の場合、それは完全に許容される場合があります。
しかし、人間の会話は遅延にはるかに敏感です。
2つの体験を考えてみてください。
体験A:カスケード翻訳
あなたが話します。
システムは十分なオーディオを待ちます。
あなたの音声がテキストになります。
テキストが翻訳されます。
翻訳されたテキストが音声ジェネレータに送信されます。
もう一方の参加者が翻訳を聞きます。
その後、彼らは応答します。
体験B:リアルタイム音声間翻訳
あなたが話し始めます。
モデルは継続的なセッションの一部としてオーディオストリームを処理します。
それは進行中の会話を理解し、別の処理段階への依存性が大幅に少ない翻訳音声を生成し始めます。
会話は自然なターンテイキングに近くなります。
どちらのシステムも技術的には「リアルタイム」と説明できます。
しかし、体験は非常に異なる場合があります。
なぜレイテンシーはほとんどの翻訳ベンチマークよりも重要なのか
翻訳製品は通常、精度によって評価されます。
精度は明らかに重要です。
しかし、ライブコミュニケーション中には、同等に重要な別の側面があります:
会話レイテンシー。
複数の言語を話す6人の人々との事業会議を想像してください。
翻訳された各文が数秒の沈黙をもたらす場合、それらの遅延は会議全体で増加します。
参加者は翻訳を中断し始めます。
前の翻訳が終了する前に話し始める人もいます。
会話を追うのが難しくなるため、参加を停止する人もいます。
翻訳自体は正しい場合がありますが、会議の体験はまだ悪い場合があります。
ライブ多言語コミュニケーションの場合、翻訳品質は、言葉が正しいかどうかだけで測定することはできません。
また、以下も考慮する必要があります:
翻訳音声がどのくらい速く開始されるか;
参加者がどのように自然にターンを取ることができるか;
割り込みを処理できるかどうか;
システムが会話コンテキストを理解するかどうか;
ユーザーが完全な文を待つ必要があるかどうか;
複数の言語間で会話がどのようにうまく流れるか。
これが、リアルタイム音声間翻訳テクノロジーが特に会議に重要である理由です。
音声には言葉以上のものが含まれています
音声を平文に変換することのもう1つの制限は、人間の音声には文字起こしで完全に表現するのが難しい情報が含まれていることです。
人々は以下を通じてコミュニケーションします:
トーン;
リズム;
一時停止;
強調;
躊躇;
話す速度;
会話コンテキスト。
従来のSTTシステムは、最初に話されたメッセージをテキストに圧縮します。
したがって、元のオーディオからの情報は、翻訳が開始される前に失われる可能性があります。
最新の音声間翻訳モデルはオーディオで直接動作でき、元の音声信号の詳細にアクセスできます。
これは、すべてのニュアンスが常に翻訳を生き残ることを意味するわけではありません。
しかし、テキストのみを中心に構築されたシステムよりもはるかに自然な音声相互作用の可能性を作成します。
音声間翻訳対音声テキスト翻訳
これらのテクノロジーは時々混同されていますが、異なる問題を解決します。
音声テキスト翻訳は、話された言語を翻訳されたテキストに変換します。
例えば:
日本語音声→英語字幕
これはキャプションとアクセシビリティに非常に役立ちます。
音声間翻訳は翻訳音声を生成します:
日本語音声→英語音声
これにより、リスナーは常に字幕を読むことなく会話を追うことができます。
Voicliは会議体験の一部としてライブ字幕をサポートしていますが、音声翻訳は、他の人が言ったことの翻訳を単に読むのではなく、人々が実際に言語を超えて話すことを可能にするために設計されています。
Voicliがリアルタイム音声間翻訳を使用する理由
Voicliは単純な考え方を中心に構築されました:
人々は同じ会議に参加し、最も快適な言語で話すことができるべきです。
ある参加者はウクライナ語を話すかもしれません。
別の人は日本語を話すかもしれません。
別の人は英語を好むかもしれません。
別の人は韓国語を話すかもしれません。
全員を共通の第二言語に切り替えるのではなく、Voicliは会話中に翻訳を処理します。
各参加者は、聞きたい言語を選択できます。
プラットフォームは、リスナーの好みに応じて、翻訳音声、字幕、または元のオーディオを提供できます。
ライブ音声翻訳の場合、Voicliは従来の排他的な依存ではなく、リアルタイム音声間翻訳アーキテクチャを使用します:
STT→テキスト翻訳→TTS
翻訳された各発話のパイプライン。
そのアーキテクチャの違いは重要です。Voicliは、翻訳されたテキストを話すことが起こる文字起こしツールを構築しようとしているのではないからです。
目標は実際の会話のための多言語コミュニケーション層を構築することです。
STT+翻訳+TTSがまだ正しいソリューションである場合
音声間翻訳テクノロジーは従来のパイプラインを時代遅れにしません。
STT→翻訳→TTSが有用であるか、さらには好ましい多くの状況があります。
例えば:
会議トランスクリプトは正確なテキストが必要です。
検索可能な会話履歴はテキスト表現が必要です。
字幕は自然に文字起こしに依存します。
コンプライアンスシステムは、認識されたものを正確に保存する必要がある場合があります。
非同期翻訳は極めて低いレイテンシーを必要としません。
特殊なワークフローは、開発者がすべての中間段階を検査および変更する必要がある場合があります。
これが、Voicliがタスクに応じて異なるAIテクノロジーも使用する理由です。
重要なのは、構築されている体験に対して正しいアーキテクチャを選択することです。
トランスクリプトの場合、テキストが製品です。
ライブ多言語会話の場合、会話自体が製品です。
翻訳ツールから多言語会話へ
数十年間、機械翻訳は主に、ある言語から別の言語への情報の変換に関するものでした。
最初はドキュメント。
その後、ウェブサイト。
その後、メッセージ。
その後、字幕。
リアルタイム音声間翻訳は異なる方向を表しています。
代わりに尋ねる代わりに:
「この文をどのくらい速く翻訳できますか?」
より重要な質問は次のようになります:
「異なる言語を話す2人が自然にコミュニケーションできますか?」
これは翻訳システムをどのように設計する必要があるかを変えます。
レイテンシーが重要になります。
ターンテイキングが重要になります。
オーディオ品質が重要になります。
コンテキストが重要になります。
そして翻訳は、人々が意識的に使用する別のツールではなく、コミュニケーションインフラストラクチャの一部になります。
多言語会議の未来
音声翻訳の長期的な目標は、人々が翻訳テクノロジーについてより頻繁に考えるようにすることではありません。
それは反対です。
翻訳は徐々に会話に消えるべきです。
あなたはあなたの言語を話します。
もう一方の人は彼らのものを話します。
そしてテクノロジーはあなたの間で何が起こるかを処理します。
まだ課題があります。
アクセント、背景ノイズ、ドメイン固有の用語、重複するスピーカー、名前、文化的コンテキストはすべてAI翻訳に影響を与える可能性があります。
しかし、リアルタイムマルチモーダルモデルは、技術的に可能なことを変えています。
私たちは以下から移動しています:
記録→文字起こし→翻訳→合成→聞く
に向かって:
話す→理解→翻訳→聞く
そして最終的には、最も成功した翻訳テクノロジーは、参加者がほとんど気づかないテクノロジーかもしれません。
リアルタイム翻訳はコミュニケーションのように感じるべき
製品を「リアルタイム」と呼ぶのは簡単です。
多言語コミュニケーションを実際にリアルタイムのように感じさせることははるかに難しいです。
違いは、ベンチマークのミリ秒だけではありません。
それは、人々が自然に話すことができるかどうかです。
彼らが待つことなく応答できるかどうか。
多言語会議が翻訳されたメッセージのシーケンスではなく、会話のように感じるかどうか。
それはVoicliが取り組んでいる問題です。
誰もが自分の言語を話すことができる会話のためのリアルタイム音声間翻訳。
よくある質問
音声間翻訳とは何ですか?
音声間翻訳は、話された言語を別の言語の話された出力に直接変換します。最新のAIシステムは、リアルタイムセッション内でオーディオ入力を処理し、翻訳音声を生成できます。
音声間翻訳と音声テキスト翻訳の違いは何ですか?
音声テキスト翻訳は、字幕などの翻訳されたテキストを生成します。音声間翻訳は、リスナーが聞くことができる翻訳音声を生成します。
従来の音声翻訳はどのように機能しますか?
従来のシステムは一般的に3つの段階を使用します:音声テキスト認識、機械翻訳、テキスト音声合成。これはしばしばカスケード音声翻訳アーキテクチャと呼ばれます。
STT→翻訳→TTSがより高いレイテンシーを持つことができるのはなぜですか?
各段階は情報を処理し、その出力を次のコンポーネントに渡す必要があります。蓄積された処理時間は追加の遅延をもたらす可能性があり、1つの段階からのエラーは後続の段階にも影響を与える可能性があります。
音声間翻訳は同時通訳と同じですか?
それらは関連する概念ですが、同一ではありません。人間の同時通訳は専門の通訳者によって実行されます。AI音声間翻訳は、同様の低遅延多言語コミュニケーション体験を自動的に提供しようとします。
音声間翻訳はビジネス会議に使用できますか?
はい。リアルタイム音声間翻訳は、国際会議、顧客通話、営業会話、リモートチーム、インタビュー、および参加者が同じ言語を共有しない他の状況に特に役立ちます。
Voicliは何をしていますか?
Voicliは、リアルタイム音声翻訳とライブ字幕を備えた多言語ビデオコミュニケーションプラットフォームです。参加者は好みの言語で話すことができ、Voicliが会話中に翻訳を処理します。
Voicliを試して、あなたの言語を話してください。会議に翻訳を処理させてください。