Real-time spraak-naar-spraak-vertaling: waarom niet alle "real-time" stemvertaling hetzelfde is
Key Takeaways
- Real-time spraak-naar-spraak-vertaling verwerkt audio direct zonder het om te zetten naar tekst als tussenstap, wat lagere latentie en meer natuurlijke gesprekken mogelijk maakt.
- Traditionele STT → vertaling → TTS-pijplijnen kunnen vertragingen introduceren omdat elke fase moet wachten op de vorige, en fouten kunnen zich voortplanten.
- Latentie is net zo belangrijk als nauwkeurigheid voor live meertalige communicatie, omdat zelfs enkele seconden vertraging kan voorkomen dat deelnemers natuurlijk kunnen spreken.
- Spraak bevat informatie zoals toon, ritme en nadruk die verloren gaat wanneer het eerst in tekst wordt omgezet, wat spraak-naar-spraak-modellen beter kunnen behouden.
- Voicli gebruikt real-time spraak-naar-spraak-architectuur om meertalige vergaderingen mogelijk te maken waar deelnemers hun eigen taal kunnen spreken zonder zich bewust te zijn van vertaaltechnologie.
Real-time stemvertaling wordt een standaardfunctie in vergaderplatforms, communicatietools en AI-toepassingen.
Maar er is een belangrijk detail dat vaak verborgen zit achter de woorden "real-time vertaling."
Twee producten kunnen beide zeggen dat ze spraak in real-time vertalen, terwijl ze zeer verschillende technologieën gebruiken.
De ene kan een gesprek als volgt verwerken:
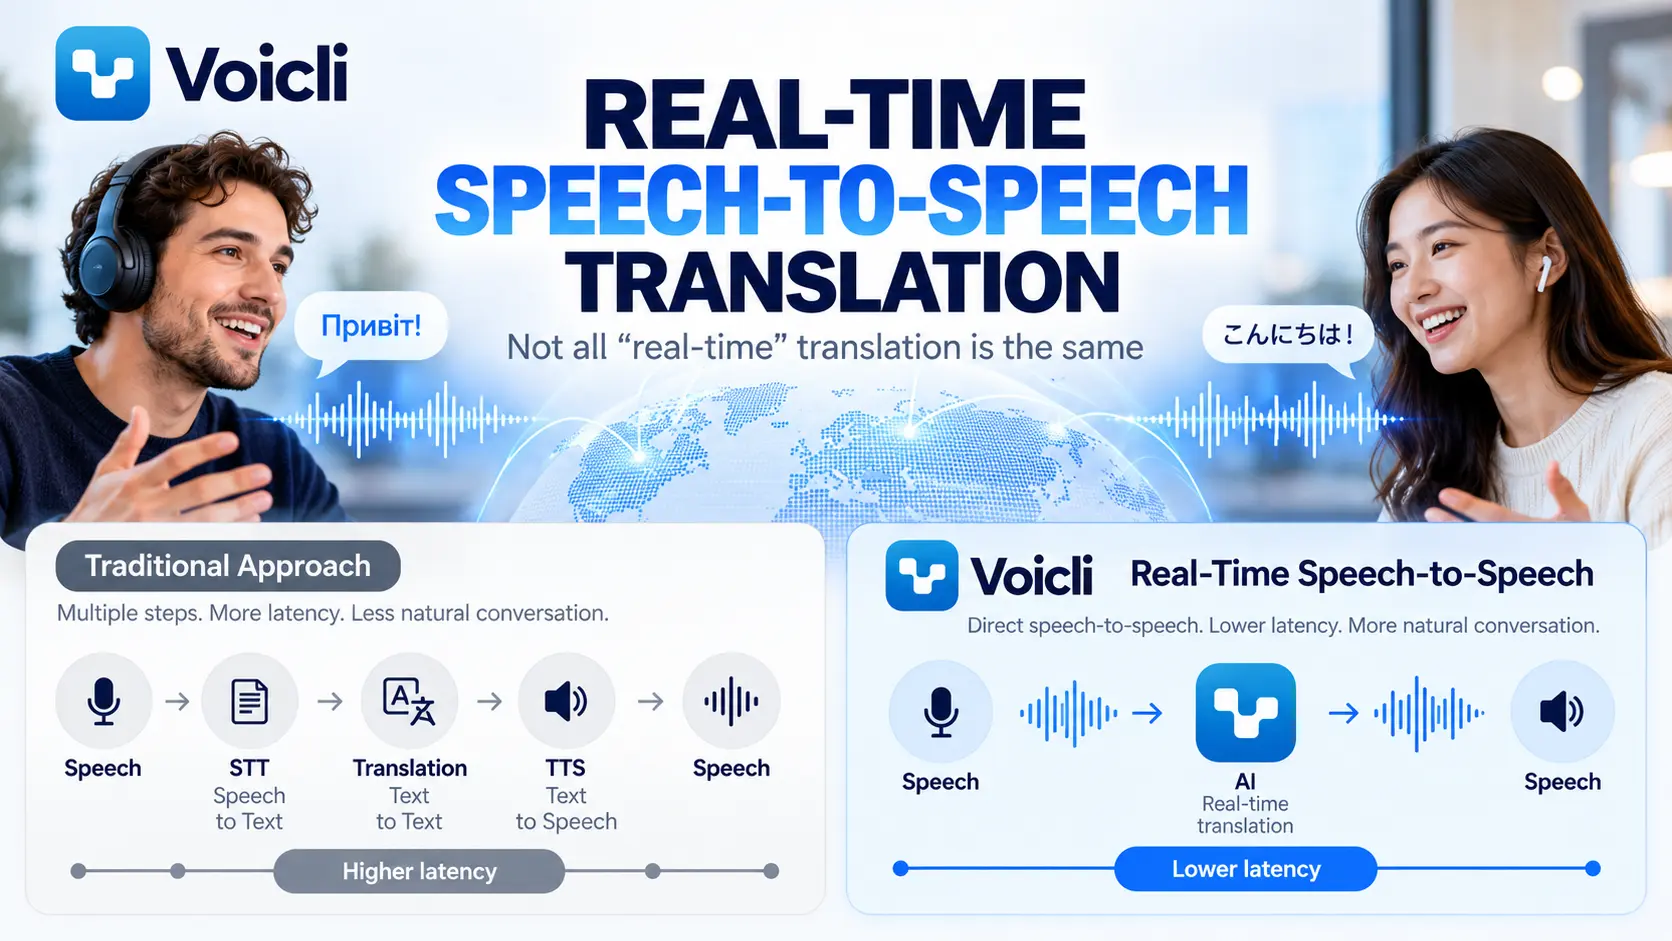
Spraak → transcriptie → tekstvertaling → tekst-naar-spraak → vertaalde audio
Een ander kan de interactie verwerken als een continue spraak-naar-spraak-ervaring, waarbij audio direct wordt begrepen en vertaald binnen een real-time multimodaal model.
Beide benaderingen kunnen vertaalde spraak produceren.
Maar ze creëren niet noodzakelijk dezelfde gesprekservaring.
Bij Voicli is onze live stemvertaling ontworpen rond real-time spraak-naar-spraak-vertaling, waardoor deelnemers natuurlijk in hun eigen talen kunnen spreken terwijl vertaalde spraak wordt gegenereerd voor de luisteraars.
Wat is spraak-naar-spraak-vertaling precies, en waarom is de architectuur belangrijk?
Wat is real-time spraak-naar-spraak-vertaling?
Spraak-naar-spraak-vertaling (S2ST) is technologie die gesproken taal ontvangt en gesproken uitvoer in een andere taal produceert.
In een live systeem gebeurt dit proces continu terwijl mensen een gesprek voeren.
Bijvoorbeeld:
Een persoon spreekt Oekraïens.
Een ander deelnemer wil Engels horen.
Het systeem luistert naar de Oekraïense spraak, begrijpt de betekenis, vertaalt deze en genereert Engelse audio voor de luisteraar.
Het doel is niet simpelweg woorden vertalen.
Het doel is communicatie tussen mensen die verschillende talen spreken zo dicht mogelijk bij een normaal gesprek laten aanvoelen.
Dit onderscheid wordt belangrijk wanneer we moderne spraak-naar-spraak-systemen vergelijken met traditionele stemvertaalpijplijnen.
De traditionele benadering: STT → vertaling → TTS
Jarenlang zijn stemvertaalsystemen gebouwd uit verschillende afzonderlijke technologieën.
De architectuur ziet er meestal als volgt uit:
1. Spraak-naar-tekst (STT)
De audio van de spreker wordt omgezet in geschreven tekst.
↓
2. Machinevertaling (MT)
De geschreven tekst wordt in een andere taal vertaald.
↓
3. Tekst-naar-spraak (TTS)
De vertaalde tekst wordt terug omgezet in kunstmatige spraak.
De volledige pijplijn wordt:
Audio → STT → Tekst → Vertaling → Tekst → TTS → Audio
Deze architectuur werkt.
In feite heeft het jarenlang veel stemvertaalsystemen aangedreven.
Het is ook nuttig wanneer het primaire doel transcriptie, ondertitels, doorzoekbare vergadernotities is, of situaties waarin ontwikkelaars volledige controle over elke verwerkingsstap nodig hebben.
Maar live menselijk gesprek introduceert een ander vereiste:
snelheid.
Waarom een cascadepijplijn voor vertaling traag kan aanvoelen
Elke stap in een traditionele stemvertaalpijplijn kost tijd.
Het spraakherkenningssysteem heeft genoeg audio nodig om te begrijpen wat er werd gezegd.
Vervolgens verwerkt het vertaalsysteem de resulterende tekst.
Daarna genereert het tekst-naar-spraak-systeem een nieuwe audiostroom.
Elk afzonderlijk onderdeel kan snel zijn.
Maar hun vertragingen kunnen zich opstapelen.
Er is nog een probleem.
Elke fase is afhankelijk van de uitvoer van de vorige fase.
Als spraakherkenning een woord verkeerd begrijpt, ontvangt het vertaalmodel de verkeerde tekst.
Als de vertaling de betekenis verandert, spreekt het TTS-systeem gewoon die vertaalde tekst uit.
Met andere woorden, fouten kunnen zich door de pijplijn voortplanten:
Spraakherkenningsfout → vertaalfout → gesproken vertaalfout
Bij documentvertaling kan dit acceptabel zijn.
Tijdens een live gesprek kunnen zelfs enkele extra seconden of een ongemakkelijke pauze volledig veranderen hoe communicatie aanvoelt.
Mensen stoppen met natuurlijk spreken.
Ze wachten.
Ze controleren of de vertaling klaar is.
Vervolgens reageert de ander.
In plaats van een gesprek begint communicatie aan te voelen als beurten nemen met een machine.
Native real-time spraak-naar-spraak verandert de architectuur
Moderne multimodale AI-modellen kunnen werken met audio-invoer en audio-uitvoer binnen dezelfde real-time interactie.
In plaats van dat ontwikkelaars voor elke gesproken zin drie onafhankelijke systemen moeten verbinden, kan een real-time model continu inkomende audio verwerken en gesproken uitvoer genereren.
Vanuit het perspectief van de gebruiker wordt de stroom veel meer:
Spraak → AI-begrip en vertaling → Spraak
Dit wordt over het algemeen aangeduid als real-time spraak-naar-spraak-vertaling.
Het belangrijke onderscheid is niet dat tekst nooit ergens in een AI-model kan bestaan.
Moderne modellen kunnen veel interne representaties gebruiken.
Het verschil is architecturaal:
Het live gesprek hoeft niet te wachten op een aparte transcriptieservice, vervolgens een aparte tekstvertaalservice en vervolgens een aparte spraaksyntheseservice voordat vertaalde audio kan beginnen.
Dat maakt een heel ander type interactie mogelijk.
"Real-time" betekent niet altijd hetzelfde
De term real-time vertaling wordt breed in de industrie gebruikt.
Een product kan zichzelf technisch real-time noemen als het een vertaling enkele seconden nadat iemand spreekt genereert.
Voor ondertitels kan dat volkomen acceptabel zijn.
Maar menselijk gesprek is veel gevoeliger voor vertraging.
Beschouw twee ervaringen.
Ervaring A: Cascadevertalingen
Je spreekt.
Het systeem wacht op genoeg audio.
Je spraak wordt tekst.
De tekst wordt vertaald.
De vertaalde tekst wordt naar een stemgenerator gestuurd.
De andere deelnemer hoort de vertaling.
Vervolgens reageren zij.
Ervaring B: Real-time spraak-naar-spraak
Je begint te spreken.
Het model verwerkt de audiostroom als onderdeel van een continue sessie.
Het begrijpt het lopende gesprek en begint vertaalde spraak te genereren met aanzienlijk minder afhankelijkheid van afzonderlijke verwerkingsfasen.
Het gesprek wordt dichter bij natuurlijke beurtwisseling.
Beide systemen kunnen technisch als "real-time" worden beschreven.
Maar de ervaring kan heel anders zijn.
Waarom latentie belangrijker is dan de meeste vertaalbenchmarks
Vertaalproducten worden vaak geëvalueerd op nauwkeurigheid.
Nauwkeurigheid is duidelijk belangrijk.
Maar tijdens live communicatie is er nog een even belangrijk aspect:
gesprekslatentie.
Stel je een zakelijke vergadering voor met zes mensen die verschillende talen spreken.
Als elke vertaalde zin enkele seconden stilte introduceert, vermenigvuldigen die vertragingen zich in de vergadering.
Deelnemers beginnen vertalingen te onderbreken.
Sommige mensen beginnen te spreken voordat vorige vertalingen klaar zijn.
Anderen stoppen met deelnemen omdat het volgen van het gesprek moeilijk wordt.
De vertaling zelf kan correct zijn terwijl de vergaderervaring nog steeds slecht is.
Voor live meertalige communicatie kan vertaalkwaliteit daarom niet alleen worden gemeten aan de hand van of de woorden correct zijn.
Het moet ook rekening houden met:
hoe snel vertaalde spraak begint;
hoe natuurlijk deelnemers beurten kunnen nemen;
of onderbrekingen kunnen worden afgehandeld;
of het systeem gesprekscontext begrijpt;
of gebruikers op volledige zinnen moeten wachten;
hoe goed het gesprek over meerdere talen verloopt.
Dit is waarom real-time spraak-naar-spraak-technologie vooral belangrijk is voor vergaderingen.
Spraak bevat meer dan woorden
Een ander nadeel van het omzetten van spraak in platte tekst is dat menselijke spraak informatie bevat die moeilijk volledig in een transcript kan worden weergegeven.
Mensen communiceren via:
toon;
ritme;
pauzes;
nadruk;
aarzeling;
spreeksnelheid;
gesprekscontext.
Traditionele STT-systemen comprimeren eerst het gesproken bericht in tekst.
Sommige informatie uit de originele audio kan daarom verloren gaan voordat vertaling zelfs begint.
Moderne spraak-naar-spraak-modellen kunnen direct met audio werken en hebben toegang tot meer van het originele spraaksignaal.
Dit betekent niet dat elke nuance altijd vertaling zal overleven.
Maar het creëert de mogelijkheid van veel natuurlijkere spraakinteracties dan systemen die alleen op tekst zijn gebaseerd.
Spraak-naar-spraak versus spraak-naar-tekst-vertaling
Deze technologieën worden soms verward, maar ze lossen verschillende problemen op.
Spraak-naar-tekst-vertaling zet gesproken taal om in vertaalde tekst.
Bijvoorbeeld:
Japanse spraak → Engelse ondertitels
Dit is uiterst nuttig voor ondertitels en toegankelijkheid.
Spraak-naar-spraak-vertaling produceert vertaalde audio:
Japanse spraak → Engelse spraak
Dit stelt de luisteraar in staat het gesprek te volgen zonder constant ondertitels te lezen.
Voicli ondersteunt live ondertitels als onderdeel van de vergaderervaring, maar stemvertaling is ontworpen voor iets breder: mensen in staat stellen om daadwerkelijk over talen heen te communiceren, in plaats van simpelweg vertalingen van wat anderen zeiden te lezen.
Waarom Voicli real-time spraak-naar-spraak-vertaling gebruikt
Voicli is gebouwd rond een eenvoudig idee:
Mensen moeten dezelfde vergadering kunnen bijwonen en de taal spreken waarin zij zich het meest op hun gemak voelen.
Een deelnemer spreekt misschien Oekraïens.
Een ander spreekt misschien Japans.
Een ander geeft misschien de voorkeur aan Engels.
Een ander spreekt misschien Koreaans.
In plaats van iedereen te dwingen over te schakelen naar een gemeenschappelijke tweede taal, handelt Voicli vertaling af tijdens het gesprek.
Elke deelnemer kan de taal selecteren die hij wil horen.
Het platform kan vertaalde spraak, ondertitels of de originele audio leveren, afhankelijk van de voorkeur van de luisteraar.
Voor live stemvertaling gebruikt Voicli een real-time spraak-naar-spraak-architectuur in plaats van uitsluitend te vertrouwen op de traditionele:
STT → tekstvertaling → TTS
pijplijn voor elke vertaalde uitspraak.
Dat architectuurverschil is belangrijk omdat Voicli niet probeert een transcriptietool te bouwen die toevallig vertaalde tekst spreekt.
Het doel is een meertalige communicatielaag voor echte gesprekken te bouwen.
Wanneer STT + vertaling + TTS nog steeds de juiste oplossing is
Spraak-naar-spraak-technologie maakt traditionele pijplijnen niet overbodig.
Er zijn veel situaties waarin STT → vertaling → TTS nuttig of zelfs beter is.
Bijvoorbeeld:
Vergaderverslagen hebben nauwkeurige tekst nodig.
Doorzoekbare gespreksgeschiedenis vereist tekstrepresentatie.
Ondertitels zijn van nature afhankelijk van transcriptie.
Nalevingssystemen moeten mogelijk precies opslaan wat werd herkend.
Asynchrone vertaling vereist geen extreem lage latentie.
Gespecialiseerde workflows kunnen vereisen dat ontwikkelaars elke tussenstap inspecteren en wijzigen.
Dit is waarom Voicli ook verschillende AI-technologieën gebruikt, afhankelijk van de taak.
De sleutel is het kiezen van de juiste architectuur voor de ervaring die wordt gebouwd.
Voor een transcript is tekst het product.
Voor een live meertalig gesprek is het gesprek zelf het product.
Van vertaaltools naar meertalige gesprekken
Decennialang ging machinevertaling vooral om informatie van de ene taal naar de andere om te zetten.
Eerst documenten.
Vervolgens websites.
Vervolgens berichten.
Vervolgens ondertitels.
Real-time spraak-naar-spraak-vertaling vertegenwoordigt een ander richting.
In plaats van te vragen:
"Hoe snel kunnen we deze zin vertalen?"
wordt de belangrijkere vraag:
"Kunnen twee mensen die verschillende talen spreken natuurlijk communiceren?"
Dat verandert hoe vertaalsystemen moeten worden ontworpen.
Latentie wordt kritiek.
Beurtwisseling wordt kritiek.
Audiokwaliteit wordt kritiek.
Context wordt kritiek.
En vertaling wordt onderdeel van de communicatie-infrastructuur in plaats van een apart hulpmiddel dat mensen bewust gebruiken.
De toekomst van meertalige vergaderingen
Het lange termijndoel van spraakvertaling is niet om mensen vaker over vertaaltechnologie na te denken.
Het is het tegenovergestelde.
Vertaling moet geleidelijk in het gesprek verdwijnen.
Je spreekt je taal.
De ander spreekt de zijne.
En de technologie handelt af wat tussen jullie gebeurt.
Er zullen nog steeds uitdagingen zijn.
Accenten, achtergrondgeluid, domeinspecifieke terminologie, overlappende sprekers, namen en culturele context kunnen allemaal AI-vertaling beïnvloeden.
Maar real-time multimodale modellen veranderen wat technisch mogelijk is.
We gaan van:
opnemen → transcriberen → vertalen → synthetiseren → luisteren
naar:
spreken → begrijpen → vertalen → horen
En uiteindelijk kan de meest succesvolle vertaaltechnologie de technologie zijn die deelnemers nauwelijks opmerken.
Real-time vertaling moet als communicatie aanvoelen
Een product "real-time" noemen is gemakkelijk.
Meertalige communicatie daadwerkelijk real-time laten aanvoelen is veel moeilijker.
Het verschil is niet alleen milliseconden op een benchmark.
Het is of mensen natuurlijk kunnen spreken.
Of zij kunnen reageren zonder te wachten.
Of een meertalige vergadering aanvoelt als een gesprek in plaats van een reeks vertaalde berichten.
Dat is het probleem waaraan Voicli werkt.
Real-time spraak-naar-spraak-vertaling voor gesprekken waar iedereen zijn eigen taal kan spreken.
Veelgestelde vragen
Wat is spraak-naar-spraak-vertaling?
Spraak-naar-spraak-vertaling zet gesproken taal direct om in gesproken uitvoer in een andere taal. Moderne AI-systemen kunnen audio-invoer verwerken en vertaalde audio genereren binnen een real-time sessie.
Wat is het verschil tussen spraak-naar-spraak en spraak-naar-tekst-vertaling?
Spraak-naar-tekst-vertaling produceert vertaalde geschreven tekst, zoals ondertitels. Spraak-naar-spraak-vertaling produceert vertaalde audio die de luisteraar kan horen.
Hoe werkt traditionele stemvertaling?
Traditionele systemen gebruiken meestal drie fasen: spraakherkenning, machinevertaling en tekst-naar-spraaksynthese. Dit wordt vaak een cascadearchitectuur voor spraakvertaling genoemd.
Waarom kan STT → vertaling → TTS hogere latentie hebben?
Elke fase moet informatie verwerken en de uitvoer ervan aan het volgende onderdeel doorgeven. De cumulatieve verwerkingstijd kan extra vertraging introduceren, terwijl fouten van de ene fase ook volgende fasen kunnen beïnvloeden.
Is spraak-naar-spraak-vertaling hetzelfde als gelijktijdige interpretatie?
Het zijn gerelateerde concepten maar niet identiek. Menselijke gelijktijdige interpretatie wordt uitgevoerd door professionele tolken. AI spraak-naar-spraak-vertaling probeert automatisch een vergelijkbare lage-vertraagde meertalige communicatie-ervaring te bieden.
Kan spraak-naar-spraak-vertaling voor zakelijke vergaderingen worden gebruikt?
Ja. Real-time spraak-naar-spraak-vertaling is vooral nuttig voor internationale vergaderingen, klantgesprekken, verkoopgesprekken, externe teams, interviews en andere situaties waarin deelnemers niet dezelfde taal delen.
Wat doet Voicli?
Voicli is een meertalig videoplatform voor communicatie met real-time stemvertaling en live ondertitels. Deelnemers kunnen hun voorkeurstalen spreken terwijl Voicli vertaling af handelt tijdens het gesprek.
Probeer Voicli en spreek je taal. Laat de vergadering de vertaling afhandelen.