Tłumaczenie mowy na mowę w czasie rzeczywistym: Dlaczego nie wszystkie „rzeczywiste" tłumaczenia głosu są takie same
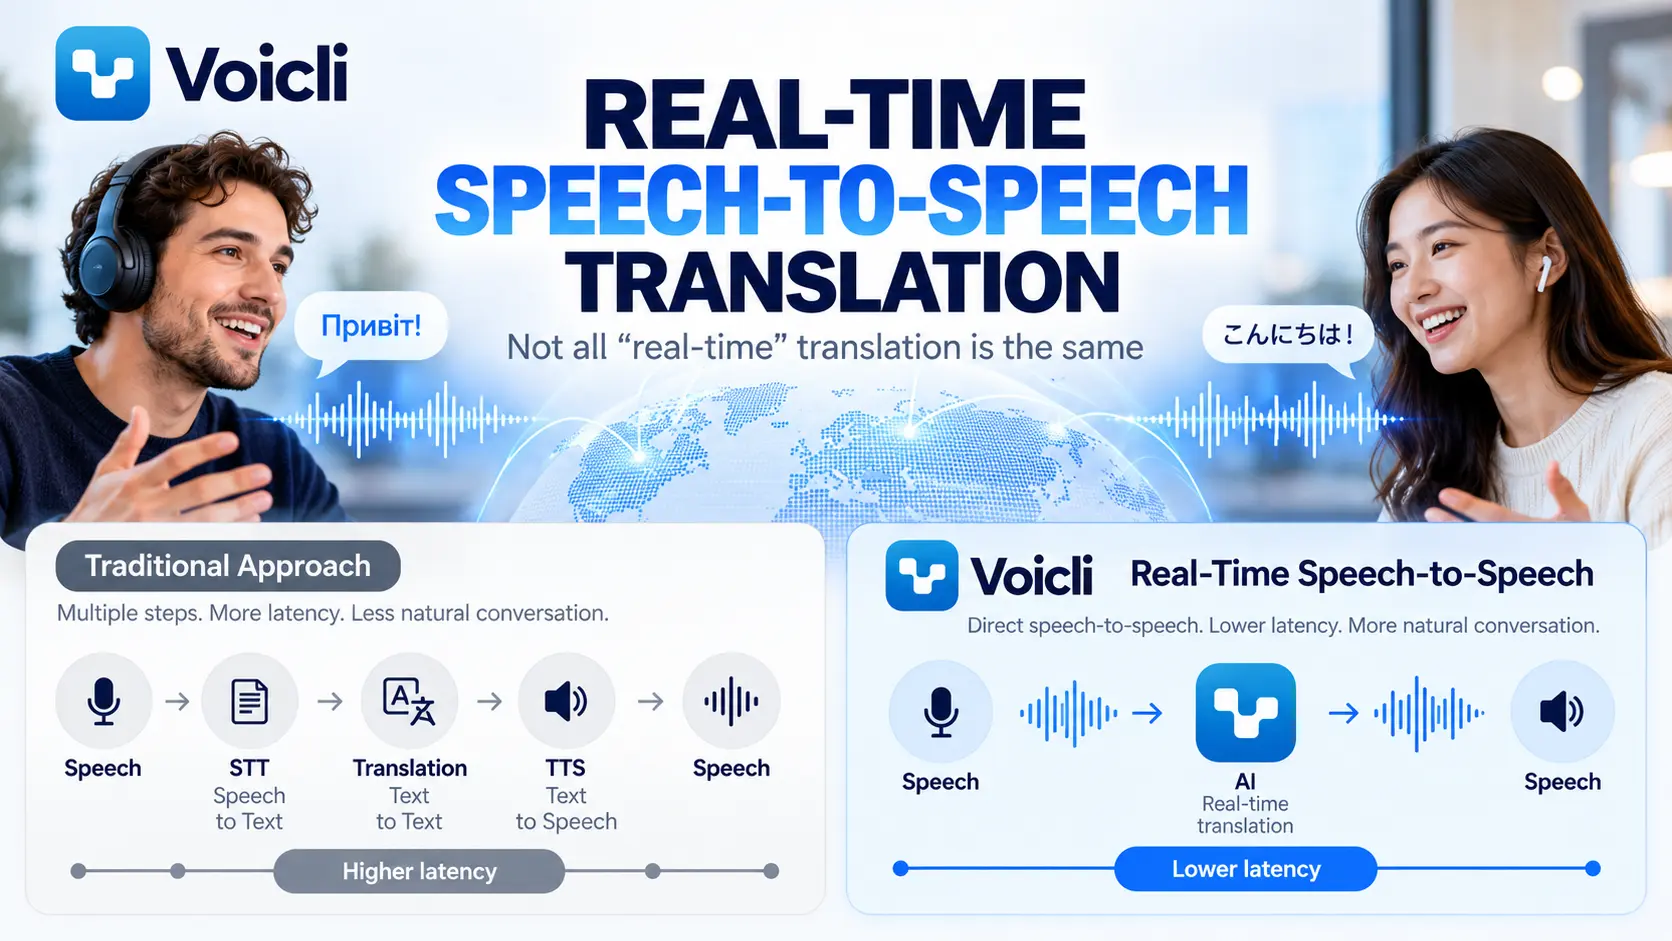
Tłumaczenie głosu w czasie rzeczywistym staje się coraz bardziej powszechną funkcją platform spotkań, narzędzi komunikacyjnych i aplikacji AI.
Ale istnieje ważny szczegół, który jest często ukryty za słowami "tłumaczenie w czasie rzeczywistym."
Dwa produkty mogą twierdzić, że tłumaczą mowę w czasie rzeczywistym, używając bardzo różnych technologii.
Jeden może przetwarzać rozmowę w ten sposób:
Mowa → transkrypcja → tłumaczenie tekstu → zamiana tekstu na mowę → przetłumaczony dźwięk
Inny może przetwarzać interakcję jako ciągłe doświadczenie mowy na mowę, gdzie dźwięk jest rozumiany i tłumaczony bezpośrednio w ramach modelu multimodalnego działającego w czasie rzeczywistym.
Oba podejścia mogą generować przetłumaczoną mowę.
Ale niekoniecznie tworzą to samo doświadczenie rozmowy.
W Voicli nasze tłumaczenie głosu na żywo zostało zaprojektowane wokół tłumaczenia mowy na mowę w czasie rzeczywistym, umożliwiając uczestnikom naturalną mowę w ich własnych językach, podczas gdy przetłumaczony głos jest generowany dla osób słuchających.
Czym dokładnie jest tłumaczenie mowy na mowę i dlaczego architektura ma znaczenie?
Czym jest tłumaczenie mowy na mowę w czasie rzeczywistym?
Tłumaczenie mowy na mowę (S2ST) to technologia, która odbiera mowę i generuje wyjście mowy w innym języku.
W systemie na żywo proces ten odbywa się w sposób ciągły, gdy ludzie prowadzą rozmowę.
Na przykład:
Osoba mówi po ukraińsku.
Inny uczestnik chce słyszeć angielski.
System słucha ukraińskiej mowy, rozumie jej znaczenie, tłumaczy ją i generuje angielski dźwięk dla słuchacza.
Celem nie jest po prostu tłumaczenie słów.
Celem jest sprawienie, aby komunikacja między osobami mówiącymi w różnych językach była jak najbliższa normalnej rozmowie.
To rozróżnienie staje się ważne, gdy porównujemy nowoczesne systemy mowy na mowę z tradycyjnymi potokami tłumaczenia głosu.
Tradycyjne podejście: STT → Tłumaczenie → TTS
Przez wiele lat systemy tłumaczenia głosu były budowane z kilku oddzielnych technologii.
Architektura zwykle wygląda tak:
1. Zamiana mowy na tekst (STT)
Dźwięk mówcy jest konwertowany na tekst pisany.
↓
2. Tłumaczenie maszynowe (MT)
Tekst pisany jest tłumaczony na inny język.
↓
3. Zamiana tekstu na mowę (TTS)
Przetłumaczony tekst jest konwertowany z powrotem na sztuczną mowę.
Kompletny potok staje się:
Dźwięk → STT → Tekst → Tłumaczenie → Tekst → TTS → Dźwięk
Ta architektura działa.
W rzeczywistości zasilała wiele systemów tłumaczenia mowy przez lata.
Jest również przydatna, gdy głównym celem jest transkrypcja, napisy, przeszukiwalne notatki ze spotkań lub sytuacje, w których deweloperzy potrzebują pełnej kontroli nad każdym etapem przetwarzania.
Ale żywa rozmowa między ludźmi wprowadza inny wymóg:
szybkość.
Dlaczego kaskadowy potok tłumaczenia może wydawać się wolny
Każdy krok w tradycyjnym potokie tłumaczenia głosu zajmuje czas.
System rozpoznawania mowy potrzebuje wystarczającej ilości dźwięku, aby zrozumieć, co zostało powiedziane.
Następnie system tłumaczenia przetwarza wynikowy tekst.
Następnie system zamiany tekstu na mowę generuje nowy strumień dźwięku.
Każdy poszczególny komponent może być szybki.
Ale ich opóźnienia mogą się kumulować.
Jest jeszcze jeden problem.
Każdy etap zależy od wyjścia poprzedniego etapu.
Jeśli rozpoznawanie mowy źle zrozumie słowo, model tłumaczenia otrzyma błędny tekst.
Jeśli tłumaczenie zmieni znaczenie, system zamiany tekstu na mowę po prostu wypowiada ten przetłumaczony tekst.
Innymi słowy, błędy mogą rozprzestrzeniać się przez potok:
Błąd rozpoznawania mowy → błąd tłumaczenia → błąd przetłumaczonej mowy
Podczas tłumaczenia dokumentów może to być akceptowalne.
Podczas żywej rozmowy nawet kilka dodatkowych sekund lub niezręczna pauza mogą całkowicie zmienić sposób, w jaki komunikacja się odbywa.
Ludzie przestają mówić naturalnie.
Czekają.
Sprawdzają, czy tłumaczenie się skończyło.
Następnie druga osoba odpowiada.
Zamiast rozmowy komunikacja zaczyna się czuć jak zmiana tur z maszyną.
Natywne tłumaczenie mowy na mowę w czasie rzeczywistym zmienia architekturę
Nowoczesne multimodalne modele AI mogą pracować z wejściem audio i wyjściem audio w ramach tej samej interakcji w czasie rzeczywistym.
Zamiast wymagać od deweloperów połączenia trzech niezależnych systemów dla każdej wypowiedzi, model działający w czasie rzeczywistym może w sposób ciągły przetwarzać przychodzący dźwięk i generować mowę.
Z perspektywy użytkownika przepływ staje się znacznie bliższy:
Mowa → Rozumienie i tłumaczenie AI → Mowa
Jest to ogólnie określane jako tłumaczenie mowy na mowę w czasie rzeczywistym.
Ważne rozróżnienie nie polega na tym, że tekst nigdy nie może istnieć gdziekolwiek wewnątrz modelu AI.
Nowoczesne modele mogą używać wielu wewnętrznych reprezentacji.
Różnica jest architektoniczna:
Żywa rozmowa nie musi czekać na oddzielną usługę transkrypcji, następnie oddzielną usługę tłumaczenia tekstu, a następnie oddzielną usługę syntezy mowy, zanim będzie możliwe rozpoczęcie przetłumaczonego dźwięku.
To umożliwia bardzo inny typ interakcji.
„Czas rzeczywisty" nie zawsze oznacza to samo
Termin tłumaczenie w czasie rzeczywistym jest szeroko używany w branży.
Produkt może technicznie nazwać się rzeczywistym czasem, jeśli generuje tłumaczenie kilka sekund po tym, jak ktoś coś powie.
Dla napisów może to być całkowicie akceptowalne.
Ale rozmowa między ludźmi jest znacznie bardziej wrażliwa na opóźnienia.
Rozważ dwa doświadczenia.
Doświadczenie A: Tłumaczenie kaskadowe
Mówisz.
System czeka na wystarczającą ilość dźwięku.
Twoja mowa staje się tekstem.
Tekst jest tłumaczony.
Przetłumaczony tekst jest wysyłany do generatora głosu.
Drugi uczestnik słyszy tłumaczenie.
Następnie odpowiada.
Doświadczenie B: Tłumaczenie mowy na mowę w czasie rzeczywistym
Zaczynasz mówić.
Model przetwarza strumień dźwięku jako część sesji ciągłej.
Rozumie trwającą rozmowę i zaczyna generować przetłumaczoną mowę z znacznie mniejszą zależnością od oddzielnych etapów przetwarzania.
Rozmowa staje się bliższa naturalnej wymianie tur.
Oba systemy mogą technicznie być opisane jako „czas rzeczywisty".
Ale doświadczenie może być bardzo różne.
Dlaczego opóźnienie ma większe znaczenie niż większość benchmarków tłumaczenia
Produkty tłumaczeniowe są często oceniane pod względem dokładności.
Dokładność jest oczywiście ważna.
Ale podczas żywej komunikacji istnieje inny równie ważny wymiar:
opóźnienie rozmowy.
Wyobraź sobie spotkanie biznesowe z sześcioma osobami mówiącymi w kilku językach.
Jeśli każde przetłumaczone zdanie wprowadza kilka sekund ciszy, te opóźnienia mnożą się na całym spotkaniu.
Uczestnicy zaczynają przerywać tłumaczenia.
Niektórzy ludzie zaczynają mówić, zanim poprzednie tłumaczenia się skończyły.
Inni przestają uczestniczyć, ponieważ śledzenie rozmowy staje się trudne.
Samo tłumaczenie może być poprawne, podczas gdy doświadczenie spotkania jest nadal słabe.
Dla żywej komunikacji wielojęzycznej jakość tłumaczenia nie może być zatem mierzona tylko tym, czy słowa są poprawne.
Powinna również uwzględniać:
jak szybko rozpoczyna się przetłumaczony głos;
jak naturalnie uczestnicy mogą się wymieniać;
czy przerwania mogą być obsługiwane;
czy system rozumie kontekst rozmowy;
czy użytkownicy muszą czekać na pełne zdania;
jak dobrze rozmowa płynie w wielu językach.
Dlatego właśnie technologia tłumaczenia mowy na mowę w czasie rzeczywistym jest szczególnie ważna dla spotkań.
Mowa zawiera więcej niż słowa
Innym ograniczeniem konwersji mowy na zwykły tekst jest to, że ludzka mowa zawiera informacje, które trudno jest w pełni reprezentować w transkrypcji.
Ludzie komunikują się poprzez:
ton;
rytm;
pauzy;
nacisk;
wahanie;
tempo mówienia;
kontekst rozmowy.
Tradycyjne systemy STT najpierw kompresują mówioną wiadomość do tekstu.
Niektóre informacje z oryginalnego dźwięku mogą zatem zostać utracone, zanim tłumaczenie się nawet zacznie.
Nowoczesne modele mowy na mowę mogą pracować bezpośrednio z dźwiękiem i mają dostęp do większej części oryginalnego sygnału mowy.
To nie oznacza, że każdy niuans zawsze przetrwa tłumaczenie.
Ale stwarza możliwość znacznie bardziej naturalnych interakcji głosowych niż systemy zbudowane wyłącznie wokół tekstu.
Tłumaczenie mowy na mowę a tłumaczenie mowy na tekst
Te technologie są czasami mylone, ale rozwiązują różne problemy.
Tłumaczenie mowy na tekst konwertuje mowę na przetłumaczony tekst.
Na przykład:
Mowa japońska → Napisy angielskie
Jest to niezwykle przydatne dla napisów i dostępności.
Tłumaczenie mowy na mowę generuje przetłumaczony dźwięk:
Mowa japońska → Mowa angielska
To pozwala słuchaczowi śledzić rozmowę bez ciągłego czytania napisów.
Voicli obsługuje napisy na żywo jako część doświadczenia spotkania, ale tłumaczenie głosu jest zaprojektowane do czegoś szerszego: umożliwienia ludziom faktycznego rozmowy w różnych językach, zamiast po prostu czytania tłumaczeń tego, co powiedzieli inni.
Dlaczego Voicli używa tłumaczenia mowy na mowę w czasie rzeczywistym
Voicli został zbudowany wokół prostej idei:
Ludzie powinni być w stanie dołączyć do tego samego spotkania i mówić w języku, w którym czują się najwygodniej.
Jeden uczestnik może mówić po ukraińsku.
Inny może mówić po japońsku.
Inny może preferować angielski.
Inny może mówić po koreańsku.
Zamiast zmuszać wszystkich do przejścia na wspólny drugi język, Voicli obsługuje tłumaczenie podczas rozmowy.
Każdy uczestnik może wybrać język, w którym chce słyszeć.
Platforma może zapewnić przetłumaczony głos, napisy lub oryginalny dźwięk w zależności od preferencji słuchacza.
Dla tłumaczenia głosu na żywo Voicli używa architektury mowy na mowę w czasie rzeczywistym zamiast polegania wyłącznie na tradycyjnym:
STT → tłumaczenie tekstu → TTS
potokiem dla każdej przetłumaczonej wypowiedzi.
Ta różnica architektoniczna jest ważna, ponieważ Voicli nie próbuje budować narzędzia transkrypcji, które przypadkowo mówi przetłumaczony tekst.
Celem jest zbudowanie wielojęzycznej warstwy komunikacyjnej dla rzeczywistych rozmów.
Kiedy STT + Tłumaczenie + TTS jest nadal właściwym rozwiązaniem
Technologia mowy na mowę nie czyni tradycyjnych potoków przestarzałymi.
Istnieje wiele sytuacji, w których STT → tłumaczenie → TTS jest przydatne, a nawet preferowane.
Na przykład:
Transkrypty spotkań wymagają dokładnego tekstu.
Historia rozmów z możliwością wyszukiwania wymaga reprezentacji tekstowej.
Napisy naturalnie zależą od transkrypcji.
Systemy zgodności mogą potrzebować przechowywać dokładnie to, co zostało rozpoznane.
Tłumaczenie asynchroniczne nie wymaga niezwykle niskiego opóźnienia.
Specjalistyczne przepływy pracy mogą wymagać od deweloperów inspekcji i modyfikacji każdego etapu pośredniego.
Dlatego Voicli również używa różnych technologii AI w zależności od zadania.
Kluczem jest wybranie właściwej architektury dla budowanego doświadczenia.
Dla transkryptu tekst jest produktem.
Dla żywej rozmowy wielojęzycznej sama rozmowa jest produktem.
Od narzędzi tłumaczeniowych do rozmów wielojęzycznych
Przez dziesięciolecia tłumaczenie maszynowe było przede wszystkim kwestią konwersji informacji z jednego języka na inny.
Najpierw dokumenty.
Następnie strony internetowe.
Następnie wiadomości.
Następnie napisy.
Tłumaczenie mowy na mowę w czasie rzeczywistym reprezentuje inny kierunek.
Zamiast pytać:
„Jak szybko możemy przetłumaczyć to zdanie?"
ważniejsze pytanie staje się:
„Czy dwie osoby mówiące w różnych językach mogą komunikować się naturalnie?"
To zmienia sposób, w jaki systemy tłumaczeniowe muszą być zaprojektowane.
Opóźnienie staje się krytyczne.
Wymiana tur staje się krytyczna.
Jakość dźwięku staje się krytyczna.
Kontekst staje się krytyczny.
A tłumaczenie staje się częścią infrastruktury komunikacyjnej, a nie oddzielnym narzędziem, które ludzie świadomie używają.
Przyszłość spotkań wielojęzycznych
Długoterminowym celem tłumaczenia mowy nie jest sprawienie, aby ludzie częściej myśleli o technologii tłumaczeniowej.
To jest odwrotnie.
Tłumaczenie powinno stopniowo znikać w rozmowie.
Mówisz w swoim języku.
Druga osoba mówi w swoim.
A technologia obsługuje to, co się między wami dzieje.
Nadal będą wyzwania.
Akcenty, szum tła, terminologia specjalistyczna, nakładające się głosy, imiona i kontekst kulturowy mogą wszystkie wpłynąć na tłumaczenie AI.
Ale multimodalne modele działające w czasie rzeczywistym zmieniają to, co jest technicznie możliwe.
Przechodzimy od:
nagrywanie → transkrypcja → tłumaczenie → synteza → słuchanie
w kierunku:
mówienie → rozumienie → tłumaczenie → słyszenie
A ostatecznie, najbardziej udana technologia tłumaczeniowa może być technologią, którą uczestnicy ledwie zauważają.
Tłumaczenie w czasie rzeczywistym powinno być jak komunikacja
Nazwanie produktu „czasem rzeczywistym" jest łatwe.
Sprawienie, aby komunikacja wielojęzyczna faktycznie czuła się rzeczywista, jest znacznie trudniejsze.
Różnica nie polega tylko na milisekundach w benchmarku.
Chodzi o to, czy ludzie mogą mówić naturalnie.
Czy mogą odpowiedzieć bez czekania.
Czy spotkanie wielojęzyczne czuje się jak rozmowa, a nie sekwencja przetłumaczonych wiadomości.
To jest problem, nad którym pracuje Voicli.
Często zadawane pytania
Czym jest tłumaczenie mowy na mowę?
Tłumaczenie mowy na mowę konwertuje mowę bezpośrednio na wyjście mowy w innym języku. Nowoczesne systemy AI mogą przetwarzać wejście audio i generować przetłumaczony dźwięk w ramach sesji działającej w czasie rzeczywistym.
Jaka jest różnica między tłumaczeniem mowy na mowę a tłumaczeniem mowy na tekst?
Tłumaczenie mowy na tekst generuje przetłumaczony tekst pisany, taki jak napisy. Tłumaczenie mowy na mowę generuje przetłumaczony dźwięk, który słuchacz może słyszeć.
Jak działa tradycyjne tłumaczenie głosu?
Tradycyjne systemy zwykle używają trzech etapów: rozpoznawania mowy na tekst, tłumaczenia maszynowego i syntezy tekstu na mowę. Jest to często nazywane kaskadową architekturą tłumaczenia mowy.
Dlaczego STT → tłumaczenie → TTS może mieć wyższe opóźnienie?
Każdy etap musi przetwarzać informacje i przekazywać swoje wyjście do następnego komponentu. Skumulowany czas przetwarzania może wprowadzić dodatkowe opóźnienie, podczas gdy błędy z jednego etapu mogą również wpłynąć na kolejne etapy.
Czy tłumaczenie mowy na mowę to to samo co jednoczesna interpretacja?
Są to powiązane koncepcje, ale nie identyczne. Jednoczesna interpretacja człowieka jest wykonywana przez profesjonalnych tłumaczy. Tłumaczenie mowy na mowę AI próbuje zapewnić podobne doświadczenie komunikacji wielojęzycznej z niskim opóźnieniem automatycznie.
Czy tłumaczenie mowy na mowę można używać na spotkaniach biznesowych?
Tak. Tłumaczenie mowy na mowę w czasie rzeczywistym jest szczególnie przydatne na spotkaniach międzynarodowych, rozmowach z klientami, rozmowach sprzedażowych, zespołach zdalnych, wywiadach i innych sytuacjach, w których uczestnicy nie mówią w tym samym języku.
Co robi Voicli?
Voicli to wielojęzyczna platforma komunikacji wideo z tłumaczeniem głosu w czasie rzeczywistym i napisami na żywo. Uczestnicy mogą mówić w preferowanych przez nich językach, podczas gdy Voicli obsługuje tłumaczenie podczas rozmowy.
Spróbuj Voicli i mów w swoim języku. Niech spotkanie obsługuje tłumaczenie.