Tradução de Fala em Tempo Real: Por Que Nem Toda Tradução de Voz "em Tempo Real" é Igual
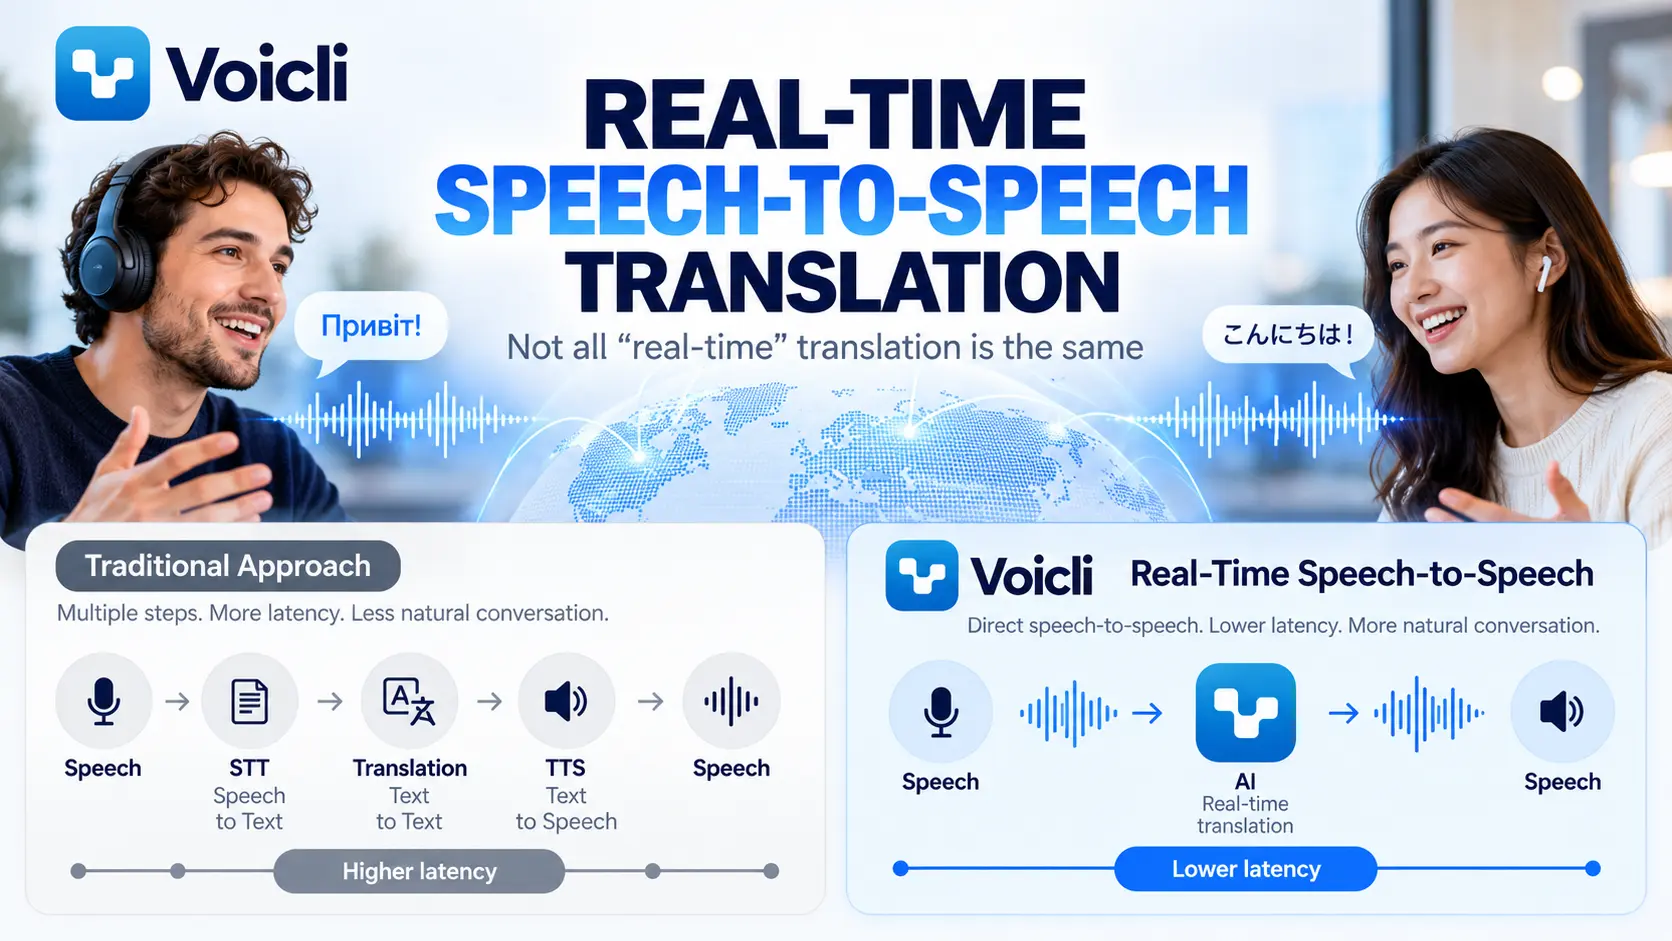
A tradução de voz em tempo real está se tornando um recurso comum em plataformas de reuniões, ferramentas de comunicação e aplicações de IA.
Mas há um detalhe importante que frequentemente fica oculto atrás das palavras "tradução em tempo real."
Dois produtos podem dizer que traduzem fala em tempo real enquanto usam tecnologias muito diferentes por baixo.
Um pode processar uma conversa assim:
Fala → transcrição → tradução de texto → conversão de texto em fala → áudio traduzido
Outro pode processar a interação como uma experiência contínua de tradução de fala para fala, onde o áudio é compreendido e traduzido diretamente dentro de um modelo multimodal em tempo real.
Ambas as abordagens podem produzir fala traduzida.
Mas não necessariamente criam a mesma experiência de conversa.
Na Voicli, nossa tradução de voz ao vivo é projetada em torno da tradução de fala em tempo real, permitindo que os participantes falem naturalmente em seus próprios idiomas enquanto a fala traduzida é gerada para as pessoas que estão ouvindo.
Então, o que exatamente é tradução de fala para fala e por que a arquitetura importa?
O Que É Tradução de Fala em Tempo Real?
Tradução de fala para fala (S2ST) é a tecnologia que recebe linguagem falada e produz saída falada em outro idioma.
Em um sistema ao vivo, esse processo acontece continuamente enquanto as pessoas estão tendo uma conversa.
Por exemplo:
Uma pessoa fala ucraniano.
Outro participante quer ouvir em inglês.
O sistema ouve a fala em ucraniano, compreende seu significado, traduz e gera áudio em inglês para o ouvinte.
O objetivo não é simplesmente traduzir palavras.
O objetivo é fazer a comunicação entre pessoas que falam idiomas diferentes parecer o mais próximo possível de uma conversa normal.
Essa distinção se torna importante quando comparamos sistemas modernos de fala para fala com pipelines tradicionais de tradução de voz.
A Abordagem Tradicional: STT → Tradução → TTS
Por muitos anos, os sistemas de tradução de voz foram construídos a partir de várias tecnologias separadas.
A arquitetura geralmente se parece com isto:
1. Conversão de Fala em Texto (STT)
O áudio do falante é convertido em texto escrito.
↓
2. Tradução Automática (MT)
O texto escrito é traduzido para outro idioma.
↓
3. Conversão de Texto em Fala (TTS)
O texto traduzido é convertido novamente em fala artificial.
O pipeline completo se torna:
Áudio → STT → Texto → Tradução → Texto → TTS → Áudio
Essa arquitetura funciona.
Na verdade, ela alimentou muitos sistemas de tradução de fala por anos.
Também é útil quando o objetivo principal é transcrição, legendas, notas de reunião pesquisáveis ou situações em que os desenvolvedores precisam de controle completo sobre cada estágio de processamento.
Mas a conversa humana ao vivo introduz outro requisito:
velocidade.
Por Que um Pipeline de Tradução em Cascata Pode Parecer Lento
Cada etapa em um pipeline tradicional de tradução de voz leva tempo.
O sistema de reconhecimento de fala precisa de áudio suficiente para entender o que foi dito.
Depois o sistema de tradução processa o texto resultante.
Depois o sistema de conversão de texto em fala gera um novo fluxo de áudio.
Cada componente individual pode ser rápido.
Mas seus atrasos podem se acumular.
Há outro problema.
Cada estágio depende da saída do estágio anterior.
Se o reconhecimento de fala entender mal uma palavra, o modelo de tradução recebe o texto errado.
Se a tradução mudar o significado, o sistema TTS simplesmente fala esse texto traduzido.
Em outras palavras, os erros podem se propagar pelo pipeline:
Erro de reconhecimento de fala → erro de tradução → erro de tradução falada
Durante a tradução de documentos isso pode ser aceitável.
Durante uma conversa ao vivo, até alguns segundos extras ou uma pausa desconfortável podem mudar completamente como a comunicação se sente.
As pessoas param de falar naturalmente.
Elas esperam.
Elas verificam se a tradução terminou.
Depois a outra pessoa responde.
Em vez de uma conversa, a comunicação começa a parecer como alternar turnos com uma máquina.
Tradução de Fala para Fala Nativa em Tempo Real Muda a Arquitetura
Modelos modernos de IA multimodal podem trabalhar com entrada de áudio e saída de áudio dentro da mesma interação em tempo real.
Em vez de exigir que os desenvolvedores conectem três sistemas independentes para cada frase falada, um modelo em tempo real pode processar continuamente o áudio recebido e gerar saída falada.
Do ponto de vista do usuário, o fluxo se torna muito mais próximo de:
Fala → compreensão e tradução de IA → Fala
Isso é geralmente referido como tradução de fala em tempo real.
A distinção importante não é que o texto nunca pode existir em nenhum lugar dentro de um modelo de IA.
Modelos modernos podem usar muitas representações internas.
A diferença é arquitetônica:
A conversa ao vivo não precisa esperar por um serviço de transcrição separado, depois um serviço de tradução de texto separado e depois um serviço de síntese de fala separado antes que o áudio traduzido possa começar.
Isso torna possível um tipo muito diferente de interação.
"Em Tempo Real" Nem Sempre Significa a Mesma Coisa
O termo tradução em tempo real é usado amplamente em toda a indústria.
Um produto pode tecnicamente se chamar em tempo real se gerar uma tradução alguns segundos depois que alguém fala.
Para legendas, isso pode ser perfeitamente aceitável.
Mas a conversa humana é muito mais sensível ao atraso.
Considere duas experiências.
Experiência A: Tradução em Cascata
Você fala.
O sistema espera por áudio suficiente.
Sua fala se torna texto.
O texto é traduzido.
O texto traduzido é enviado para um gerador de voz.
O outro participante ouve a tradução.
Depois ele responde.
Experiência B: Tradução de Fala em Tempo Real
Você começa a falar.
O modelo processa o fluxo de áudio como parte de uma sessão contínua.
Ele compreende a conversa em andamento e começa a gerar fala traduzida com significativamente menos dependência de estágios de processamento separados.
A conversa se torna mais próxima da alternância natural de turnos.
Ambos os sistemas podem tecnicamente ser descritos como "em tempo real".
Mas a experiência pode ser muito diferente.
Por Que a Latência Importa Mais do Que a Maioria dos Benchmarks de Tradução
Produtos de tradução são frequentemente avaliados por precisão.
A precisão é obviamente importante.
Mas durante a comunicação ao vivo há outra dimensão igualmente importante:
latência de conversa.
Imagine uma reunião de negócios com seis pessoas falando vários idiomas.
Se cada frase traduzida introduzir vários segundos de silêncio, esses atrasos se multiplicam ao longo da reunião.
Os participantes começam a interromper as traduções.
Algumas pessoas começam a falar antes que as traduções anteriores tenham terminado.
Outras param de participar porque acompanhar a conversa se torna difícil.
A tradução em si pode estar correta enquanto a experiência da reunião ainda é ruim.
Para comunicação multilíngue ao vivo, a qualidade da tradução portanto não pode ser medida apenas por se as palavras estão corretas.
Também deve considerar:
com que rapidez a fala traduzida começa;
como naturalmente os participantes podem alternar turnos;
se as interrupções podem ser tratadas;
se o sistema compreende o contexto conversacional;
se os usuários precisam esperar por frases completas;
como bem a conversa flui entre vários idiomas.
É por isso que a tecnologia de tradução de fala em tempo real é especialmente importante para reuniões.
A Fala Contém Mais do Que Palavras
Outra limitação de converter fala em texto simples é que a fala humana contém informações que são difíceis de representar completamente em uma transcrição.
As pessoas se comunicam através de:
tom;
ritmo;
pausas;
ênfase;
hesitação;
velocidade de fala;
contexto conversacional.
Os sistemas STT tradicionais primeiro comprimem a mensagem falada em texto.
Algumas informações do áudio original podem portanto ser perdidas antes mesmo da tradução começar.
Modelos modernos de fala para fala podem trabalhar diretamente com áudio e têm acesso a mais do sinal de fala original.
Isso não significa que toda nuance sempre sobreviverá à tradução.
Mas cria a possibilidade de interações de voz muito mais naturais do que sistemas construídos apenas em torno de texto.
Tradução de Fala para Fala vs Tradução de Fala para Texto
Essas tecnologias às vezes são confundidas, mas resolvem problemas diferentes.
Tradução de fala para texto converte linguagem falada em texto traduzido.
Por exemplo:
Fala em japonês → legendas em inglês
Isso é extremamente útil para legendas e acessibilidade.
Tradução de fala para fala produz áudio traduzido:
Fala em japonês → fala em inglês
Isso permite que o ouvinte acompanhe a conversa sem estar constantemente lendo legendas.
Voicli suporta legendas ao vivo como parte da experiência de reunião, mas a tradução de voz é projetada para algo mais amplo: permitir que as pessoas realmente conversem entre idiomas, em vez de simplesmente ler traduções do que outros disseram.
Por Que Voicli Usa Tradução de Fala em Tempo Real
Voicli foi construída em torno de uma ideia simples:
As pessoas devem ser capazes de participar da mesma reunião e falar o idioma em que se sentem mais confortáveis.
Um participante pode falar ucraniano.
Outro pode falar japonês.
Outro pode preferir inglês.
Outro pode falar coreano.
Em vez de forçar todos a mudar para um idioma comum de segunda língua, Voicli lida com a tradução durante a conversa.
Cada participante pode selecionar o idioma que deseja ouvir.
A plataforma pode fornecer voz traduzida, legendas ou o áudio original dependendo da preferência do ouvinte.
Para tradução de voz ao vivo, Voicli usa uma arquitetura de fala para fala em tempo real em vez de depender exclusivamente da tradicional:
STT → tradução de texto → TTS
pipeline para cada enunciado traduzido.
Essa diferença arquitetônica é importante porque Voicli não está tentando construir uma ferramenta de transcrição que aconteça a falar texto traduzido.
O objetivo é construir uma camada de comunicação multilíngue para conversas reais.
Quando STT + Tradução + TTS Ainda é a Solução Certa
A tecnologia de fala para fala não torna os pipelines tradicionais obsoletos.
Há muitas situações em que STT → tradução → TTS é útil ou até preferível.
Por exemplo:
Transcrições de reuniões precisam de texto preciso.
Histórico de conversa pesquisável requer representação em texto.
Legendas naturalmente dependem de transcrição.
Sistemas de conformidade podem precisar armazenar exatamente o que foi reconhecido.
Tradução assíncrona não requer latência extremamente baixa.
Fluxos de trabalho especializados podem precisar que os desenvolvedores inspecionem e modifiquem cada estágio intermediário.
É por isso que Voicli também usa diferentes tecnologias de IA dependendo da tarefa.
A chave é escolher a arquitetura correta para a experiência que está sendo construída.
Para uma transcrição, o texto é o produto.
Para uma conversa multilíngue ao vivo, a conversa em si é o produto.
De Ferramentas de Tradução para Conversas Multilíngues
Por décadas, a tradução automática foi principalmente sobre converter informações de um idioma para outro.
Primeiro documentos.
Depois sites.
Depois mensagens.
Depois legendas.
A tradução de fala em tempo real representa uma direção diferente.
Em vez de perguntar:
"Com que rapidez podemos traduzir essa frase?"
a pergunta mais importante se torna:
"Duas pessoas que falam idiomas diferentes podem se comunicar naturalmente?"
Isso muda como os sistemas de tradução precisam ser projetados.
A latência se torna crítica.
A alternância de turnos se torna crítica.
A qualidade de áudio se torna crítica.
O contexto se torna crítico.
E a tradução se torna parte da infraestrutura de comunicação em vez de uma ferramenta separada que as pessoas usam conscientemente.
O Futuro das Reuniões Multilíngues
O objetivo de longo prazo da tradução de fala não é fazer as pessoas pensarem sobre tecnologia de tradução com mais frequência.
É o oposto.
A tradução deve gradualmente desaparecer na conversa.
Você fala seu idioma.
A outra pessoa fala o dela.
E a tecnologia lida com o que acontece entre vocês.
Ainda haverá desafios.
Sotaques, ruído de fundo, terminologia específica do domínio, falantes sobrepostos, nomes e contexto cultural podem todos afetar a tradução de IA.
Mas modelos multimodais em tempo real estão mudando o que é tecnicamente possível.
Estamos nos movendo de:
gravar → transcrever → traduzir → sintetizar → ouvir
para:
falar → compreender → traduzir → ouvir
E eventualmente, a tecnologia de tradução mais bem-sucedida pode ser a tecnologia que os participantes mal percebem.
Tradução em Tempo Real Deve Parecer Comunicação
Chamar um produto de "em tempo real" é fácil.
Fazer a comunicação multilíngue realmente parecer em tempo real é muito mais difícil.
A diferença não é apenas milissegundos em um benchmark.
É se as pessoas podem falar naturalmente.
Se elas podem responder sem esperar.
Se uma reunião multilíngue parece uma conversa em vez de uma sequência de mensagens traduzidas.
Esse é o problema em que Voicli está trabalhando.
Tradução de fala em tempo real para conversas onde todos podem falar seu próprio idioma.
Perguntas Frequentes
O que é tradução de fala para fala?
Tradução de fala para fala converte linguagem falada diretamente em saída falada em outro idioma. Sistemas modernos de IA podem processar entrada de áudio e gerar áudio traduzido dentro de uma sessão em tempo real.
Qual é a diferença entre tradução de fala para fala e tradução de fala para texto?
Tradução de fala para texto produz texto escrito traduzido, como legendas. Tradução de fala para fala produz áudio traduzido que o ouvinte pode ouvir.
Como funciona a tradução de voz tradicional?
Os sistemas tradicionais geralmente usam três estágios: reconhecimento de fala para texto, tradução automática e síntese de texto para fala. Isso é frequentemente chamado de arquitetura de tradução de fala em cascata.
Por que STT → tradução → TTS pode ter latência mais alta?
Cada estágio deve processar informações e passar sua saída para o próximo componente. O tempo de processamento acumulado pode introduzir atraso adicional, enquanto erros de um estágio também podem afetar estágios subsequentes.
A tradução de fala para fala é a mesma que interpretação simultânea?
São conceitos relacionados, mas não idênticos. A interpretação simultânea humana é realizada por intérpretes profissionais. A tradução de fala para fala de IA tenta fornecer uma experiência de comunicação multilíngue com baixo atraso semelhante automaticamente.
A tradução de fala para fala pode ser usada em reuniões de negócios?
Sim. A tradução de fala para fala em tempo real é particularmente útil para reuniões internacionais, chamadas com clientes, conversas de vendas, equipes remotas, entrevistas e outras situações em que os participantes não compartilham o mesmo idioma.
O que Voicli faz?
Voicli é uma plataforma de comunicação por vídeo multilíngue com tradução de voz em tempo real e legendas ao vivo. Os participantes podem falar seus idiomas preferidos enquanto Voicli lida com a tradução durante a conversa.
Experimente Voicli e fale seu idioma. Deixe a reunião lidar com a tradução.