Traducerea în Timp Real Vorbire-Vorbire: De Ce Nu Toate Traducerile Vocale „în Timp Real" Sunt Identice
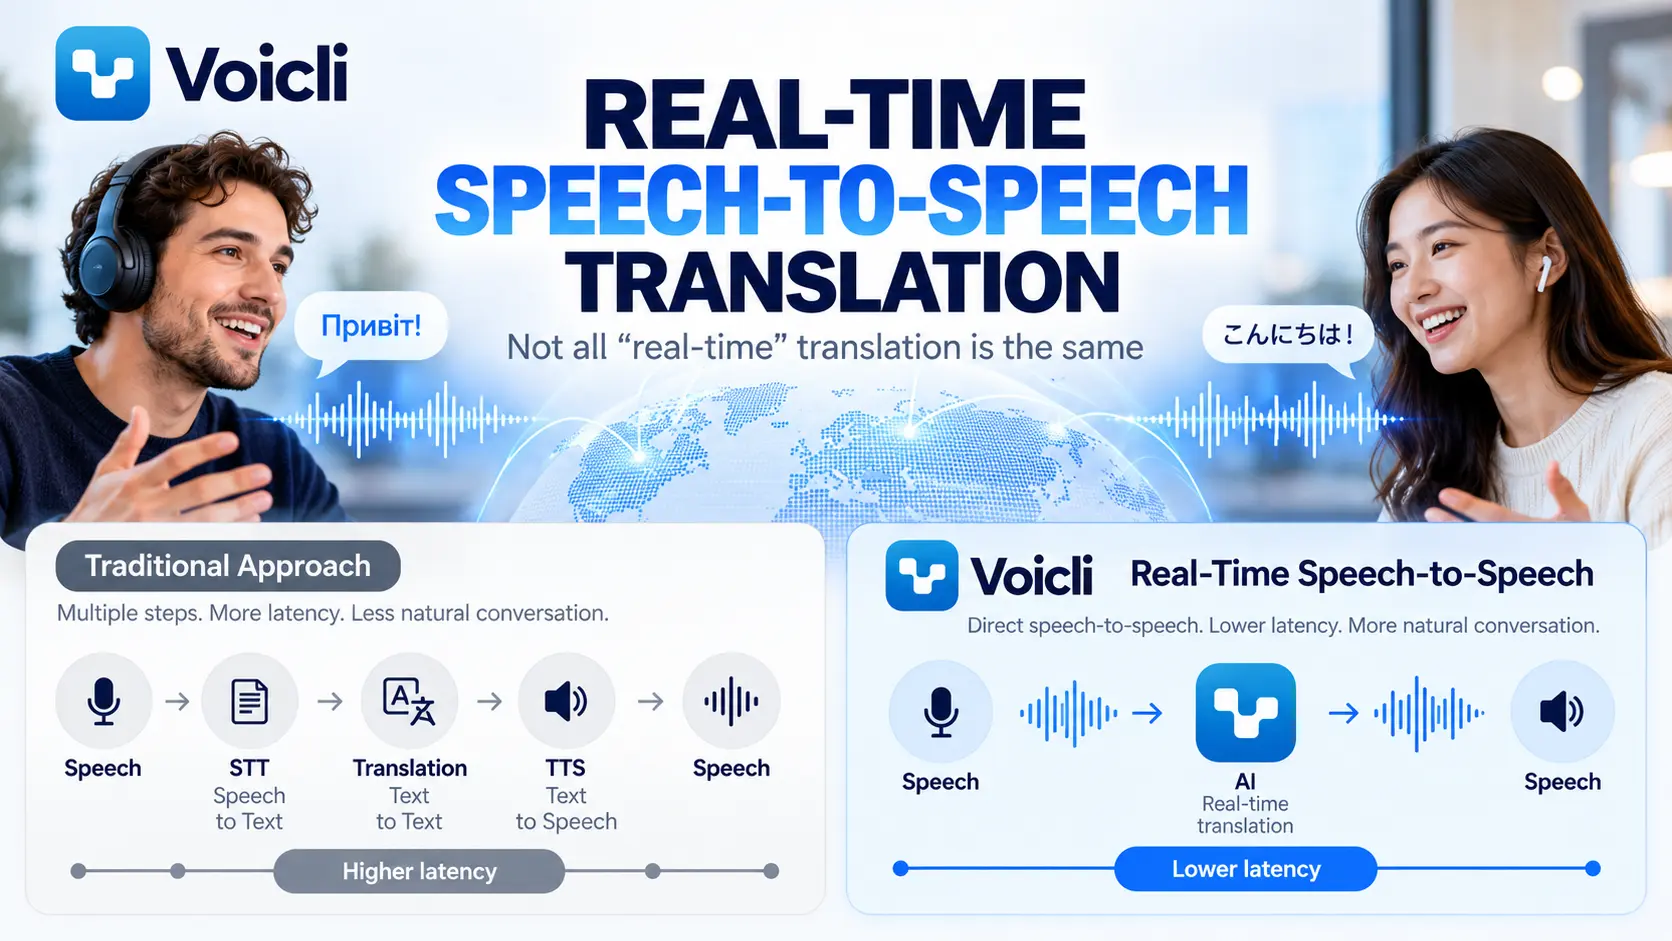
Key Takeaways
- Traducerea în timp real vorbire-vorbire procesează audio direct și generează vorbire tradusă în cadrul unei sesiuni continue, spre deosebire de sistemele tradiționale care convertesc vorbirea în text, traduc textul și apoi sintetizează din nou în vorbire.
- Conductele STT → traducere → TTS pot introduce latență mai mare deoarece fiecare etapă trebuie să se termine înainte ca următoarea să înceapă, iar erorile dintr-o etapă pot afecta etapele ulterioare.
- Pentru conversațiile multilingve în direct, latența și fluxul natural sunt la fel de importante ca și acuratețea traducerii, deoarece întârzierile pot face comunicarea să se simtă nenatural.
- Vorbirea conține informații cum ar fi tonul, ritmul, pauzele și contextul care pot fi pierdute atunci când este convertită în text, iar modelele vorbire-vorbire pot păstra mai mult din semnalul original.
- Voicli folosește arhitectura vorbire-vorbire pentru a permite participanților să vorbească în propriile lor limbi în timp ce traducerea se întâmplă în fundal, creând o experiență de comunicare mai naturală decât sistemele tradiționale de traducere.
Traducerea vocală în timp real devine o caracteristică comună în platformele de întâlniri, instrumentele de comunicare și aplicațiile AI.
Dar există un detaliu important care este adesea ascuns în spatele cuvintelor "traducere în timp real."
Două produse pot spune că traduc vorbirea în timp real, folosind tehnologii foarte diferite în spate.
Una poate procesa o conversație în felul acesta:
Vorbire → transcriere → traducere text → text-to-speech → audio tradus
Alta poate procesa interacțiunea ca o experiență continuă vorbire-vorbire, unde audio-ul este înțeles și tradus direct într-un model multimodal în timp real.
Ambele abordări pot produce vorbire tradusă.
Dar nu creează neapărat aceeași experiență de conversație.
La Voicli, traducerea vocală în direct este proiectată în jurul traducerii în timp real vorbire-vorbire, permițând participanților să vorbească natural în propriile lor limbi, în timp ce vorbirea tradusă este generată pentru persoanele care ascultă.
Deci ce este exact traducerea vorbire-vorbire și de ce contează arhitectura?
Ce Este Traducerea în Timp Real Vorbire-Vorbire?
Traducerea vorbire-vorbire (S2ST) este tehnologia care primește limbaj vorbit și produce ieșire vocală într-o altă limbă.
Într-un sistem în direct, acest proces se întâmplă continuu în timp ce oamenii au o conversație.
De exemplu:
O persoană vorbește ucraineană.
Un alt participant dorește să audă engleză.
Sistemul ascultă vorbirea ucraineană, înțelege sensul acesteia, o traduce și generează audio în engleză pentru ascultător.
Scopul nu este pur și simplu să traducă cuvinte.
Scopul este să facă comunicarea între persoane care vorbesc limbi diferite să se simtă cât mai aproape posibil de o conversație normală.
Această distincție devine importantă atunci când comparăm sistemele moderne vorbire-vorbire cu conductele tradiționale de traducere vocală.
Abordarea Tradițională: STT → Traducere → TTS
De mulți ani, sistemele de traducere vocală au fost construite din mai multe tehnologii separate.
Arhitectura arată de obicei în felul acesta:
1. Vorbire-Text (STT)
Audio-ul vorbitorului este convertit în text scris.
↓
2. Traducere Automată (MT)
Textul scris este tradus într-o altă limbă.
↓
3. Text-Vorbire (TTS)
Textul tradus este convertit înapoi în vorbire artificială.
Conducta completă devine:
Audio → STT → Text → Traducere → Text → TTS → Audio
Această arhitectură funcționează.
De fapt, a alimentat multe sisteme de traducere vocală de-a lungul anilor.
Este, de asemenea, utilă atunci când scopul principal este transcriere, subtitrări, note de întâlnire căutabile, sau situații în care dezvoltatorii au nevoie de control complet asupra fiecărei etape de procesare.
Dar conversația umană în direct introduce o altă cerință:
viteza.
De Ce o Conductă de Traducere în Cascadă Poate Părea Lentă
Fiecare pas într-o conductă tradițională de traducere vocală durează timp.
Sistemul de recunoaștere vocală are nevoie de suficient audio pentru a înțelege ce s-a spus.
Apoi sistemul de traducere procesează textul rezultat.
Apoi sistemul text-to-speech generează un nou flux audio.
Fiecare componentă individuală poate fi rapidă.
Dar întârzierile lor pot se acumula.
Există o altă problemă.
Fiecare etapă depinde de ieșirea etapei anterioare.
Dacă recunoașterea vocală înțelege greșit un cuvânt, modelul de traducere primește textul greșit.
Dacă traducerea schimbă sensul, sistemul TTS pur și simplu pronunță acel text tradus.
Cu alte cuvinte, erorile pot se propaga prin conductă:
Eroare de recunoaștere vocală → eroare de traducere → eroare de vorbire tradusă
În timpul traducerii de documente, aceasta poate fi acceptabilă.
În timpul unei conversații în direct, chiar și câteva secunde suplimentare sau o pauză stânjenitoare pot schimba complet modul în care se simte comunicarea.
Oamenii încetează să vorbească natural.
Așteaptă.
Verifică dacă traducerea s-a terminat.
Apoi cealaltă persoană răspunde.
În loc de o conversație, comunicarea începe să se simtă ca luarea de ture cu o mașină.
Traducerea Nativă în Timp Real Vorbire-Vorbire Schimbă Arhitectura
Modelele AI multimodale moderne pot lucra cu intrare audio și ieșire audio în cadrul aceleiași interacțiuni în timp real.
În loc să necesite dezvoltatorilor să conecteze trei sisteme independente pentru fiecare frază vorbită, un model în timp real poate procesa continuu audio-ul care intră și genera ieșire vocală.
Din perspectiva utilizatorului, fluxul devine mult mai apropiat de:
Vorbire → Înțelegere și traducere AI → Vorbire
Aceasta este în general denumită traducere în timp real vorbire-vorbire.
Distincția importantă nu este că textul nu poate exista niciodată nicăieri în interiorul unui model AI.
Modelele moderne pot folosi multe reprezentări interne.
Diferența este arhitecturală:
Conversația în direct nu trebuie să aștepte un serviciu de transcriere separat, apoi un serviciu de traducere text separat și apoi un serviciu de sinteză vocală separat înainte ca audio-ul tradus să poată începe.
Aceasta face posibilă un tip foarte diferit de interacțiune.
„În Timp Real" Nu Înseamnă Întotdeauna Același Lucru
Termenul traducere în timp real este folosit pe scară largă în industrie.
Un produs poate din punct de vedere tehnic să se numească în timp real dacă generează o traducere câteva secunde după ce cineva vorbește.
Pentru subtitrări, aceasta poate fi perfect acceptabilă.
Dar conversația umană este mult mai sensibilă la întârziere.
Luați în considerare două experiențe.
Experiența A: Traducere în Cascadă
Vorbești.
Sistemul așteaptă suficient audio.
Vorbirea ta devine text.
Textul este tradus.
Textul tradus este trimis unui generator de voce.
Celălalt participant aude traducerea.
Apoi răspund.
Experiența B: Traducere în Timp Real Vorbire-Vorbire
Începi să vorbești.
Modelul procesează fluxul audio ca parte a unei sesiuni continue.
Înțelege conversația în curs și începe să genereze vorbire tradusă cu dependență semnificativ mai mică de etapele de procesare separate.
Conversația devine mai aproape de luarea naturală de ture.
Ambele sisteme pot fi descrise din punct de vedere tehnic ca „în timp real."
Dar experiența poate fi foarte diferită.
De Ce Latența Contează Mai Mult Decât Majoritatea Benchmark-urilor de Traducere
Produsele de traducere sunt adesea evaluate după acuratețe.
Acuratețea este evident importantă.
Dar în timpul comunicării în direct, există o altă dimensiune la fel de importantă:
latența conversației.
Imaginați-vă o întâlnire de afaceri cu șase persoane vorbind mai multe limbi.
Dacă fiecare propoziție tradusă introduce câteva secunde de tăcere, acele întârzieri se înmulțesc pe parcursul întâlnirii.
Participanții încep să întrerupă traducerile.
Unii oameni încep să vorbească înainte ca traducerile anterioare să se fi terminat.
Alții încetează să participe pentru că urmărirea conversației devine dificilă.
Traducerea în sine poate fi corectă, în timp ce experiența întâlnirii este încă slabă.
Pentru comunicarea multilingvă în direct, calitatea traducerii nu poate fi măsurată deci doar prin faptul că cuvintele sunt corecte.
Ar trebui, de asemenea, să ia în considerare:
cât de repede începe vorbirea tradusă;
cât de natural pot participanții să ia ture;
dacă întreruperile pot fi gestionate;
dacă sistemul înțelege contextul conversației;
dacă utilizatorii trebuie să aștepte propoziții complete;
cât de bine curge conversația în mai multe limbi.
Aceasta este motivul pentru care tehnologia în timp real vorbire-vorbire este deosebit de importantă pentru întâlniri.
Vorbirea Conține Mai Mult Decât Cuvinte
O altă limitare a convertării vorbirii în text simplu este că vorbirea umană conține informații care sunt dificil de reprezentat complet într-o transcriere.
Oamenii comunică prin:
ton;
ritm;
pauze;
accent;
ezitare;
viteză de vorbire;
context conversațional.
Sistemele STT tradiționale comprimează mai întâi mesajul vorbit în text.
Unele informații din audio-ul original pot fi deci pierdute înainte ca traducerea să înceapă.
Modelele moderne vorbire-vorbire pot lucra direct cu audio și au acces la mai mult din semnalul de vorbire original.
Aceasta nu înseamnă că fiecare nuanță va supraviețui întotdeauna traducerii.
Dar creează posibilitatea unor interacțiuni vocale mult mai naturale decât sistemele construite doar în jurul textului.
Traducere Vorbire-Vorbire vs Traducere Vorbire-Text
Aceste tehnologii sunt uneori confundate, dar rezolvă probleme diferite.
Traducerea vorbire-text convertește limbajul vorbit în text tradus.
De exemplu:
Vorbire japoneză → Subtitrări în engleză
Aceasta este extrem de utilă pentru subtitrări și accesibilitate.
Traducerea vorbire-vorbire produce audio tradus:
Vorbire japoneză → Vorbire în engleză
Aceasta permite ascultătorului să urmărească conversația fără a citi constant subtitrări.
Voicli suportă subtitrări în direct ca parte a experienței de întâlnire, dar traducerea vocală este proiectată pentru ceva mai larg: permițând oamenilor să vorbească în mai multe limbi, mai degrabă decât pur și simplu să citească traduceri ale ceea ce au spus alții.
De Ce Voicli Folosește Traducerea în Timp Real Vorbire-Vorbire
Voicli a fost construit în jurul unei idei simple:
Oamenii ar trebui să poată participa la aceeași întâlnire și să vorbească limba în care se simt cel mai confortabil.
Un participant ar putea vorbi ucraineană.
Altul ar putea vorbi japoneză.
Altul ar putea prefera engleză.
Altul ar putea vorbi coreeană.
În loc să forțeze pe toată lumea să treacă la o limbă comună secundară, Voicli gestionează traducerea în timpul conversației.
Fiecare participant poate selecta limba pe care dorește să o audă.
Platforma poate furniza voce tradusă, subtitrări sau audio-ul original în funcție de preferința ascultătorului.
Pentru traducerea vocală în direct, Voicli folosește o arhitectură în timp real vorbire-vorbire mai degrabă decât să se bazeze exclusiv pe:
STT → traducere text → TTS
conducta pentru fiecare enunț tradus.
Acea diferență arhitecturală este importantă pentru că Voicli nu încearcă să construiască un instrument de transcriere care se întâmplă să vorbească text tradus.
Scopul este să construiască un strat de comunicare multilingv pentru conversații reale.
Când STT + Traducere + TTS Este Încă Soluția Corectă
Tehnologia vorbire-vorbire nu face conductele tradiționale obsolete.
Există multe situații în care STT → traducere → TTS este utilă sau chiar preferabilă.
De exemplu:
Transcripțiile întâlnirilor au nevoie de text precis.
Istoricul conversației căutabil necesită reprezentare text.
Subtitrările depind în mod natural de transcriere.
Sistemele de conformitate pot avea nevoie să stocheze exact ceea ce a fost recunoscut.
Traducerea asincronă nu necesită latență extrem de scăzută.
Fluxurile de lucru specializate pot necesita dezvoltatorilor să inspecteze și să modifice fiecare etapă intermediară.
Aceasta este motivul pentru care Voicli folosește, de asemenea, tehnologii AI diferite în funcție de sarcină.
Cheia este alegerea arhitecturii corecte pentru experiența care se construiește.
Pentru o transcriere, textul este produsul.
Pentru o conversație multilingvă în direct, conversația în sine este produsul.
De la Instrumente de Traducere la Conversații Multilingve
De decenii, traducerea automată a fost în principal despre convertirea informațiilor dintr-o limbă în alta.
Mai întâi documente.
Apoi site-uri web.
Apoi mesaje.
Apoi subtitrări.
Traducerea în timp real vorbire-vorbire reprezintă o direcție diferită.
În loc să întrebăm:
„Cât de repede putem traduce această propoziție?"
întrebarea mai importantă devine:
„Pot două persoane care vorbesc limbi diferite să comunice natural?"
Aceasta schimbă modul în care trebuie să fie proiectate sistemele de traducere.
Latența devine critică.
Luarea de ture devine critică.
Calitatea audio devine critică.
Contextul devine critic.
Și traducerea devine parte a infrastructurii de comunicare mai degrabă decât un instrument separat pe care oamenii îl folosesc în mod conștient.
Viitorul Întâlnirilor Multilingve
Scopul pe termen lung al traducerii vocale nu este să facă oamenii să gândească mai des la tehnologia de traducere.
Este opusul.
Traducerea ar trebui să dispară treptat în conversație.
Tu vorbești limba ta.
Cealaltă persoană vorbește a ei.
Și tehnologia gestionează ceea ce se întâmplă între voi.
Vor mai fi provocări.
Accentele, zgomotul de fundal, terminologia specifică domeniului, vorbitorii care se suprapun, numele și contextul cultural pot afecta traducerea AI.
Dar modelele multimodale în timp real schimbă ceea ce este posibil din punct de vedere tehnic.
Ne mutăm de la:
înregistrare → transcriere → traducere → sinteză → ascultare
către:
vorbire → înțelegere → traducere → ascultare
Și în cele din urmă, cea mai reușită tehnologie de traducere poate fi tehnologia pe care participanții abia o observă.
Traducerea în Timp Real Ar Trebui Să Se Simtă Ca Comunicare
Numirea unui produs „în timp real" este ușoară.
Făcând comunicarea multilingvă să se simtă de fapt în timp real este mult mai greu.
Diferența nu este doar milisecunde pe un benchmark.
Este dacă oamenii pot vorbi natural.
Dacă pot răspunde fără să aștepte.
Dacă o întâlnire multilingvă se simte ca o conversație mai degrabă decât o succesiune de mesaje traduse.
Aceasta este problema pe care Voicli o rezolvă.
Traducere în timp real vorbire-vorbire pentru conversații în care toată lumea poate vorbi propria limbă.
Întrebări Frecvente
Ce este traducerea vorbire-vorbire?
Traducerea vorbire-vorbire convertește limbajul vorbit direct în ieșire vocală într-o altă limbă. Sistemele AI moderne pot procesa intrare audio și genera audio tradus într-o sesiune în timp real.
Care este diferența dintre traducerea vorbire-vorbire și traducerea vorbire-text?
Traducerea vorbire-text produce text scris tradus, cum ar fi subtitrări. Traducerea vorbire-vorbire produce audio tradus pe care ascultătorul îl poate auzi.
Cum funcționează traducerea vocală tradițională?
Sistemele tradiționale folosesc în mod obișnuit trei etape: recunoaștere vorbire-text, traducere automată și sinteză text-vorbire. Aceasta este adesea numită arhitectură de traducere vocală în cascadă.
De ce poate STT → traducere → TTS să aibă latență mai mare?
Fiecare etapă trebuie să proceseze informații și să transmită ieșirea sa componentei următoare. Timpul de procesare acumulat poate introduce întârziere suplimentară, în timp ce erorile dintr-o etapă pot afecta și etapele ulterioare.
Este traducerea vorbire-vorbire la fel cu interpretarea simultană?
Sunt concepte conexe, dar nu identice. Interpretarea simultană umană este efectuată de interpreți profesioniști. Traducerea vorbire-vorbire AI încearcă să furnizeze o experiență similară de comunicare multilingvă cu latență scăzută în mod automat.
Poate traducerea vorbire-vorbire să fie folosită pentru întâlniri de afaceri?
Da. Traducerea în timp real vorbire-vorbire este deosebit de utilă pentru întâlniri internaționale, apeluri cu clienți, conversații de vânzări, echipe la distanță, interviuri și alte situații în care participanții nu împărtășesc aceeași limbă.
Ce face Voicli?
Voicli este o platformă de comunicare video multilingvă cu traducere vocală în timp real și subtitrări în direct. Participanții pot vorbi limbile preferate în timp ce Voicli gestionează traducerea în timpul conversației.
Încearcă Voicli și vorbește-ți limba. Lasă întâlnirea să gestioneze traducerea.