Перевод речи в реальном времени: почему не все «реальное время» в переводе голоса одинаковое
Key Takeaways
- Перевод речи в реальном времени обрабатывает аудио непосредственно в одной модели, в отличие от традиционных систем, которые разделяют процесс на отдельные этапы распознавания, перевода и синтеза.
- Каскадные конвейеры STT → перевод → TTS могут накапливать задержки и распространять ошибки, что делает живое общение менее естественным.
- Для многоязычного общения задержка и естественность разговора часто важнее, чем точность отдельных слов.
- Современные мультимодальные модели ИИ могут работать непосредственно с аудиосигналом, сохраняя тон, ритм и контекст, которые теряются при преобразовании в текст.
- Перевод речи в речь и перевод речи в текст решают разные проблемы: первый для живого общения, второй для субтитров и доступности.
- Voicli использует архитектуру перевода речи в реальном времени, чтобы позволить участникам говорить на своих языках и естественно общаться на встречах.
Перевод голоса в реальном времени становится обычной функцией в платформах встреч, инструментах коммуникации и приложениях на основе ИИ.
Но есть важная деталь, которая часто скрывается за словами «перевод в реальном времени».
Два продукта могут утверждать, что переводят речь в реальном времени, но использовать при этом совершенно разные технологии.
Один может обрабатывать разговор так:
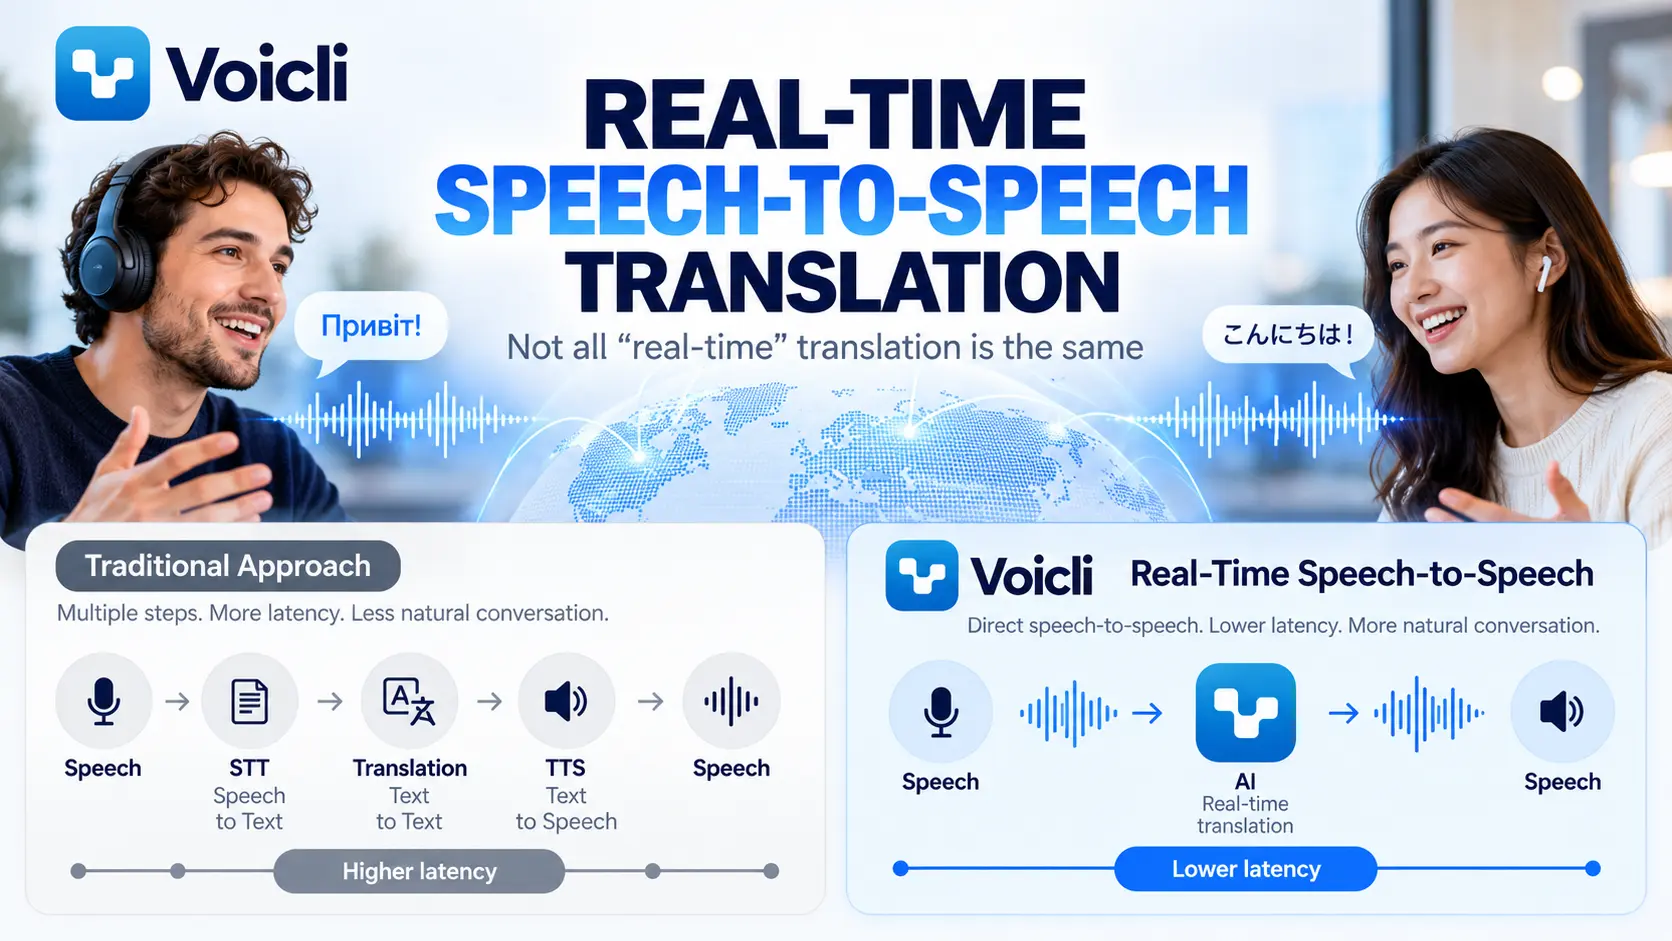
Речь → транскрипция → перевод текста → синтез речи → переведённый аудиофайл
Другой может обрабатывать взаимодействие как непрерывный опыт перевода речи в речь, где аудио понимается и переводится напрямую в рамках модели реального времени с несколькими модальностями.
Оба подхода могут производить переведённую речь.
Но они не обязательно создают одинаковый опыт общения.
В Voicli наш живой перевод голоса разработан на основе перевода речи в реальном времени, позволяя участникам говорить естественно на своих языках, в то время как переведённая речь генерируется для слушающих.
Итак, что именно такое перевод речи в речь и почему архитектура имеет значение?
Что такое перевод речи в реальном времени?
Перевод речи в речь (S2ST) — это технология, которая получает устную речь и производит устный вывод на другом языке.
В живой системе этот процесс происходит непрерывно во время разговора.
Например:
Один человек говорит на украинском.
Другой участник хочет слышать английский.
Система слушает украинскую речь, понимает её смысл, переводит и генерирует английский аудиофайл для слушателя.
Цель — не просто перевести слова.
Цель — сделать общение между людьми, говорящими на разных языках, максимально похожим на обычный разговор.
Это различие становится важным, когда мы сравниваем современные системы перевода речи в речь с традиционными конвейерами голосового перевода.
Традиционный подход: STT → перевод → TTS
На протяжении многих лет системы голосового перевода строились из нескольких отдельных технологий.
Архитектура обычно выглядит так:
1. Распознавание речи (STT)
Аудио говорящего преобразуется в письменный текст.
↓
2. Машинный перевод (MT)
Письменный текст переводится на другой язык.
↓
3. Синтез речи (TTS)
Переведённый текст преобразуется обратно в искусственную речь.
Полный конвейер становится:
Аудио → STT → Текст → Перевод → Текст → TTS → Аудио
Эта архитектура работает.
На самом деле, она питала многие системы перевода речи на протяжении многих лет.
Она также полезна, когда основная цель — транскрипция, субтитры, поддающиеся поиску заметки встреч или ситуации, когда разработчикам нужен полный контроль над каждым этапом обработки.
Но живое человеческое общение вводит ещё одно требование:
скорость.
Почему каскадный конвейер перевода может казаться медленным
Каждый этап традиционного конвейера голосового перевода требует времени.
Система распознавания речи нуждается в достаточном количестве аудио, чтобы понять, что было сказано.
Затем система перевода обрабатывает полученный текст.
Затем система синтеза речи генерирует новый аудиопоток.
Каждый отдельный компонент может быть быстрым.
Но их задержки могут накапливаться.
Есть ещё одна проблема.
Каждый этап зависит от вывода предыдущего этапа.
Если распознавание речи неправильно поймёт слово, модель перевода получит неправильный текст.
Если перевод изменит смысл, система синтеза речи просто произнесёт этот переведённый текст.
Другими словами, ошибки могут распространяться по конвейеру:
Ошибка распознавания речи → ошибка перевода → ошибка в произнесённом переводе
При переводе документов это может быть приемлемо.
Во время живого разговора даже несколько дополнительных секунд или неловкая пауза могут полностью изменить то, как ощущается общение.
Люди перестают говорить естественно.
Они ждут.
Они проверяют, закончился ли перевод.
Затем другой человек отвечает.
Вместо разговора общение начинает ощущаться как чередование с машиной.
Нативный перевод речи в реальном времени меняет архитектуру
Современные мультимодальные модели ИИ могут работать с аудиовводом и аудиовыводом в рамках одного взаимодействия в реальном времени.
Вместо того чтобы требовать от разработчиков подключения трёх независимых систем для каждой произнесённой фразы, модель реального времени может непрерывно обрабатывать входящий аудиосигнал и генерировать устный вывод.
С точки зрения пользователя, поток становится намного ближе к:
Речь → понимание и перевод ИИ → Речь
Это обычно называют переводом речи в реальном времени.
Важное различие состоит не в том, что текст никогда не может существовать где-либо внутри модели ИИ.
Современные модели могут использовать множество внутренних представлений.
Разница архитектурная:
Живой разговор не должен ждать отдельного сервиса транскрипции, затем отдельного сервиса перевода текста, а затем отдельного сервиса синтеза речи, прежде чем может начаться переведённый аудиофайл.
Это делает возможным совершенно другой тип взаимодействия.
«Реальное время» не всегда означает одно и то же
Термин перевод в реальном времени широко используется в отрасли.
Продукт может технически называться реальным временем, если он генерирует перевод через несколько секунд после того, как кто-то говорит.
Для субтитров это может быть совершенно приемлемо.
Но человеческий разговор намного более чувствителен к задержке.
Рассмотрим два опыта.
Опыт A: Каскадный перевод
Вы говорите.
Система ждёт достаточного количества аудио.
Ваша речь становится текстом.
Текст переводится.
Переведённый текст отправляется генератору голоса.
Другой участник слышит перевод.
Затем они отвечают.
Опыт B: Перевод речи в реальном времени
Вы начинаете говорить.
Модель обрабатывает аудиопоток как часть непрерывной сессии.
Она понимает текущий разговор и начинает генерировать переведённую речь с значительно меньшей зависимостью от отдельных этапов обработки.
Разговор становится ближе к естественному чередованию.
Обе системы технически могут быть описаны как «реальное время».
Но опыт может быть очень разным.
Почему задержка важнее большинства бенчмарков перевода
Продукты перевода часто оцениваются по точности.
Точность, очевидно, важна.
Но во время живого общения есть ещё одно одинаково важное измерение:
задержка разговора.
Представьте деловую встречу с шестью людьми, говорящими на нескольких языках.
Если каждое переведённое предложение вводит несколько секунд тишины, эти задержки умножаются на протяжении встречи.
Участники начинают прерывать переводы.
Некоторые люди начинают говорить до того, как предыдущие переводы закончились.
Другие перестают участвовать, потому что следить за разговором становится сложно.
Сам перевод может быть правильным, а опыт встречи всё ещё плохой.
Для живого многоязычного общения качество перевода поэтому не может быть измерено только тем, правильны ли слова.
Оно также должно учитывать:
как быстро начинается переведённая речь;
как естественно участники могут чередоваться;
можно ли обрабатывать перебивания;
понимает ли система контекст разговора;
нужно ли пользователям ждать полных предложений;
как хорошо разговор течёт на нескольких языках.
Вот почему технология перевода речи в реальном времени особенно важна для встреч.
Речь содержит больше, чем слова
Ещё одно ограничение преобразования речи в простой текст состоит в том, что человеческая речь содержит информацию, которую сложно полностью представить в транскрипции.
Люди общаются через:
тон;
ритм;
паузы;
ударение;
колебание;
скорость речи;
контекст разговора.
Традиционные системы STT сначала сжимают устное сообщение в текст.
Некоторая информация из исходного аудио может быть потеряна до того, как перевод даже начнётся.
Современные модели перевода речи в речь могут работать непосредственно с аудио и имеют доступ к большей части исходного речевого сигнала.
Это не означает, что каждый нюанс всегда выживет при переводе.
Но это создаёт возможность гораздо более естественного голосового взаимодействия, чем системы, построенные только вокруг текста.
Перевод речи в речь против перевода речи в текст
Эти технологии иногда путают, но они решают разные проблемы.
Перевод речи в текст преобразует устную речь в переведённый текст.
Например:
Японская речь → английские субтитры
Это чрезвычайно полезно для подписей и доступности.
Перевод речи в речь производит переведённый аудиофайл:
Японская речь → английская речь
Это позволяет слушателю следить за разговором без постоянного чтения субтитров.
Voicli поддерживает живые субтитры как часть опыта встречи, но перевод голоса разработан для чего-то более широкого: позволить людям действительно общаться на разных языках, а не просто читать переводы того, что сказали другие.
Почему Voicli использует перевод речи в реальном времени
Voicli был построен на простой идее:
Люди должны иметь возможность присоединиться к одной встречи и говорить на языке, на котором им наиболее удобно.
Один участник может говорить на украинском.
Другой может говорить на японском.
Третий может предпочесть английский.
Четвёртый может говорить на корейском.
Вместо того чтобы заставлять всех переходить на общий второй язык, Voicli обрабатывает перевод во время разговора.
Каждый участник может выбрать язык, который он хочет слышать.
Платформа может предоставить переведённый голос, субтитры или исходный аудиофайл в зависимости от предпочтения слушателя.
Для живого перевода голоса Voicli использует архитектуру перевода речи в реальном времени, а не полагается исключительно на традиционный:
STT → перевод текста → TTS
конвейер для каждого переведённого высказывания.
Это архитектурное различие важно, потому что Voicli не пытается построить инструмент транскрипции, который случайно произносит переведённый текст.
Цель — построить многоязычный коммуникационный слой для реальных разговоров.
Когда STT + перевод + TTS всё ещё правильное решение
Технология перевода речи в речь не делает традиционные конвейеры устаревшими.
Есть много ситуаций, когда STT → перевод → TTS полезен или даже предпочтителен.
Например:
Стенограммы встреч нуждаются в точном тексте.
История поддающихся поиску разговоров требует текстового представления.
Субтитры естественно зависят от транскрипции.
Системы соответствия могут нуждаться в сохранении ровно того, что было распознано.
Асинхронный перевод не требует чрезвычайно низкой задержки.
Специализированные рабочие процессы могут требовать от разработчиков проверки и изменения каждого промежуточного этапа.
Вот почему Voicli также использует различные технологии ИИ в зависимости от задачи.
Ключ — выбрать правильную архитектуру для создаваемого опыта.
Для стенограммы текст — это продукт.
Для живого многоязычного разговора сам разговор — это продукт.
От инструментов перевода к многоязычному общению
На протяжении десятилетий машинный перевод в основном был о преобразовании информации с одного языка на другой.
Сначала документы.
Затем веб-сайты.
Затем сообщения.
Затем субтитры.
Перевод речи в реальном времени представляет другое направление.
Вместо вопроса:
«Как быстро мы можем перевести это предложение?»
более важный вопрос становится:
«Могут ли два человека, говорящие на разных языках, общаться естественно?»
Это меняет то, как нужно проектировать системы перевода.
Задержка становится критической.
Чередование становится критическим.
Качество аудио становится критическим.
Контекст становится критическим.
И перевод становится частью коммуникационной инфраструктуры, а не отдельным инструментом, который люди сознательно используют.
Будущее многоязычных встреч
Долгосрочная цель перевода речи — не заставить людей чаще думать о технологии перевода.
Это противоположное.
Перевод должен постепенно исчезнуть в разговоре.
Вы говорите на своём языке.
Другой человек говорит на своём.
И технология обрабатывает то, что происходит между вами.
Всё ещё будут вызовы.
Акценты, фоновый шум, специальная терминология, перекрывающиеся говорящие, имена и культурный контекст — всё это может повлиять на перевод ИИ.
Но модели реального времени с несколькими модальностями меняют то, что технически возможно.
Мы движемся от:
запись → транскрипция → перевод → синтез → прослушивание
к:
речь → понимание → перевод → слушание
И в конце концов, наиболее успешная технология перевода может быть технологией, которую участники едва замечают.
Перевод в реальном времени должен ощущаться как общение
Назвать продукт «реальным временем» легко.
Сделать многоязычное общение действительно ощущающимся в реальном времени намного сложнее.
Разница — это не просто миллисекунды в бенчмарке.
Это то, могут ли люди говорить естественно.
Могут ли они отвечать без ожидания.
Ощущается ли многоязычная встреча как разговор, а не как последовательность переведённых сообщений.
Это проблема, над которой работает Voicli.
Перевод речи в реальном времени для разговоров, где каждый может говорить на своём языке.
Часто задаваемые вопросы
Что такое перевод речи в речь?
Перевод речи в речь преобразует устную речь непосредственно в устный вывод на другом языке. Современные системы ИИ могут обрабатывать аудиовход и генерировать переведённый аудиофайл в рамках сессии в реальном времени.
В чём разница между переводом речи в речь и переводом речи в текст?
Перевод речи в текст производит переведённый письменный текст, такой как субтитры. Перевод речи в речь производит переведённый аудиофайл, который может слышать слушатель.
Как работает традиционный голосовой перевод?
Традиционные системы обычно используют три этапа: распознавание речи, машинный перевод и синтез речи. Это часто называют каскадной архитектурой перевода речи.
Почему STT → перевод → TTS может иметь более высокую задержку?
Каждый этап должен обработать информацию и передать свой вывод следующему компоненту. Накопленное время обработки может вводить дополнительную задержку, в то время как ошибки на одном этапе также могут влиять на последующие этапы.
Является ли перевод речи в речь тем же самым, что и одновременный перевод?
Это связанные концепции, но не идентичные. Одновременный перевод человеком выполняется профессиональными переводчиками. Перевод речи в речь на основе ИИ пытается автоматически обеспечить аналогичный опыт многоязычного общения с низкой задержкой.
Можно ли использовать перевод речи в речь для деловых встреч?
Да. Перевод речи в реальном времени особенно полезен для международных встреч, звонков клиентов, деловых разговоров, удалённых команд, интервью и других ситуаций, когда участники не говорят на одном языке.
Что делает Voicli?
Voicli — это многоязычная платформа видеокоммуникации с переводом голоса в реальном времени и живыми субтитрами. Участники могут говорить на предпочитаемых ими языках, в то время как Voicli обрабатывает перевод во время разговора.
Попробуйте Voicli и говорите на своём языке. Пусть встреча обрабатывает перевод.