การแปลเสียงพูดแบบเรียลไทม์: เหตุใดการแปลเสียงแบบ "เรียลไทม์" จึงไม่เหมือนกันทั้งหมด
Key Takeaways
- การแปลเสียงพูดแบบเรียลไทม์ประมวลผลเสียงโดยตรงและสร้างเสียงที่แปลแล้ว ไม่ใช่การแปลงเป็นข้อความก่อน
- ไปป์ไลน์ STT → แปล → TTS แบบดั้งเดิมสามารถสะสมความล่าช้าและแพร่กระจายข้อผิดพลาดผ่านแต่ละขั้นตอน
- ความล่าช้าของการสนทนาเป็นสิ่งสำคัญเท่าความแม่นยำสำหรับการประชุมแบบพหุภาษาแบบสด
- เสียงพูดมีข้อมูลเกี่ยวกับโทน จังหวะ เน้น และบริบทที่สูญหายเมื่อแปลงเป็นข้อความ
- Voicli ใช้สถาปัตยกรรมเสียงพูดเป็นเสียงพูดแบบเรียลไทม์เพื่อให้ผู้คนสามารถพูดภาษาของตนเองในการประชุมแบบพหุภาษา
การแปลเสียงแบบเรียลไทม์กำลังกลายเป็นฟีเจอร์ทั่วไปในแพลตฟอร์มการประชุม เครื่องมือการสื่อสาร และแอปพลิเคชัน AI
แต่มีรายละเอียดที่สำคัญซึ่งมักถูกซ่อนไว้เบื้องหลังคำว่า "การแปลแบบเรียลไทม์"
ผลิตภัณฑ์สองชิ้นอาจกล่าวว่าแปลเสียงพูดแบบเรียลไทม์ในขณะที่ใช้เทคโนโลยีที่แตกต่างกันมากภายใต้พื้นผิว
ผลิตภัณฑ์หนึ่งอาจประมวลผลการสนทนาเช่นนี้:
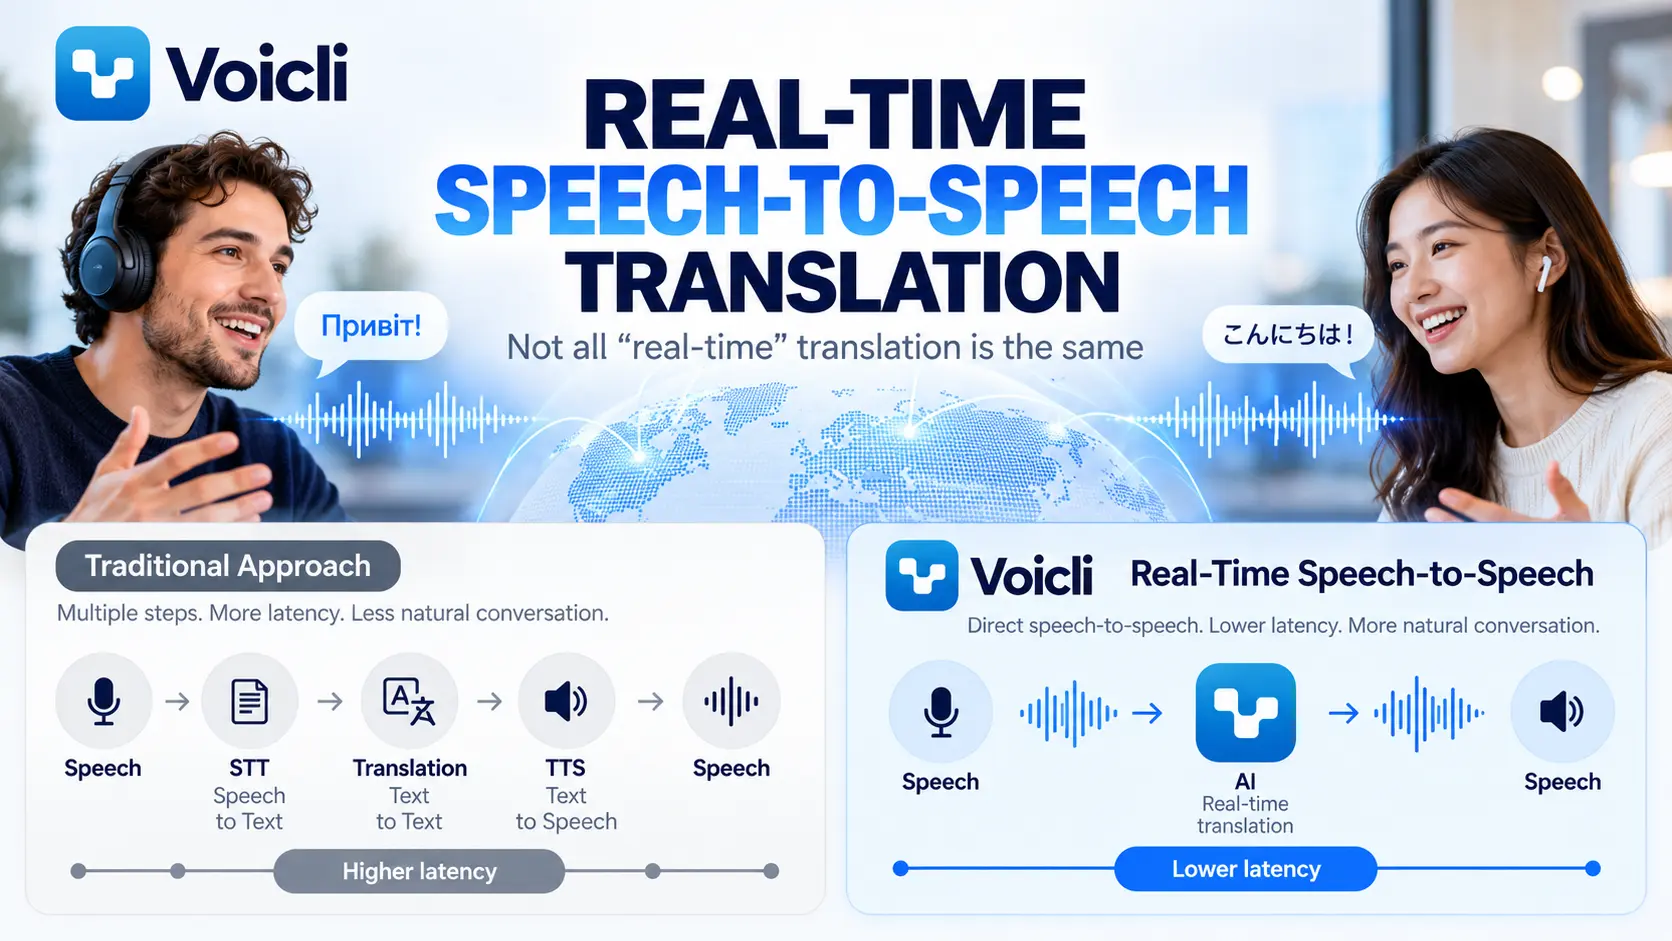
เสียงพูด → การถอดเสียง → การแปลข้อความ → การแปลงข้อความเป็นเสียง → เสียงที่แปลแล้ว
อีกผลิตภัณฑ์หนึ่งสามารถประมวลผลการโต้ตอบเป็นประสบการณ์ เสียงพูดเป็นเสียงพูด ที่ต่อเนื่อง โดยที่เสียงจะถูกเข้าใจและแปลโดยตรงภายในโมเดลมัลติโมดัลแบบเรียลไทม์
ทั้งสองวิธีสามารถสร้างเสียงที่แปลแล้ว
แต่พวกเขาไม่จำเป็นต้องสร้างประสบการณ์การสนทนาแบบเดียวกัน
ที่ Voicli การแปลเสียงแบบสดของเราได้รับการออกแบบรอบ การแปลเสียงพูดแบบเรียลไทม์ ซึ่งช่วยให้ผู้เข้าร่วมสามารถพูดได้อย่างเป็นธรรมชาติในภาษาของตนเองในขณะที่เสียงที่แปลแล้วจะถูกสร้างขึ้นสำหรับผู้ที่ฟัง
แล้วการแปลเสียงพูดแบบเรียลไทม์คืออะไรกันแน่ และเหตุใดสถาปัตยกรรมจึงมีความสำคัญ
การแปลเสียงพูดแบบเรียลไทม์คืออะไร
การแปลเสียงพูด (S2ST) คือเทคโนโลยีที่รับภาษาที่พูดและสร้างเสียงออกมาในภาษาอื่น
ในระบบแบบสด กระบวนการนี้เกิดขึ้นอย่างต่อเนื่องในขณะที่ผู้คนกำลังสนทนา
ตัวอย่างเช่น:
บุคคลหนึ่งพูดภาษายูเครน
ผู้เข้าร่วมอีกคนต้องการฟังภาษาอังกฤษ
ระบบฟังเสียงพูดภาษายูเครน เข้าใจความหมายของมัน แปลมัน และสร้างเสียงภาษาอังกฤษสำหรับผู้ฟัง
เป้าหมายไม่ใช่เพียงแค่การแปลคำพูด
เป้าหมายคือการทำให้การสื่อสารระหว่างผู้คนที่พูดภาษาต่างกันรู้สึกใกล้เคียงกับการสนทนาปกติมากที่สุด
ความแตกต่างนี้มีความสำคัญเมื่อเราเปรียบเทียบระบบเสียงพูดเป็นเสียงพูดสมัยใหม่กับไปป์ไลน์การแปลเสียงแบบดั้งเดิม
วิธีการแบบดั้งเดิม: STT → แปล → TTS
เป็นเวลาหลายปีที่ระบบการแปลเสียงได้รับการสร้างจากเทคโนโลยีแยกต่างหากหลายชิ้น
สถาปัตยกรรมมักจะมีลักษณะดังนี้:
1. การแปลงเสียงเป็นข้อความ (STT)
เสียงของผู้พูดจะถูกแปลงเป็นข้อความที่เขียนไว้
↓
2. การแปลด้วยเครื่อง (MT)
ข้อความที่เขียนไว้จะถูกแปลเป็นภาษาอื่น
↓
3. การแปลงข้อความเป็นเสียง (TTS)
ข้อความที่แปลแล้วจะถูกแปลงกลับเป็นเสียงเทียม
ไปป์ไลน์ที่สมบูรณ์จะกลายเป็น:
เสียง → STT → ข้อความ → แปล → ข้อความ → TTS → เสียง
สถาปัตยกรรมนี้ใช้ได้
ในความเป็นจริง มันได้ขับเคลื่อนระบบการแปลเสียงจำนวนมากมาเป็นเวลาหลายปี
นอกจากนี้ยังมีประโยชน์เมื่อเป้าหมายหลักคือการถอดเสียง คำบรรยาย บันทึกการประชุมที่สามารถค้นหาได้ หรือสถานการณ์ที่นักพัฒนาต้องการควบคุมทุกขั้นตอนการประมวลผล
แต่การสนทนาของมนุษย์แบบสดนำเสนอข้อกำหนดอื่น:
ความเร็ว
เหตุใดไปป์ไลน์การแปลแบบเรียงลำดับจึงอาจรู้สึกช้า
ทุกขั้นตอนในไปป์ไลน์การแปลเสียงแบบดั้งเดิมใช้เวลา
ระบบการรู้จำเสียงพูดต้องการเสียงเพียงพอเพื่อเข้าใจว่าพูดอะไร
จากนั้นระบบการแปลจะประมวลผลข้อความที่ได้
จากนั้นระบบการแปลงข้อความเป็นเสียงจะสร้างสตรีมเสียงใหม่
แต่ละส่วนประกอบอาจเร็ว
แต่ความล่าช้าของพวกเขาสามารถสะสมได้
มีปัญหาอื่นด้วย
แต่ละขั้นตอนขึ้นอยู่กับผลลัพธ์ของขั้นตอนก่อนหน้า
หากการรู้จำเสียงพูดเข้าใจผิดคำใดคำหนึ่ง โมเดลการแปลจะได้รับข้อความที่ผิด
หากการแปลเปลี่ยนความหมาย ระบบ TTS จะพูดข้อความที่แปลแล้วนั้น
กล่าวอีกนัยหนึ่ง ข้อผิดพลาดสามารถแพร่กระจายผ่านไปป์ไลน์:
ข้อผิดพลาดในการรู้จำเสียงพูด → ข้อผิดพลาดในการแปล → ข้อผิดพลาดในการแปลที่พูด
ในระหว่างการแปลเอกสาร สิ่งนี้อาจเป็นที่ยอมรับได้
ในระหว่างการสนทนาแบบสด แม้แต่เพียงไม่กี่วินาทีหรือการหยุดชั่วคราวที่อึดอัดก็สามารถเปลี่ยนวิธีการสื่อสารได้อย่างสิ้นเชิง
ผู้คนหยุดพูดอย่างเป็นธรรมชาติ
พวกเขารอ
พวกเขาตรวจสอบว่าการแปลเสร็จสิ้นหรือไม่
จากนั้นคนอื่นจึงตอบสนอง
แทนที่จะเป็นการสนทนา การสื่อสารเริ่มรู้สึกเหมือนกำลังเล่นเกมสลับกับเครื่องจักร
การแปลเสียงพูดแบบเรียลไทม์ดั้งเดิมเปลี่ยนสถาปัตยกรรม
โมเดล AI มัลติโมดัลสมัยใหม่สามารถทำงานกับอินพุตเสียงและเสียงออกภายในการโต้ตอบแบบเรียลไทม์เดียวกัน
แทนที่จะต้องให้นักพัฒนาเชื่อมต่อระบบอิสระสามระบบสำหรับทุกวลีที่พูด โมเดลแบบเรียลไทม์สามารถประมวลผลเสียงขาเข้าอย่างต่อเนื่องและสร้างเสียงออก
จากมุมมองของผู้ใช้ การไหลจะใกล้เคียงกับ:
เสียงพูด → ความเข้าใจและการแปลของ AI → เสียงพูด
โดยทั่วไปเรียกว่า การแปลเสียงพูดแบบเรียลไทม์
ความแตกต่างที่สำคัญไม่ใช่ว่าข้อความไม่สามารถมีอยู่ที่ใดก็ได้ภายในโมเดล AI
โมเดลสมัยใหม่อาจใช้การแสดงภายในจำนวนมาก
ความแตกต่างคือสถาปัตยกรรม:
การสนทนาแบบสดไม่ต้องรอบริการถอดเสียงแยกต่างหาก จากนั้นบริการแปลข้อความแยกต่างหาก และจากนั้นบริการสังเคราะห์เสียงแยกต่างหากก่อนที่เสียงที่แปลแล้วจะสามารถเริ่มต้นได้
นั่นทำให้ประเภทของการโต้ตอบที่แตกต่างกันมากเป็นไปได้
"เรียลไทม์" ไม่ได้หมายความว่าเหมือนกันเสมอไป
คำว่า การแปลแบบเรียลไทม์ ใช้กันอย่างแพร่หลายในอุตสาหกรรม
ผลิตภัณฑ์สามารถเรียกตัวเองว่าเรียลไทม์ได้ในทางเทคนิคหากสร้างการแปลไม่กี่วินาทีหลังจากที่ใครบางคนพูด
สำหรับคำบรรยาย สิ่งนั้นอาจเป็นที่ยอมรับได้อย่างสมบูรณ์
แต่การสนทนาของมนุษย์มีความไวต่อความล่าช้ามากขึ้น
พิจารณาสองประสบการณ์
ประสบการณ์ A: การแปลแบบเรียงลำดับ
คุณพูด
ระบบรอเสียงเพียงพอ
เสียงพูดของคุณกลายเป็นข้อความ
ข้อความจะถูกแปล
ข้อความที่แปลแล้วจะถูกส่งไปยังเครื่องสร้างเสียง
ผู้เข้าร่วมอีกคนได้ยินการแปล
จากนั้นพวกเขาตอบสนอง
ประสบการณ์ B: การแปลเสียงพูดแบบเรียลไทม์
คุณเริ่มพูด
โมเดลประมวลผลสตรีมเสียงเป็นส่วนหนึ่งของเซสชันต่อเนื่อง
มันเข้าใจการสนทนาที่กำลังดำเนินอยู่และเริ่มสร้างเสียงที่แปลแล้วโดยมีการพึ่งพาขั้นตอนการประมวลผลแยกต่างหากน้อยลง
การสนทนากลายเป็นใกล้เคียงกับการเล่นเกมตามธรรมชาติ
ระบบทั้งสองสามารถอธิบายได้ว่าเป็น "เรียลไทม์" ในทางเทคนิค
แต่ประสบการณ์อาจแตกต่างกันมาก
เหตุใดความล่าช้าจึงมีความสำคัญมากกว่าเกณฑ์มาตรฐานการแปลส่วนใหญ่
ผลิตภัณฑ์การแปลมักได้รับการประเมินจากความแม่นยำ
ความแม่นยำเป็นสิ่งสำคัญอย่างชัดเจน
แต่ในระหว่างการสื่อสารแบบสด มีมิติที่สำคัญเท่าเทียมกัน:
ความล่าช้าของการสนทนา
ลองนึกภาพการประชุมทางธุรกิจกับหกคนพูดหลายภาษา
หากประโยคที่แปลแล้วแต่ละประโยคนำเสนอความเงียบหลายวินาที ความล่าช้าเหล่านั้นจะคูณกันตลอดการประชุม
ผู้เข้าร่วมเริ่มขัดจังหวะการแปล
บางคนเริ่มพูดก่อนที่การแปลก่อนหน้านี้จะเสร็จสิ้น
คนอื่น ๆ หยุดการมีส่วนร่วมเพราะการติดตามการสนทนากลายเป็นเรื่องยาก
การแปลเองอาจถูกต้องในขณะที่ประสบการณ์การประชุมยังคงไม่ดี
สำหรับการสื่อสารแบบพหุภาษาแบบสด คุณภาพการแปลจึงไม่สามารถวัดได้เพียงแค่ว่าคำนั้นถูกต้องหรือไม่
นอกจากนี้ยังควรพิจารณา:
ความเร็วในการเริ่มเสียงที่แปลแล้ว
ความเป็นธรรมชาติของการเล่นเกมของผู้เข้าร่วม
ว่าสามารถจัดการการขัดจังหวะได้หรือไม่
ว่าระบบเข้าใจบริบทของการสนทนาหรือไม่
ว่าผู้ใช้ต้องรอประโยคที่สมบูรณ์หรือไม่
ว่าการสนทนาไหลได้ดีเพียงใดในหลายภาษา
นี่คือเหตุผลว่าทำไมเทคโนโลยีการแปลเสียงพูดแบบเรียลไทม์จึงมีความสำคัญอย่างยิ่งสำหรับการประชุม
เสียงพูดมีมากกว่าคำพูด
ข้อจำกัดอีกประการหนึ่งของการแปลงเสียงพูดเป็นข้อความธรรมดาคือเสียงพูดของมนุษย์มีข้อมูลที่ยากต่อการแสดงอย่างสมบูรณ์ในการถอดเสียง
ผู้คนสื่อสารผ่าน:
โทน;
จังหวะ;
การหยุดชั่วคราว;
เน้น;
ความลังเล;
ความเร็วในการพูด;
บริบทของการสนทนา
ระบบ STT แบบดั้งเดิมจะบีบอัดข้อความที่พูดเป็นข้อความก่อน
ข้อมูลบางส่วนจากเสียงดั้งเดิมจึงสามารถสูญหายได้ก่อนที่การแปลจะเริ่มต้น
โมเดลเสียงพูดเป็นเสียงพูดสมัยใหม่สามารถทำงานโดยตรงกับเสียงและมีการเข้าถึงสัญญาณเสียงดั้งเดิมมากขึ้น
นี่ไม่ได้หมายความว่าความสูงเสียงทั้งหมดจะรอดชีวิตจากการแปลเสมอไป
แต่มันสร้างความเป็นไปได้ของการโต้ตอบเสียงที่เป็นธรรมชาติมากขึ้นกว่าระบบที่สร้างขึ้นเพียงรอบข้อความ
การแปลเสียงพูดเป็นเสียงพูดเทียบกับการแปลเสียงพูดเป็นข้อความ
เทคโนโลยีเหล่านี้บางครั้งสับสน แต่พวกเขาแก้ปัญหาที่แตกต่างกัน
การแปลเสียงพูดเป็นข้อความ แปลงภาษาที่พูดเป็นข้อความที่แปลแล้ว
ตัวอย่างเช่น:
เสียงพูดภาษาญี่ปุ่น → คำบรรยายภาษาอังกฤษ
นี่มีประโยชน์อย่างมากสำหรับคำบรรยายและการเข้าถึง
การแปลเสียงพูดเป็นเสียงพูด สร้างเสียงที่แปลแล้ว:
เสียงพูดภาษาญี่ปุ่น → เสียงพูดภาษาอังกฤษ
นี่ช่วยให้ผู้ฟังสามารถติดตามการสนทนาได้โดยไม่ต้องอ่านคำบรรยายอย่างต่อเนื่อง
Voicli รองรับคำบรรยายแบบสดเป็นส่วนหนึ่งของประสบการณ์การประชุม แต่การแปลเสียงได้รับการออกแบบสำหรับสิ่งที่กว้างขึ้น: ให้ผู้คนสามารถ พูดคุยข้ามภาษา แทนที่จะเพียงแค่อ่านการแปลของสิ่งที่คนอื่นพูด
เหตุใด Voicli จึงใช้การแปลเสียงพูดแบบเรียลไทม์
Voicli ได้รับการสร้างขึ้นรอบแนวคิดง่ายๆ:
ผู้คนควรสามารถเข้าร่วมการประชุมเดียวกันและพูดภาษาที่พวกเขาสะดวกสบายที่สุด
ผู้เข้าร่วมคนหนึ่งอาจพูดภาษายูเครน
อีกคนอาจพูดภาษาญี่ปุ่น
อีกคนอาจชอบภาษาอังกฤษ
อีกคนอาจพูดภาษาเกาหลี
แทนที่จะบังคับให้ทุกคนเปลี่ยนไปใช้ภาษาที่สองทั่วไป Voicli จัดการการแปลระหว่างการสนทนา
ผู้เข้าร่วมแต่ละคนสามารถเลือกภาษาที่พวกเขาต้องการฟัง
แพลตฟอร์มสามารถให้เสียงที่แปลแล้ว คำบรรยาย หรือเสียงดั้งเดิมขึ้นอยู่กับความต้องการของผู้ฟัง
สำหรับการแปลเสียงแบบสด Voicli ใช้สถาปัตยกรรมเสียงพูดเป็นเสียงพูดแบบเรียลไทม์แทนที่จะพึ่งพาเฉพาะ:
STT → แปลข้อความ → TTS
ไปป์ไลน์สำหรับทุกการออกเสียงที่แปลแล้ว
ความแตกต่างของสถาปัตยกรรมนั้นมีความสำคัญเพราะ Voicli ไม่ได้พยายามสร้างเครื่องมือถอดเสียงที่บังเอิญพูดข้อความที่แปลแล้ว
เป้าหมายคือการสร้าง ชั้นการสื่อสารแบบพหุภาษาสำหรับการสนทนาจริง
เมื่อ STT + แปล + TTS ยังคงเป็นวิธีแก้ปัญหาที่ถูกต้อง
เทคโนโลยีเสียงพูดเป็นเสียงพูดไม่ได้ทำให้ไปป์ไลน์แบบดั้งเดิมล้าสมัย
มีสถานการณ์จำนวนมากที่ STT → แปล → TTS มีประโยชน์หรือแม้กระทั่งดีกว่า
ตัวอย่างเช่น:
บันทึกการประชุม ต้องการข้อความที่แม่นยำ
ประวัติการสนทนาที่สามารถค้นหาได้ ต้องการการแสดงข้อความ
คำบรรยาย ขึ้นอยู่กับการถอดเสียงตามธรรมชาติ
ระบบการปฏิบัติตามกฎหมาย อาจจำเป็นต้องจัดเก็บสิ่งที่ได้รับการรู้จำอย่างแม่นยำ
การแปลแบบอะซิงโครนัส ไม่ต้องการความล่าช้าต่ำมาก
เวิร์กโฟลว์ที่เฉพาะเจาะจง อาจต้องให้นักพัฒนาตรวจสอบและแก้ไขทุกขั้นตอนกลาง
นั่นคือเหตุผลว่าทำไม Voicli จึงใช้เทคโนโลยี AI ที่แตกต่างกันขึ้นอยู่กับงาน
กุญแจคือการเลือกสถาปัตยกรรมที่ถูกต้องสำหรับประสบการณ์ที่กำลังสร้าง
สำหรับการถอดเสียง ข้อความคือผลิตภัณฑ์
สำหรับการสนทนาแบบพหุภาษาแบบสด การสนทนาเองคือผลิตภัณฑ์
จากเครื่องมือการแปลไปยังการสนทนาแบบพหุภาษา
เป็นเวลาหลายทศวรรษที่การแปลด้วยเครื่องจักรส่วนใหญ่เกี่ยวกับการแปลงข้อมูลจากภาษาหนึ่งไปยังอีกภาษาหนึ่ง
เอกสารก่อน
จากนั้นเว็บไซต์
จากนั้นข้อความ
จากนั้นคำบรรยาย
การแปลเสียงพูดแบบเรียลไทม์แสดงถึงทิศทางที่แตกต่างกัน
แทนที่จะถาม:
"เราสามารถแปลประโยคนี้ได้เร็วแค่ไหน"
คำถามที่สำคัญกว่าจะกลายเป็น:
"บุคคลสองคนที่พูดภาษาต่างกันสามารถสื่อสารได้อย่างเป็นธรรมชาติหรือไม่"
นั่นเปลี่ยนวิธีการออกแบบระบบการแปล
ความล่าช้ากลายเป็นสิ่งสำคัญ
การเล่นเกมกลายเป็นสิ่งสำคัญ
คุณภาพเสียงกลายเป็นสิ่งสำคัญ
บริบทกลายเป็นสิ่งสำคัญ
และการแปลกลายเป็นส่วนหนึ่งของโครงสร้างพื้นฐานการสื่อสารแทนที่จะเป็นเครื่องมือแยกต่างหากที่ผู้คนใช้อย่างมีสติ
อนาคตของการประชุมแบบพหุภาษา
เป้าหมายระยะยาวของการแปลเสียงไม่ใช่เพื่อให้ผู้คนคิดเกี่ยวกับเทคโนโลยีการแปลบ่อยขึ้น
มันตรงกันข้าม
การแปลควรค่อยๆ หายไปในการสนทนา
คุณพูดภาษาของคุณ
คนอื่นพูดของพวกเขา
และเทคโนโลยีจัดการสิ่งที่เกิดขึ้นระหว่างคุณ
ยังคงมีความท้าทายอยู่
สำเนียง เสียงรบกวนพื้นหลัง คำศัพท์เฉพาะด้าน ผู้พูดที่ทับซ้อนกัน ชื่อ และบริบททางวัฒนธรรมทั้งหมดสามารถส่งผลต่อการแปล AI
แต่โมเดลมัลติโมดัลแบบเรียลไทม์กำลังเปลี่ยนสิ่งที่เป็นไปได้ทางเทคนิค
เรากำลังเคลื่อนจาก:
บันทึก → ถอดเสียง → แปล → สังเคราะห์ → ฟัง
ไปยัง:
พูด → เข้าใจ → แปล → ฟัง
และในที่สุด เทคโนโลยีการแปลที่ประสบความสำเร็จมากที่สุดอาจเป็นเทคโนโลยีที่ผู้เข้าร่วมแทบไม่สังเกตเห็น
การแปลแบบเรียลไทม์ควรรู้สึกเหมือนการสื่อสาร
การเรียกผลิตภัณฑ์ว่า "เรียลไทม์" นั้นง่าย
การทำให้การสื่อสารแบบพหุภาษารู้สึกเป็นเรียลไทม์นั้นยากกว่ามาก
ความแตกต่างไม่ใช่เพียงมิลลิวินาทีในเกณฑ์มาตรฐาน
มันคือว่าผู้คนสามารถพูดได้อย่างเป็นธรรมชาติหรือไม่
ว่าพวกเขาสามารถตอบสนองได้โดยไม่ต้องรอ
ว่าการประชุมแบบพหุภาษารู้สึกเหมือนการสนทนามากกว่าลำดับของข้อความที่แปลแล้ว
นั่นคือปัญหาที่ Voicli กำลังแก้ไข
การแปลเสียงพูดแบบเรียลไทม์สำหรับการสนทนาที่ทุกคนสามารถพูดภาษาของตนเองได้
คำถามที่พบบ่อย
การแปลเสียงพูดคืออะไร
การแปลเสียงพูดแปลงภาษาที่พูดโดยตรงเป็นเสียงออกในภาษาอื่น ระบบ AI สมัยใหม่สามารถประมวลผลอินพุตเสียงและสร้างเสียงที่แปลแล้วภายในเซสชันแบบเรียลไทม์
ความแตกต่างระหว่างการแปลเสียงพูดเป็นเสียงพูดและการแปลเสียงพูดเป็นข้อความคืออะไร
การแปลเสียงพูดเป็นข้อความสร้างข้อความที่แปลแล้วเช่นคำบรรยาย การแปลเสียงพูดเป็นเสียงพูดสร้างเสียงที่แปลแล้วที่ผู้ฟังสามารถได้ยิน
การแปลเสียงแบบดั้งเดิมทำงานอย่างไร
ระบบทั่วไปใช้สามขั้นตอน: การรู้จำเสียงพูดเป็นข้อความ การแปลด้วยเครื่อง และการสังเคราะห์ข้อความเป็นเสียง นี่มักเรียกว่าสถาปัตยกรรมการแปลเสียงแบบเรียงลำดับ
เหตุใด STT → แปล → TTS อาจมีความล่าช้าสูงกว่า
แต่ละขั้นตอนต้องประมวลผลข้อมูลและส่งผลลัพธ์ไปยังส่วนประกอบถัดไป เวลาประมวลผลที่สะสมสามารถนำเสนอความล่าช้าเพิ่มเติม ในขณะที่ข้อผิดพลาดจากขั้นตอนหนึ่งสามารถส่งผลต่อขั้นตอนต่อมาได้
การแปลเสียงพูดแบบเรียลไทม์เหมือนกับการตีความพร้อมกันของมนุษย์หรือไม่
พวกเขาเป็นแนวคิดที่เกี่ยวข้องแต่ไม่เหมือนกัน การตีความพร้อมกันของมนุษย์ดำเนินการโดยนักแปลมืออาชีพ การแปลเสียงพูดแบบเรียลไทม์ของ AI พยายามให้ประสบการณ์การสื่อสารแบบพหุภาษาที่มีความล่าช้าต่ำโดยอัตโนมัติ
สามารถใช้การแปลเสียงพูดแบบเรียลไทม์สำหรับการประชุมทางธุรกิจได้หรือไม่
ใช่ การแปลเสียงพูดแบบเรียลไทม์มีประโยชน์อย่างยิ่งสำหรับการประชุมระหว่างประเทศ การโทรกับลูกค้า การสนทนาการขาย ทีมระยะไกล การสัมภาษณ์ และสถานการณ์อื่น ๆ ที่ผู้เข้าร่วมไม่ได้ใช้ภาษาเดียวกัน
Voicli ทำอะไร
Voicli เป็นแพลตฟอร์มการสื่อสารวิดีโอแบบพหุภาษาที่มีการแปลเสียงแบบเรียลไทม์และคำบรรยายแบบสด ผู้เข้าร่วมสามารถพูดภาษาที่ต้องการในขณะที่ Voicli จัดการการแปลระหว่างการสนทนา
ลองใช้ Voicli และพูดภาษาของคุณ ปล่อยให้การประชุมจัดการการแปล