Переклад мовлення в реальному часі: Чому не весь «реальний час» голосового перекладу однаковий
Key Takeaways
- Переклад мовлення в мовлення в реальному часі обробляє аудіо безпосередньо, на відміну від традиційних систем, які перетворюють мовлення на текст, перекладають текст, а потім синтезують мовлення.
- Каскадні конвеєри STT → переклад → TTS можуть мати вищу затримку, оскільки кожен етап залежить від попереднього, а помилки можуть накопичуватися.
- Для живих розмов затримка та природність взаємодії часто важливіші за точність окремих слів.
- Мовлення містить інформацію (тон, ритм, наголос), яка втрачається при перетворенні на текст, але збережена в системах переклад мовлення в мовлення.
- Voicli використовує архітектуру переклад мовлення в мовлення в реальному часі, щоб дозволити учасникам говорити своїми мовами та спілкуватися природно без значних затримок.
Переклад голосу в реальному часі стає звичайною функцією в платформах для зустрічей, інструментах комунікації та AI-додатках.
Але є важливий деталь, яка часто приховується за словами «переклад в реальному часі».
Два продукти можуть стверджувати, що вони перекладають мовлення в реальному часі, але використовують дуже різні технології.
Один може обробляти розмову так:
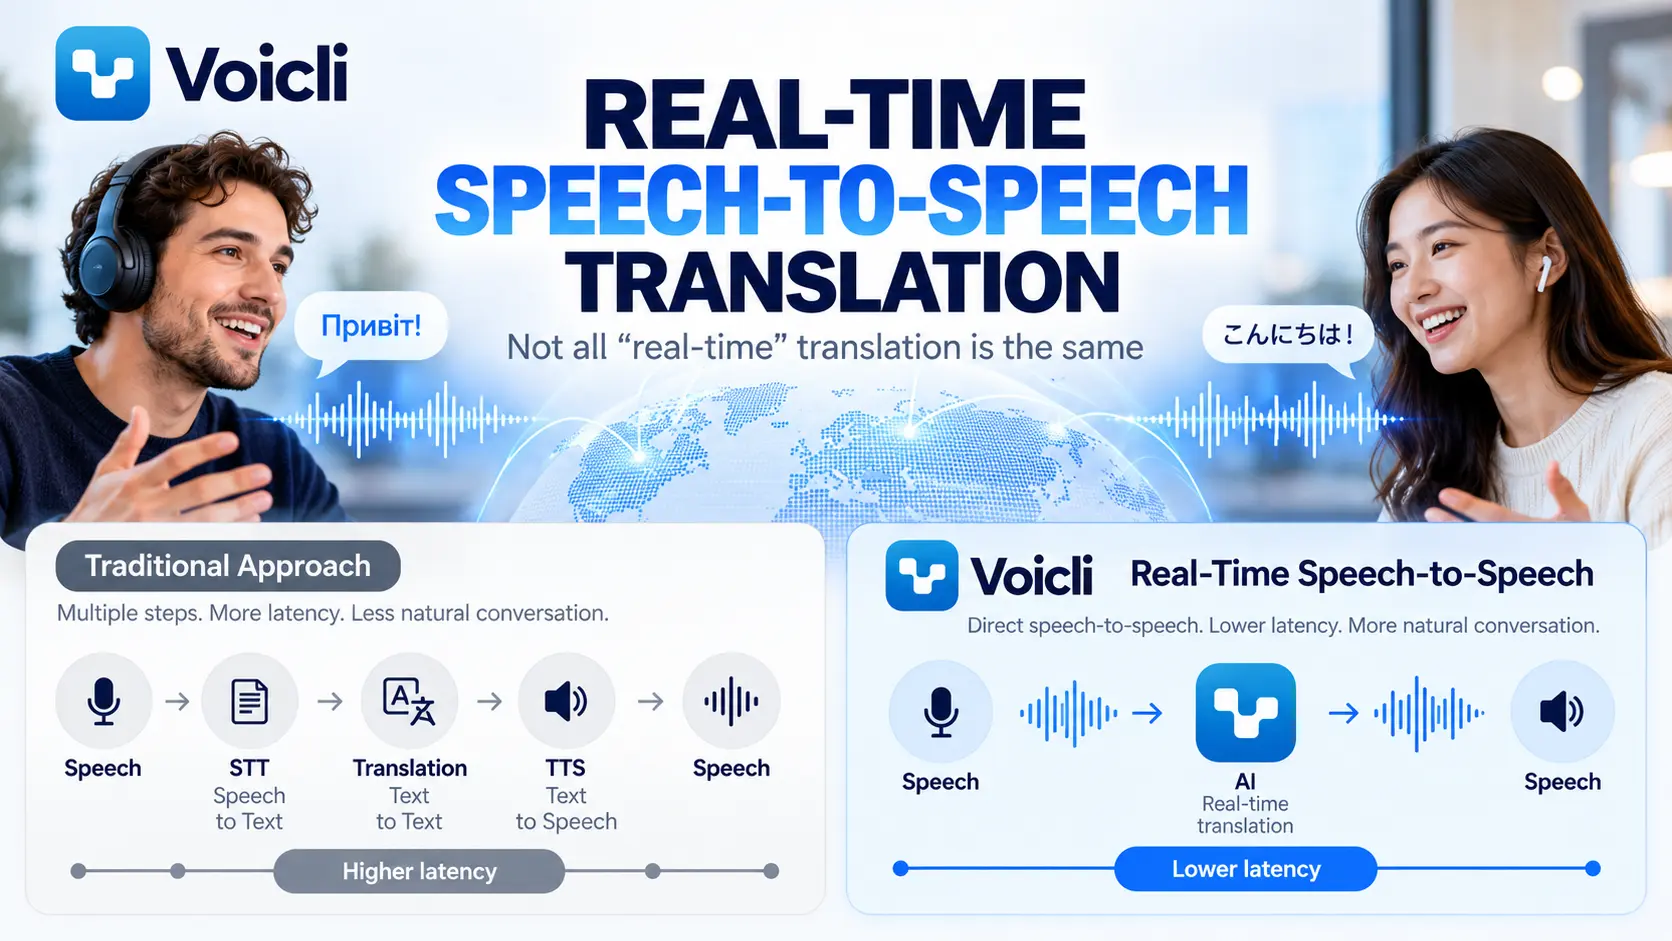
Мовлення → транскрипція → переклад тексту → синтез мовлення → перекладений аудіо
Інший може обробляти взаємодію як безперервний досвід переклад мовлення в мовлення, де аудіо розуміється та перекладається безпосередньо в реальному часі в багатомодальній моделі.
Обидва підходи можуть створювати перекладене мовлення.
Але вони не обов'язково створюють однаковий досвід розмови.
У Voicli наш живий переклад голосу розроблений навколо переклад мовлення в мовлення в реальному часі, що дозволяє учасникам говорити природно своїми мовами, а перекладене мовлення генерується для людей, які слухають.
Отже, що саме таке переклад мовлення в мовлення, і чому архітектура має значення?
Що таке переклад мовлення в мовлення в реальному часі?
Переклад мовлення в мовлення (S2ST) — це технологія, яка отримує усне мовлення та створює усний вихід іншою мовою.
У живій системі цей процес відбувається безперервно під час розмови людей.
Наприклад:
Одна людина говорить українською.
Інший учасник хоче чути англійську.
Система слухає українське мовлення, розуміє його значення, перекладає його та генерує англійський аудіо для слухача.
Мета — не просто перекласти слова.
Мета — зробити спілкування між людьми, які говорять різними мовами, максимально близьким до звичайної розмови.
Ця різниця стає важливою, коли ми порівнюємо сучасні системи переклад мовлення в мовлення з традиційними конвеєрами голосового перекладу.
Традиційний підхід: STT → переклад → TTS
Протягом багатьох років системи голосового перекладу будувалися з кількох окремих технологій.
Архітектура зазвичай виглядає так:
1. Розпізнавання мовлення (STT)
Аудіо мовця перетворюється на письмовий текст.
↓
2. Машинний переклад (MT)
Письмовий текст перекладається іншою мовою.
↓
3. Синтез мовлення (TTS)
Перекладений текст перетворюється назад на штучне мовлення.
Повний конвеєр стає:
Аудіо → STT → Текст → Переклад → Текст → TTS → Аудіо
Ця архітектура працює.
Насправді, вона живила багато систем переклад мовлення протягом років.
Вона також корисна, коли основна мета — транскрипція, субтитри, доступні для пошуку нотатки зустрічей або ситуації, коли розробникам потрібен повний контроль над кожним етапом обробки.
Але жива людська розмова вводить ще одну вимогу:
швидкість.
Чому каскадний конвеєр перекладу може здаватися повільним
Кожен крок у традиційному конвеєрі голосового перекладу займає час.
Система розпізнавання мовлення потребує достатньо аудіо, щоб зрозуміти, що було сказано.
Потім система перекладу обробляє отриманий текст.
Потім система синтезу мовлення генерує новий аудіопотік.
Кожен окремий компонент може бути швидким.
Але їхні затримки можуть накопичуватися.
Є ще одна проблема.
Кожен етап залежить від виходу попереднього етапу.
Якщо розпізнавання мовлення неправильно розуміє слово, модель перекладу отримує неправильний текст.
Якщо переклад змінює значення, система синтезу мовлення просто вимовляє цей перекладений текст.
Іншими словами, помилки можуть поширюватися через конвеєр:
Помилка розпізнавання мовлення → помилка перекладу → помилка вимовленого перекладу
Під час перекладу документів це може бути прийнятним.
Під час живої розмови навіть кілька додаткових секунд або незручна пауза можуть повністю змінити те, як відчувається спілкування.
Люди перестають говорити природно.
Вони чекають.
Вони перевіряють, чи закінчився переклад.
Потім інша людина відповідає.
Замість розмови спілкування починає відчуватися як чергування з машиною.
Рідний переклад мовлення в мовлення в реальному часі змінює архітектуру
Сучасні багатомодальні AI-моделі можуть працювати з аудіовходом та аудіовиходом в одній взаємодії в реальному часі.
Замість того, щоб розробникам потрібно було з'єднувати три незалежні системи для кожної вимовленої фрази, модель в реальному часі може безперервно обробляти вхідний аудіо та генерувати усний вихід.
З точки зору користувача, потік стає набагато ближче до:
Мовлення → розуміння та переклад AI → Мовлення
Це зазвичай називається переклад мовлення в мовлення в реальному часі.
Важливою різницею є не те, що текст ніколи не може існувати десь всередині AI-моделі.
Сучасні моделі можуть використовувати багато внутрішніх представлень.
Різниця архітектурна:
Жива розмова не повинна чекати окремого сервісу транскрипції, потім окремого сервісу перекладу тексту, а потім окремого сервісу синтезу мовлення, перш ніж може почати перекладене аудіо.
Це робить можливим дуже інший тип взаємодії.
«Реальний час» не завжди означає те саме
Термін переклад в реальному часі широко використовується в галузі.
Продукт може технічно називати себе реальним часом, якщо він генерує переклад через кілька секунд після того, як хтось щось скаже.
Для субтитрів це може бути цілком прийнятним.
Але людська розмова набагато чутливіша до затримки.
Розглянемо два досвіди.
Досвід A: Каскадний переклад
Ви говорите.
Система чекає достатньо аудіо.
Ваше мовлення стає текстом.
Текст перекладається.
Перекладений текст надсилається генератору голосу.
Інший учасник чує переклад.
Потім вони відповідають.
Досвід B: Переклад мовлення в мовлення в реальному часі
Ви починаєте говорити.
Модель обробляє аудіопотік як частину безперервної сесії.
Вона розуміє поточну розмову та починає генерувати перекладене мовлення з істотно меншою залежністю від окремих етапів обробки.
Розмова стає ближче до природного чергування.
Обидві системи можуть технічно описуватися як «реальний час».
Але досвід може бути дуже різним.
Чому затримка важливіша за більшість еталонів перекладу
Продукти перекладу часто оцінюються за точністю.
Точність, очевидно, важлива.
Але під час живого спілкування є ще один однаково важливий вимір:
затримка розмови.
Уявіть ділову зустріч з шістьма людьми, які говорять кількома мовами.
Якщо кожне перекладене речення вводить кілька секунд тиші, ці затримки множаться протягом зустрічі.
Учасники починають переривати переклади.
Деякі люди починають говорити, перш ніж попередні переклади закінчилися.
Інші перестають брати участь, тому що слідкувати за розмовою стає важко.
Переклад сам по собі може бути правильним, а досвід зустрічі все ще поганий.
Для живого багатомовного спілкування якість перекладу тому не може вимірюватися лише тим, чи правильні слова.
Вона також повинна враховувати:
як швидко починається перекладене мовлення;
як природно учасники можуть чергуватися;
чи можна обробляти переривання;
чи система розуміє контекст розмови;
чи потребують користувачі чекати повних речень;
як добре розмова тече кількома мовами.
Ось чому технологія переклад мовлення в мовлення в реальному часі особливо важлива для зустрічей.
Мовлення містить більше, ніж слова
Ще одне обмеження перетворення мовлення на простий текст полягає в тому, що людське мовлення містить інформацію, яку важко повністю представити в транскрипції.
Люди спілкуються через:
тон;
ритм;
паузи;
наголос;
вагання;
швидкість мовлення;
контекст розмови.
Традиційні системи STT спочатку стискають усне повідомлення в текст.
Деяка інформація з оригінального аудіо може бути втрачена, перш ніж переклад навіть почнеться.
Сучасні моделі переклад мовлення в мовлення можуть працювати безпосередньо з аудіо та мають доступ до більшої частини оригінального сигналу мовлення.
Це не означає, що кожен нюанс завжди вижить переклад.
Але це створює можливість набагато більш природних голосових взаємодій, ніж системи, побудовані лише навколо тексту.
Переклад мовлення в мовлення проти переклад мовлення в текст
Ці технології іноді плутають, але вони вирішують різні проблеми.
Переклад мовлення в текст перетворює усне мовлення на перекладений текст.
Наприклад:
Японське мовлення → англійські субтитри
Це надзвичайно корисно для субтитрів та доступності.
Переклад мовлення в мовлення створює перекладене аудіо:
Японське мовлення → англійське мовлення
Це дозволяє слухачу слідкувати за розмовою без постійного читання субтитрів.
Voicli підтримує живі субтитри як частину досвіду зустрічі, але переклад голосу розроблений для чогось ширшого: дозволити людям насправді спілкуватися мовами, а не просто читати переклади того, що сказали інші.
Чому Voicli використовує переклад мовлення в мовлення в реальному часі
Voicli був побудований навколо простої ідеї:
Люди повинні мати можливість приєднатися до однієї зустрічі та говорити мовою, в якій вони найбільш комфортно.
Один учасник може говорити українською.
Інший може говорити японською.
Інший може віддати перевагу англійській.
Інший може говорити корейською.
Замість того, щоб змушувати всіх перейти на спільну другу мову, Voicli обробляє переклад під час розмови.
Кожен учасник може вибрати мову, яку він хоче чути.
Платформа може надати перекладений голос, субтитри або оригінальний аудіо залежно від переваги слухача.
Для живого голосового перекладу Voicli використовує архітектуру переклад мовлення в мовлення в реальному часі, а не покладається виключно на традиційний:
STT → переклад тексту → TTS
конвеєр для кожного вимовленого висловлювання.
Ця архітектурна різниця важлива, тому що Voicli намагається не побудувати інструмент транскрипції, який випадково вимовляє перекладений текст.
Мета — побудувати багатомовний комунікаційний шар для реальних розмов.
Коли STT + переклад + TTS все ще правильне рішення
Технологія переклад мовлення в мовлення не робить традиційні конвеєри застарілими.
Є багато ситуацій, коли STT → переклад → TTS корисна або навіть краща.
Наприклад:
Стенограми зустрічей потребують точного тексту.
Доступна для пошуку історія розмов вимагає текстового представлення.
Субтитри природно залежать від транскрипції.
Системи відповідності можуть потребувати зберігання точно того, що було розпізнано.
Асинхронний переклад не вимагає надзвичайно низької затримки.
Спеціалізовані робочі процеси можуть потребувати розробникам перевірити та змінити кожен проміжний етап.
Ось чому Voicli також використовує різні AI-технології залежно від завдання.
Ключ — вибрати правильну архітектуру для досвіду, який будується.
Для стенограми текст — це продукт.
Для живої багатомовної розмови сама розмова — це продукт.
Від інструментів перекладу до багатомовних розмов
Протягом десятиліть машинний переклад був в основному про перетворення інформації з однієї мови на іншу.
Спочатку документи.
Потім веб-сайти.
Потім повідомлення.
Потім субтитри.
Переклад мовлення в мовлення в реальному часі представляє інший напрямок.
Замість запитання:
«Як швидко ми можемо перекласти це речення?»
більш важливим питанням стає:
«Чи можуть дві людини, які говорять різними мовами, спілкуватися природно?»
Це змінює те, як потрібно розробляти системи перекладу.
Затримка стає критичною.
Чергування стає критичним.
Якість аудіо стає критичною.
Контекст стає критичним.
І переклад стає частиною комунікаційної інфраструктури, а не окремим інструментом, який люди свідомо використовують.
Майбутнє багатомовних зустрічей
Довгострокова мета переклад мовлення — не змусити людей частіше думати про технологію перекладу.
Це навпаки.
Переклад повинен поступово зникнути в розмові.
Ви говорите своєю мовою.
Інша людина говорить своєю.
І технологія обробляє те, що відбувається між вами.
Все ще будуть виклики.
Акценти, фоновий шум, спеціалізована термінологія, перекриваючі мовці, імена та культурний контекст можуть вплинути на переклад AI.
Але моделі багатомодальні в реальному часі змінюють те, що технічно можливо.
Ми рухаємося від:
запис → транскрипція → переклад → синтез → слухання
до:
мовлення → розуміння → переклад → слухання
І в кінцевому підсумку, найбільш успішна технологія перекладу може бути технологією, яку учасники навіть не помічають.
Переклад в реальному часі повинен відчуватися як спілкування
Називати продукт «реальним часом» легко.
Зробити багатомовне спілкування насправді відчуватися в реальному часі набагато складніше.
Різниця — це не просто мілісекунди на еталоні.
Це те, чи можуть люди говорити природно.
Чи можуть вони відповідати без очікування.
Чи багатомовна зустріч відчувається як розмова, а не послідовність перекладених повідомлень.
Це проблема, над якою працює Voicli.
Переклад мовлення в мовлення в реальному часі для розмов, де кожен може говорити своєю мовою.
Часто задавані питання
Що таке переклад мовлення в мовлення?
Переклад мовлення в мовлення перетворює усне мовлення безпосередньо на усний вихід іншою мовою. Сучасні AI-системи можуть обробляти аудіовхід та генерувати перекладене аудіо в межах сесії в реальному часі.
Яка різниця між переклад мовлення в мовлення та переклад мовлення в текст?
Переклад мовлення в текст створює перекладений письмовий текст, наприклад субтитри. Переклад мовлення в мовлення створює перекладене аудіо, яке слухач може чути.
Як працює традиційний голосовий переклад?
Традиційні системи зазвичай використовують три етапи: розпізнавання мовлення в текст, машинний переклад та синтез тексту в мовлення. Це часто називається каскадною архітектурою переклад мовлення.
Чому STT → переклад → TTS може мати вищу затримку?
Кожен етап повинен обробляти інформацію та передавати свій вихід наступному компоненту. Накопичений час обробки може вводити додаткову затримку, тоді як помилки з одного етапу також можуть вплинути на наступні етапи.
Чи переклад мовлення в мовлення те саме, що одночасний переклад?
Це пов'язані концепції, але не ідентичні. Людський одночасний переклад виконується професійними перекладачами. Переклад мовлення в мовлення AI намагається автоматично забезпечити подібний досвід багатомовного спілкування з низькою затримкою.
Чи можна використовувати переклад мовлення в мовлення для ділових зустрічей?
Так. Переклад мовлення в мовлення в реальному часі особливо корисний для міжнародних зустрічей, дзвінків клієнтів, розмов про продажі, віддалених команд, інтерв'ю та інших ситуацій, коли учасники не говорять однією мовою.
Що робить Voicli?
Voicli — це багатомовна платформа для відеозв'язку з переклад голосу в реальному часі та живими субтитрами. Учасники можуть говорити своїми бажаними мовами, а Voicli обробляє переклад під час розмови.
Спробуйте Voicli та говоріть своєю мовою. Нехай зустріч обробляє переклад.