Dịch Nói Thành Nói Theo Thời Gian Thực: Tại Sao Không Phải Tất Cả "Dịch Nói Theo Thời Gian Thực" Đều Giống Nhau
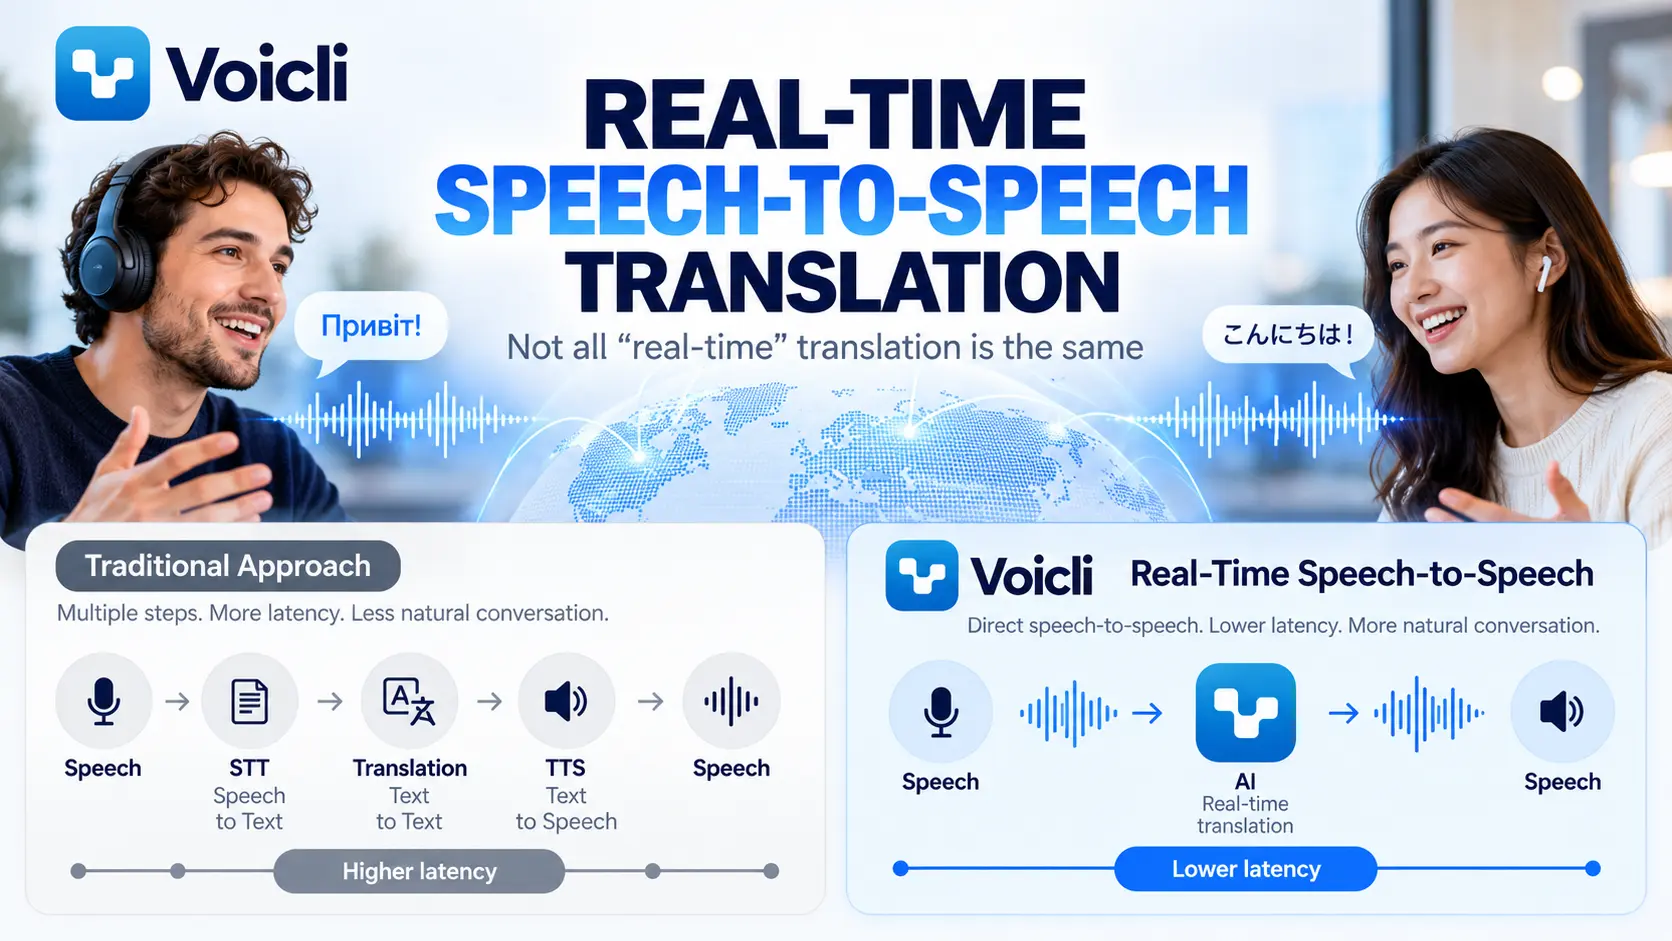
Dịch nói theo thời gian thực đang trở thành một tính năng phổ biến trong các nền tảng họp, công cụ giao tiếp và ứng dụng AI.
Nhưng có một chi tiết quan trọng thường bị ẩn đằng sau những từ "dịch theo thời gian thực."
Hai sản phẩm có thể cùng nói rằng chúng dịch nói theo thời gian thực nhưng sử dụng các công nghệ rất khác nhau bên dưới.
Một sản phẩm có thể xử lý cuộc trò chuyện như thế này:
Nói → chuyển đổi thành văn bản → dịch văn bản → chuyển đổi văn bản thành nói → âm thanh dịch
Một sản phẩm khác có thể xử lý tương tác như một trải nghiệm nói thành nói liên tục, nơi âm thanh được hiểu và dịch trực tiếp trong một mô hình đa phương thức theo thời gian thực.
Cả hai cách tiếp cận đều có thể tạo ra nói dịch.
Nhưng chúng không nhất thiết tạo ra cùng một trải nghiệm trò chuyện.
Tại Voicli, dịch nói trực tiếp của chúng tôi được thiết kế xung quanh dịch nói thành nói theo thời gian thực, cho phép những người tham gia nói tự nhiên bằng ngôn ngữ của riêng họ trong khi nói dịch được tạo ra cho những người đang nghe.
Vậy dịch nói thành nói chính xác là gì, và tại sao kiến trúc lại quan trọng?
Dịch Nói Thành Nói Theo Thời Gian Thực Là Gì?
Dịch nói thành nói (S2ST) là công nghệ nhận ngôn ngữ nói và tạo ra đầu ra nói bằng ngôn ngữ khác.
Trong một hệ thống trực tiếp, quá trình này xảy ra liên tục trong khi mọi người đang có cuộc trò chuyện.
Ví dụ:
Một người nói tiếng Ukraina.
Một người tham gia khác muốn nghe tiếng Anh.
Hệ thống lắng nghe nói tiếng Ukraina, hiểu ý nghĩa của nó, dịch nó và tạo ra âm thanh tiếng Anh cho người nghe.
Mục tiêu không đơn giản là dịch các từ.
Mục tiêu là làm cho giao tiếp giữa những người nói các ngôn ngữ khác nhau cảm thấy gần nhất có thể với một cuộc trò chuyện bình thường.
Sự phân biệt này trở nên quan trọng khi chúng ta so sánh các hệ thống nói thành nói hiện đại với các đường ống dịch nói truyền thống.
Cách Tiếp Cận Truyền Thống: STT → Dịch → TTS
Trong nhiều năm, các hệ thống dịch nói đã được xây dựng từ nhiều công nghệ riêng biệt.
Kiến trúc thường trông như thế này:
1. Chuyển Đổi Nói Thành Văn Bản (STT)
Âm thanh của người nói được chuyển đổi thành văn bản viết.
↓
2. Dịch Máy (MT)
Văn bản viết được dịch sang ngôn ngữ khác.
↓
3. Chuyển Đổi Văn Bản Thành Nói (TTS)
Văn bản dịch được chuyển đổi trở lại thành nói nhân tạo.
Đường ống hoàn chỉnh trở thành:
Âm thanh → STT → Văn bản → Dịch → Văn bản → TTS → Âm thanh
Kiến trúc này hoạt động.
Trên thực tế, nó đã cung cấp năng lượng cho nhiều hệ thống dịch nói trong nhiều năm.
Nó cũng hữu ích khi mục tiêu chính là chuyển đổi thành văn bản, phụ đề, ghi chú cuộc họp có thể tìm kiếm, hoặc các tình huống mà các nhà phát triển cần kiểm soát hoàn toàn từng giai đoạn xử lý.
Nhưng cuộc trò chuyện giữa con người trực tiếp giới thiệu một yêu cầu khác:
tốc độ.
Tại Sao Đường Ống Dịch Xếp Tầng Có Thể Cảm Thấy Chậm
Mỗi bước trong một đường ống dịch nói truyền thống mất thời gian.
Hệ thống nhận dạng nói cần đủ âm thanh để hiểu những gì đã được nói.
Sau đó, hệ thống dịch xử lý văn bản kết quả.
Sau đó, hệ thống chuyển đổi văn bản thành nói tạo ra một luồng âm thanh mới.
Mỗi thành phần riêng lẻ có thể nhanh.
Nhưng những độ trễ của chúng có thể tích lũy.
Có một vấn đề khác.
Mỗi giai đoạn phụ thuộc vào đầu ra của giai đoạn trước đó.
Nếu nhận dạng nói hiểu sai một từ, mô hình dịch nhận được văn bản sai.
Nếu bản dịch thay đổi ý nghĩa, hệ thống TTS chỉ nói văn bản dịch đó.
Nói cách khác, lỗi có thể lan truyền qua đường ống:
Lỗi nhận dạng nói → lỗi dịch → lỗi nói dịch
Trong quá trình dịch tài liệu, điều này có thể chấp nhận được.
Trong một cuộc trò chuyện trực tiếp, thậm chí một vài giây bổ sung hoặc một khoảng im lặng khó xử cũng có thể hoàn toàn thay đổi cách giao tiếp cảm thấy.
Mọi người ngừng nói tự nhiên.
Họ chờ đợi.
Họ kiểm tra xem bản dịch đã hoàn thành chưa.
Sau đó, người kia phản hồi.
Thay vì một cuộc trò chuyện, giao tiếp bắt đầu cảm thấy như lần lượt với một máy.
Nói Thành Nói Theo Thời Gian Thực Gốc Thay Đổi Kiến Trúc
Các mô hình AI đa phương thức hiện đại có thể làm việc với đầu vào âm thanh và đầu ra âm thanh trong cùng một tương tác theo thời gian thực.
Thay vì yêu cầu các nhà phát triển kết nối ba hệ thống độc lập cho mỗi cụm từ nói, một mô hình theo thời gian thực có thể liên tục xử lý âm thanh đến và tạo ra đầu ra nói.
Từ quan điểm của người dùng, luồng trở nên gần hơn nhiều với:
Nói → Hiểu và dịch AI → Nói
Điều này thường được gọi là dịch nói thành nói theo thời gian thực.
Sự phân biệt quan trọng không phải là văn bản không bao giờ có thể tồn tại ở bất kỳ đâu bên trong một mô hình AI.
Các mô hình hiện đại có thể sử dụng nhiều biểu diễn nội bộ.
Sự khác biệt là kiến trúc:
Cuộc trò chuyện trực tiếp không phải chờ một dịch vụ chuyển đổi thành văn bản riêng biệt, sau đó là một dịch vụ dịch văn bản riêng biệt, và sau đó là một dịch vụ tổng hợp nói riêng biệt trước khi âm thanh dịch có thể bắt đầu.
Điều đó làm cho một loại tương tác rất khác có thể xảy ra.
"Theo Thời Gian Thực" Không Phải Lúc Nào Cũng Có Nghĩa Giống Nhau
Thuật ngữ dịch theo thời gian thực được sử dụng rộng rãi trên toàn ngành.
Một sản phẩm có thể kỹ thuật gọi chính nó là theo thời gian thực nếu nó tạo ra một bản dịch vài giây sau khi ai đó nói.
Đối với phụ đề, điều đó có thể hoàn toàn chấp nhận được.
Nhưng cuộc trò chuyện giữa con người nhạy cảm hơn nhiều với độ trễ.
Hãy xem xét hai trải nghiệm.
Trải Nghiệm A: Dịch Xếp Tầng
Bạn nói.
Hệ thống chờ đủ âm thanh.
Nói của bạn trở thành văn bản.
Văn bản được dịch.
Văn bản dịch được gửi đến một trình tạo giọng nói.
Người tham gia khác nghe bản dịch.
Sau đó họ phản hồi.
Trải Nghiệm B: Nói Thành Nói Theo Thời Gian Thực
Bạn bắt đầu nói.
Mô hình xử lý luồng âm thanh như một phần của một phiên liên tục.
Nó hiểu cuộc trò chuyện đang diễn ra và bắt đầu tạo ra nói dịch với sự phụ thuộc đáng kể ít hơn vào các giai đoạn xử lý riêng biệt.
Cuộc trò chuyện trở nên gần hơn với lần lượt tự nhiên.
Cả hai hệ thống có thể được mô tả kỹ thuật là "theo thời gian thực."
Nhưng trải nghiệm có thể rất khác nhau.
Tại Sao Độ Trễ Quan Trọng Hơn Hầu Hết Các Tiêu Chuẩn Dịch
Các sản phẩm dịch thường được đánh giá bằng độ chính xác.
Độ chính xác rõ ràng là quan trọng.
Nhưng trong quá trình giao tiếp trực tiếp, có một chiều khác cũng quan trọng ngang nhau:
độ trễ cuộc trò chuyện.
Hãy tưởng tượng một cuộc họp kinh doanh với sáu người nói nhiều ngôn ngữ.
Nếu mỗi câu dịch giới thiệu vài giây im lặng, những độ trễ đó sẽ nhân lên trên toàn bộ cuộc họp.
Những người tham gia bắt đầu gián đoạn các bản dịch.
Một số người bắt đầu nói trước khi các bản dịch trước đó hoàn thành.
Những người khác ngừng tham gia vì theo dõi cuộc trò chuyện trở nên khó khăn.
Bản dịch chính nó có thể chính xác trong khi trải nghiệm cuộc họp vẫn còn kém.
Đối với giao tiếp đa ngôn ngữ trực tiếp, chất lượng dịch do đó không thể được đo lường chỉ bằng cách liệu các từ có chính xác hay không.
Nó cũng nên xem xét:
nói dịch bắt đầu nhanh như thế nào;
những người tham gia có thể lần lượt tự nhiên như thế nào;
liệu những gián đoạn có thể được xử lý;
liệu hệ thống có hiểu bối cảnh cuộc trò chuyện;
liệu người dùng có cần chờ các câu hoàn chỉnh;
cuộc trò chuyện chảy tốt như thế nào trên nhiều ngôn ngữ.
Đây là lý do tại sao công nghệ nói thành nói theo thời gian thực đặc biệt quan trọng đối với các cuộc họp.
Nói Chứa Nhiều Hơn Các Từ
Một hạn chế khác của việc chuyển đổi nói thành văn bản thuần túy là nói của con người chứa thông tin khó biểu diễn hoàn toàn trong một bản ghi chép.
Mọi người giao tiếp thông qua:
tông giọng;
nhịp điệu;
tạm dừng;
nhấn mạnh;
do dự;
tốc độ nói;
bối cảnh cuộc trò chuyện.
Các hệ thống STT truyền thống trước tiên nén thông điệp nói thành văn bản.
Một số thông tin từ âm thanh gốc do đó có thể bị mất trước khi dịch thậm chí bắt đầu.
Các mô hình nói thành nói hiện đại có thể làm việc trực tiếp với âm thanh và có quyền truy cập vào nhiều tín hiệu nói gốc hơn.
Điều này không có nghĩa là mọi sắc thái sẽ luôn sống sót dịch.
Nhưng nó tạo ra khả năng tương tác giọng nói tự nhiên hơn nhiều so với các hệ thống được xây dựng chỉ xung quanh văn bản.
Nói Thành Nói So Với Nói Thành Văn Bản Dịch
Những công nghệ này đôi khi bị nhầm lẫn, nhưng chúng giải quyết các vấn đề khác nhau.
Dịch nói thành văn bản chuyển đổi ngôn ngữ nói thành văn bản dịch.
Ví dụ:
Nói tiếng Nhật → Phụ đề tiếng Anh
Điều này cực kỳ hữu ích cho chú thích và khả năng tiếp cận.
Dịch nói thành nói tạo ra âm thanh dịch:
Nói tiếng Nhật → Nói tiếng Anh
Điều này cho phép người nghe theo dõi cuộc trò chuyện mà không cần liên tục đọc phụ đề.
Voicli hỗ trợ phụ đề trực tiếp như một phần của trải nghiệm cuộc họp, nhưng dịch nói được thiết kế cho một cái gì đó rộng hơn: cho phép mọi người thực sự nói qua các ngôn ngữ, thay vì chỉ đơn giản là đọc các bản dịch những gì người khác nói.
Tại Sao Voicli Sử Dụng Dịch Nói Thành Nói Theo Thời Gian Thực
Voicli được xây dựng xung quanh một ý tưởng đơn giản:
Mọi người nên có thể tham gia cùng một cuộc họp và nói ngôn ngữ mà họ cảm thấy thoải mái nhất.
Một người tham gia có thể nói tiếng Ukraina.
Một người khác có thể nói tiếng Nhật.
Một người khác có thể thích tiếng Anh.
Một người khác có thể nói tiếng Hàn.
Thay vì buộc mọi người chuyển sang một ngôn ngữ thứ hai chung, Voicli xử lý dịch trong cuộc trò chuyện.
Mỗi người tham gia có thể chọn ngôn ngữ họ muốn nghe.
Nền tảng có thể cung cấp nói dịch, phụ đề hoặc âm thanh gốc tùy thuộc vào sở thích của người nghe.
Đối với dịch nói trực tiếp, Voicli sử dụng kiến trúc nói thành nói theo thời gian thực thay vì dựa độc quyền vào truyền thống:
STT → dịch văn bản → TTS
đường ống cho mỗi phát biểu dịch.
Sự khác biệt kiến trúc đó là quan trọng vì Voicli không cố gắng xây dựng một công cụ chuyển đổi thành văn bản mà tình cờ nói văn bản dịch.
Mục tiêu là xây dựng một lớp giao tiếp đa ngôn ngữ cho các cuộc trò chuyện thực.
Khi STT + Dịch + TTS Vẫn Là Giải Pháp Đúng
Công nghệ nói thành nói không làm cho các đường ống truyền thống lỗi thời.
Có nhiều tình huống mà STT → dịch → TTS hữu ích hoặc thậm chí được ưa thích.
Ví dụ:
Bản ghi chép cuộc họp cần văn bản chính xác.
Lịch sử cuộc trò chuyện có thể tìm kiếm yêu cầu biểu diễn văn bản.
Phụ đề tự nhiên phụ thuộc vào chuyển đổi thành văn bản.
Các hệ thống tuân thủ có thể cần lưu trữ chính xác những gì đã được nhận dạng.
Dịch không đồng bộ không yêu cầu độ trễ cực kỳ thấp.
Quy trình làm việc chuyên biệt có thể cần các nhà phát triển kiểm tra và sửa đổi từng giai đoạn trung gian.
Đó là lý do tại sao Voicli cũng sử dụng các công nghệ AI khác nhau tùy thuộc vào nhiệm vụ.
Chìa khóa là chọn kiến trúc chính xác cho trải nghiệm đang được xây dựng.
Đối với một bản ghi chép, văn bản là sản phẩm.
Đối với một cuộc trò chuyện đa ngôn ngữ trực tiếp, cuộc trò chuyện chính nó là sản phẩm.
Từ Công Cụ Dịch Đến Cuộc Trò Chuyện Đa Ngôn Ngữ
Trong nhiều thập kỷ, dịch máy chủ yếu là về chuyển đổi thông tin từ một ngôn ngữ sang ngôn ngữ khác.
Trước tiên là tài liệu.
Sau đó là trang web.
Sau đó là tin nhắn.
Sau đó là phụ đề.
Dịch nói thành nói theo thời gian thực đại diện cho một hướng khác.
Thay vì hỏi:
"Chúng ta có thể dịch câu này nhanh như thế nào?"
câu hỏi quan trọng hơn trở thành:
"Hai người nói các ngôn ngữ khác nhau có thể giao tiếp tự nhiên không?"
Điều đó thay đổi cách các hệ thống dịch cần được thiết kế.
Độ trễ trở nên quan trọng.
Lần lượt trở nên quan trọng.
Chất lượng âm thanh trở nên quan trọng.
Bối cảnh trở nên quan trọng.
Và dịch trở thành một phần của cơ sở hạ tầng giao tiếp thay vì một công cụ riêng biệt mà mọi người có ý thức sử dụng.
Tương Lai Của Các Cuộc Họp Đa Ngôn Ngữ
Mục tiêu dài hạn của dịch nói không phải là làm cho mọi người suy nghĩ về công nghệ dịch thường xuyên hơn.
Nó là ngược lại.
Dịch nên dần dần biến mất vào cuộc trò chuyện.
Bạn nói ngôn ngữ của bạn.
Người kia nói của họ.
Và công nghệ xử lý những gì xảy ra giữa bạn.
Sẽ vẫn còn những thách thức.
Giọng nói, tiếng ồn nền, thuật ngữ cụ thể lĩnh vực, những người nói chồng chéo, tên và bối cảnh văn hóa đều có thể ảnh hưởng đến dịch AI.
Nhưng các mô hình đa phương thức theo thời gian thực đang thay đổi những gì có thể kỹ thuật.
Chúng tôi đang chuyển từ:
ghi âm → chuyển đổi thành văn bản → dịch → tổng hợp → nghe
hướng tới:
nói → hiểu → dịch → nghe
Và cuối cùng, công nghệ dịch thành công nhất có thể là công nghệ mà những người tham gia hầu như không nhận thấy.
Dịch Theo Thời Gian Thực Nên Cảm Thấy Như Giao Tiếp
Gọi một sản phẩm là "theo thời gian thực" rất dễ.
Làm cho giao tiếp đa ngôn ngữ thực sự cảm thấy theo thời gian thực khó hơn nhiều.
Sự khác biệt không chỉ là mili giây trên một tiêu chuẩn.
Nó là liệu mọi người có thể nói tự nhiên hay không.
Liệu họ có thể phản hồi mà không cần chờ đợi.
Liệu một cuộc họp đa ngôn ngữ cảm thấy như một cuộc trò chuyện thay vì một chuỗi các tin nhắn dịch.
Đó là vấn đề Voicli đang giải quyết.
Dịch nói thành nói theo thời gian thực cho các cuộc trò chuyện nơi mọi người có thể nói ngôn ngữ của riêng họ.
Các Câu Hỏi Thường Gặp
Dịch nói thành nói là gì?
Dịch nói thành nói chuyển đổi ngôn ngữ nói trực tiếp thành đầu ra nói bằng ngôn ngữ khác. Các hệ thống AI hiện đại có thể xử lý đầu vào âm thanh và tạo ra âm thanh dịch trong một phiên theo thời gian thực.
Sự khác biệt giữa dịch nói thành nói và dịch nói thành văn bản là gì?
Dịch nói thành văn bản tạo ra văn bản dịch viết, chẳng hạn như phụ đề. Dịch nói thành nói tạo ra âm thanh dịch mà người nghe có thể nghe.
Dịch nói truyền thống hoạt động như thế nào?
Các hệ thống truyền thống thường sử dụng ba giai đoạn: nhận dạng nói thành văn bản, dịch máy và tổng hợp văn bản thành nói. Điều này thường được gọi là kiến trúc dịch nói xếp tầng.
Tại sao STT → dịch → TTS có thể có độ trễ cao hơn?
Mỗi giai đoạn phải xử lý thông tin và chuyển đầu ra của nó cho thành phần tiếp theo. Thời gian xử lý tích lũy có thể giới thiệu độ trễ bổ sung, trong khi lỗi từ một giai đoạn cũng có thể ảnh hưởng đến các giai đoạn tiếp theo.
Dịch nói thành nói có giống như phiên dịch đồng thời không?
Chúng là các khái niệm liên quan nhưng không giống hệt nhau. Phiên dịch đồng thời của con người được thực hiện bởi các phiên dịch viên chuyên nghiệp. Dịch nói thành nói AI cố gắng cung cấp một trải nghiệm giao tiếp đa ngôn ngữ độ trễ thấp tương tự tự động.
Dịch nói thành nói có thể được sử dụng cho các cuộc họp kinh doanh không?
Có. Dịch nói thành nói theo thời gian thực đặc biệt hữu ích cho các cuộc họp quốc tế, cuộc gọi khách hàng, cuộc trò chuyện bán hàng, các nhóm từ xa, phỏng vấn và các tình huống khác mà những người tham gia không chia sẻ cùng một ngôn ngữ.
Voicli làm gì?
Voicli là một nền tảng giao tiếp video đa ngôn ngữ với dịch nói theo thời gian thực và phụ đề trực tiếp. Những người tham gia có thể nói các ngôn ngữ ưa thích của họ trong khi Voicli xử lý dịch trong cuộc trò chuyện.
Hãy thử Voicli và nói ngôn ngữ của bạn. Hãy để cuộc họp xử lý bản dịch.