实时语音转语音翻译:为什么并非所有"实时"语音翻译都是一样的
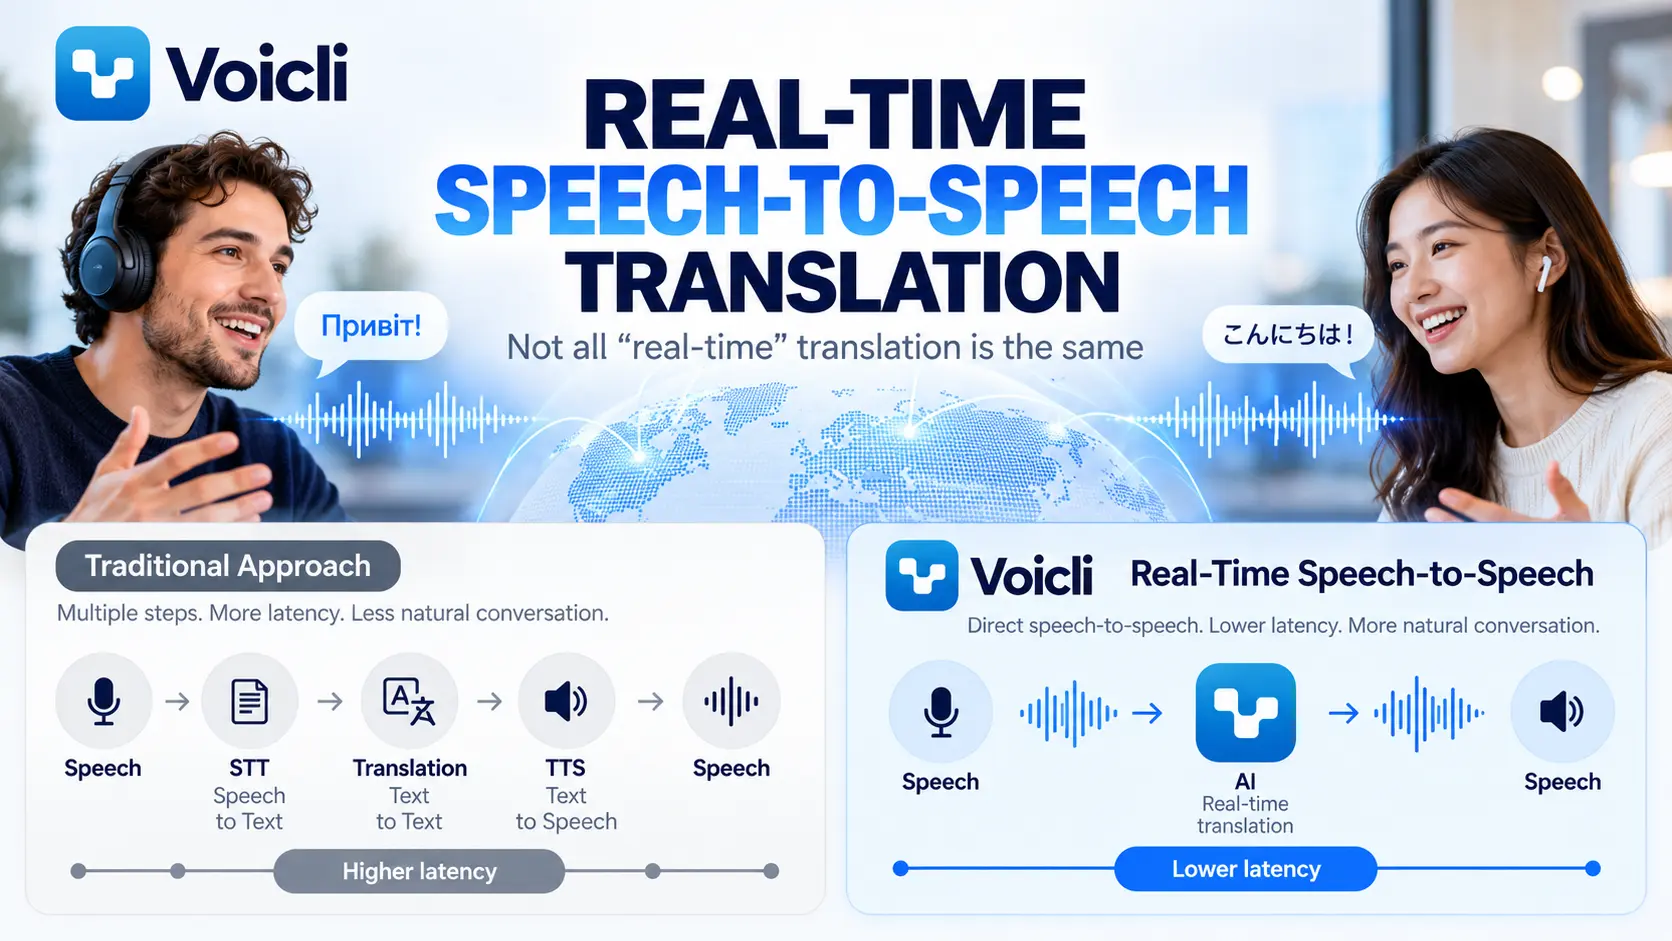
实时语音翻译正在成为会议平台、通信工具和人工智能应用中的常见功能。
但有一个重要的细节经常被隐藏在"实时翻译"这个词后面。
两个产品可能都声称能够实时翻译语音,但底层使用的技术却大不相同。
一个可能这样处理对话:
语音→转录→文本翻译→文本转语音→翻译后的音频
另一个可以将交互处理为连续的语音转语音体验,其中音频在实时多模态模型中被直接理解和翻译。
两种方法都可以产生翻译后的语音。
但它们不一定能创造相同的对话体验。
在Voicli,我们的实时语音翻译是围绕实时语音转语音翻译设计的,允许参与者用自己的语言自然地说话,同时为听众生成翻译后的语音。
那么,语音转语音翻译究竟是什么,为什么架构很重要呢?
什么是实时语音转语音翻译?
语音转语音翻译(S2ST)是一种接收口语并用另一种语言产生口语输出的技术。
在实时系统中,这个过程在人们进行对话时持续进行。
例如:
一个人说乌克兰语。
另一个参与者想听英语。
系统听到乌克兰语语音,理解其含义,翻译它,并为听众生成英语音频。
目标不仅仅是翻译词语。
目标是让说不同语言的人之间的交流尽可能接近正常对话。
当我们将现代语音转语音系统与传统语音翻译管道进行比较时,这种区别变得很重要。
传统方法:语音识别→翻译→文本转语音
多年来,语音翻译系统一直由几种独立的技术构建而成。
架构通常如下所示:
1. 语音转文本(STT)
说话者的音频被转换为书面文本。
↓
2. 机器翻译(MT)
书面文本被翻译成另一种语言。
↓
3. 文本转语音(TTS)
翻译后的文本被转换回人工语音。
完整的管道变成:
音频→语音识别→文本→翻译→文本→文本转语音→音频
这种架构是有效的。
实际上,它多年来为许多语音翻译系统提供了动力。
当主要目标是转录、字幕、可搜索的会议记录,或开发人员需要完全控制每个处理阶段的情况时,它也很有用。
但实时人类对话引入了另一个要求:
速度。
为什么级联翻译管道可能感觉很慢
传统语音翻译管道中的每一步都需要时间。
语音识别系统需要足够的音频来理解所说的内容。
然后翻译系统处理生成的文本。
然后文本转语音系统生成新的音频流。
每个单独的组件可能都很快。
但它们的延迟可能会累积。
还有另一个问题。
每个阶段都依赖于前一个阶段的输出。
如果语音识别误解了一个词,翻译模型会收到错误的文本。
如果翻译改变了含义,文本转语音系统只会说出那个翻译后的文本。
换句话说,错误可能会在管道中传播:
语音识别错误→翻译错误→口语翻译错误
在文档翻译期间,这可能是可以接受的。
在实时对话中,即使只是几秒钟的额外延迟或尴尬的停顿也会完全改变交流的感觉。
人们停止自然说话。
他们等待。
他们检查翻译是否已完成。
然后另一个人回应。
交流不再是对话,而开始感觉像是与机器轮流交互。
原生实时语音转语音改变了架构
现代多模态人工智能模型可以在同一实时交互中处理音频输入和音频输出。
与其要求开发人员为每个口语短语连接三个独立的系统,实时模型可以持续处理传入的音频并生成口语输出。
从用户的角度来看,流程变得更接近:
语音→人工智能理解和翻译→语音
这通常被称为实时语音转语音翻译。
重要的区别不是文本永远不能存在于人工智能模型内的任何地方。
现代模型可能使用许多内部表示。
区别在于架构:
实时对话不必等待单独的转录服务,然后等待单独的文本翻译服务,再等待单独的语音合成服务,才能开始翻译后的音频。
这使得一种非常不同的交互成为可能。
"实时"并不总是意味着同样的事情
实时翻译这个术语在整个行业中被广泛使用。
如果产品在某人说话后几秒钟生成翻译,它在技术上可以称自己为实时。
对于字幕,这可能是完全可以接受的。
但人类对话对延迟的敏感性要高得多。
考虑两种体验。
体验A:级联翻译
你说话。
系统等待足够的音频。
你的语音变成文本。
文本被翻译。
翻译后的文本被发送到语音生成器。
另一个参与者听到翻译。
然后他们回应。
体验B:实时语音转语音
你开始说话。
模型将音频流作为连续会话的一部分进行处理。
它理解正在进行的对话,并开始生成翻译后的语音,对单独处理阶段的依赖性大大降低。
对话变得更接近自然的轮流交互。
两个系统在技术上都可以被描述为"实时"。
但体验可能非常不同。
为什么延迟比大多数翻译基准更重要
翻译产品通常按准确性进行评估。
准确性显然很重要。
但在实时交流中,还有另一个同样重要的维度:
对话延迟。
想象一个有六个人说多种语言的商务会议。
如果每个翻译的句子都引入几秒钟的沉默,这些延迟会在整个会议中倍增。
参与者开始打断翻译。
有些人在之前的翻译完成之前就开始说话。
其他人停止参与,因为跟上对话变得困难。
翻译本身可能是正确的,但会议体验仍然很差。
对于实时多语言交流,翻译质量因此不能仅通过词语是否正确来衡量。
它还应该考虑:
翻译后的语音开始的速度有多快;
参与者能多自然地轮流说话;
是否可以处理打断;
系统是否理解对话背景;
用户是否需要等待完整的句子;
对话在多种语言中的流畅程度如何。
这就是为什么实时语音转语音技术对会议特别重要。
语音包含的不仅仅是词语
将语音转换为纯文本的另一个限制是,人类语音包含难以在转录中完全表示的信息。
人们通过以下方式交流:
语调;
节奏;
停顿;
强调;
犹豫;
说话速度;
对话背景。
传统的语音转文本系统首先将口语信息压缩为文本。
因此,原始音频中的某些信息可能在翻译开始之前就丢失了。
现代语音转语音模型可以直接处理音频,并可以访问更多原始语音信号。
这并不意味着每个细微差别都会在翻译中幸存。
但它创造了比仅围绕文本构建的系统更自然的语音交互的可能性。
语音转语音与语音转文本翻译
这些技术有时会被混淆,但它们解决不同的问题。
语音转文本翻译将口语转换为翻译后的文本。
例如:
日语语音→英文字幕
这对于字幕和无障碍访问非常有用。
语音转语音翻译产生翻译后的音频:
日语语音→英语语音
这允许听众跟上对话,而无需不断阅读字幕。
Voicli支持实时字幕作为会议体验的一部分,但语音翻译的设计目的更广泛:允许人们实际跨语言交谈,而不仅仅是阅读他人所说内容的翻译。
为什么Voicli使用实时语音转语音翻译
Voicli是围绕一个简单的想法构建的:
人们应该能够加入同一个会议,并用他们最舒适的语言说话。
一个参与者可能说乌克兰语。
另一个可能说日语。
另一个可能更喜欢英语。
另一个可能说韩语。
与其强迫每个人都切换到一种共同的第二语言,Voicli在对话中处理翻译。
每个参与者可以选择他们想听的语言。
该平台可以根据听众的偏好提供翻译后的语音、字幕或原始音频。
对于实时语音翻译,Voicli使用实时语音转语音架构,而不是仅依赖传统的:
语音识别→文本翻译→文本转语音
管道来处理每个翻译的话语。
这种架构差异很重要,因为Voicli不是在尝试构建一个碰巧说翻译文本的转录工具。
目标是构建一个用于真实对话的多语言通信层。
何时语音识别+翻译+文本转语音仍然是正确的解决方案
语音转语音技术并不会使传统管道过时。
在许多情况下,语音识别→翻译→文本转语音是有用的,甚至是更好的选择。
例如:
会议记录需要准确的文本。
可搜索的对话历史需要文本表示。
字幕自然依赖于转录。
合规系统可能需要存储确切识别的内容。
异步翻译不需要极低的延迟。
专门的工作流可能需要开发人员检查和修改每个中间阶段。
这就是为什么Voicli也根据任务使用不同的人工智能技术。
关键是为正在构建的体验选择正确的架构。
对于转录,文本是产品。
对于实时多语言对话,对话本身就是产品。
从翻译工具到多语言对话
几十年来,机器翻译主要是关于将信息从一种语言转换为另一种语言。
首先是文档。
然后是网站。
然后是消息。
然后是字幕。
实时语音转语音翻译代表了一个不同的方向。
与其问:
"我们能多快翻译这个句子?"
更重要的问题变成:
"说不同语言的两个人能自然地交流吗?"
这改变了翻译系统需要如何设计。
延迟变得至关重要。
轮流交互变得至关重要。
音频质量变得至关重要。
背景变得至关重要。
翻译变成通信基础设施的一部分,而不是人们有意识地使用的单独工具。
多语言会议的未来
语音翻译的长期目标不是让人们更频繁地思考翻译技术。
恰恰相反。
翻译应该逐渐消失在对话中。
你说你的语言。
另一个人说他们的语言。
技术处理你们之间发生的事情。
仍然会有挑战。
口音、背景噪音、特定领域的术语、重叠的说话者、名字和文化背景都可能影响人工智能翻译。
但实时多模态模型正在改变技术上可能的事情。
我们正在从:
录制→转录→翻译→合成→听
转向:
说话→理解→翻译→听
最终,最成功的翻译技术可能是参与者几乎注意不到的技术。
实时翻译应该感觉像交流
称产品为"实时"很容易。
让多语言交流实际上感觉像实时要困难得多。
区别不仅仅是基准上的毫秒。
它是人们是否能自然地说话。
他们是否能在不等待的情况下回应。
多语言会议是否感觉像对话而不是一系列翻译消息。
这是Voicli正在解决的问题。
常见问题
什么是语音转语音翻译?
语音转语音翻译将口语直接转换为另一种语言的口语输出。现代人工智能系统可以在实时会话中处理音频输入并生成翻译后的音频。
语音转语音翻译和语音转文本翻译有什么区别?
语音转文本翻译产生翻译后的书面文本,例如字幕。语音转语音翻译产生听众可以听到的翻译后的音频。
传统语音翻译如何工作?
传统系统通常使用三个阶段:语音转文本识别、机器翻译和文本转语音合成。这通常被称为级联语音翻译架构。
为什么语音识别→翻译→文本转语音可能有更高的延迟?
每个阶段必须处理信息并将其输出传递给下一个组件。累积的处理时间可能会引入额外的延迟,而一个阶段的错误也可能影响后续阶段。
语音转语音翻译与同声传译相同吗?
它们是相关的概念,但不完全相同。人类同声传译由专业口译员执行。人工智能语音转语音翻译试图自动提供类似的低延迟多语言交流体验。
语音转语音翻译可以用于商务会议吗?
可以。实时语音转语音翻译特别适用于国际会议、客户通话、销售对话、远程团队、采访和其他参与者不共享同一语言的情况。
Voicli做什么?
Voicli是一个具有实时语音翻译和实时字幕的多语言视频通信平台。参与者可以说他们首选的语言,而Voicli在对话中处理翻译。
尝试Voicli,说你的语言。让会议处理翻译。